

Python原始字符串与Unicode字符串操作符用法实例分析

发布时间:2026-10-13| 1人浏览过
本文深入解析Python中原始字符串(r/R)与Unicode字符串(u/U)操作符的具体用法。通过代码实例演示了原始字符串在避免转义字符干扰及处理文件路径时的优势,以及Unicode操作符对标准字符串和原始Unicode字符串的转换机制。文章提供了相关在线编码转换工具链接,并附带完整可运行代码,帮助开发者掌握字符串处理技巧。
本文通过具体实例详细讲解Python中原始字符串与Unicode字符串操作符的应用方法,旨在为读者提供实用的参考代码与技巧。
#coding=utf8
'''''
在原始字符串里,所有的字符串都是直接按照字面的意思来使用,
没有转义特殊或不能打印的字符。
正则表达式是一些告诫搜索匹配方式的字符串,
通过是由代表字符、分组、匹配信息、变量名、字符类等的特殊符号组成。
在原始字符串紧靠第一个引号前,需要加上r或R字母,来表示该字符是原始字符串。
原始字符串和普通字符串有这几乎完全相同的语法。
Unicode字符串操作符,大写的U和小写的u是在Python1.6中和Unicode字符串一起被引入的。
它用来把标准字符串或者包含Unicode字符的字符串转换成完全的Unicode字符串对象。
字符串方法和正则表达式引擎也支持Unicode。
Unicode操作符也可以接受原始Unicode字符串,只要将Unicode操作符和原始字符串操作符连接在一起。
注意:Unicode操作符必须出现在原始字符串操作符前面。
'''
import re
#原始操作符函数
def originalOper():
  #不是原始字符表示换行符
  print "\n"
  #是原始字符表示\n
  print r"\n"
  try:
    #对文件路径加r,不需要对\进行转义
    #文件路径中表示斜线
    testFile=open(r"E:\PythonDemo\CorePythonBook2\output","r")
    for line in testFile.readlines():
      #通过格式化字符串
      #优先使用repr()函数转换为原始字符
      line="%r" %line
      #对匹配模式进行加r处理
      #匹配的字符转换为原始字符
      m=re.search(r"\\[rn]",line)
      #字符串中是否包含匹配字符
      #如果包含输出该字符串
      if m is not None:
        print line
  except Exception,e:
    print e
  finally:
    testFile.close()
#Unicode操作符函数
def  unicodeOper():
  print u"abc"
  print u"\u1234"
  print u"abc\u1234\n"
  print ur"Hello\nWorld!"
#调用函数
#输出操作原始字符结果
originalOper()
#输出Unicode字符串
unicodeOper()
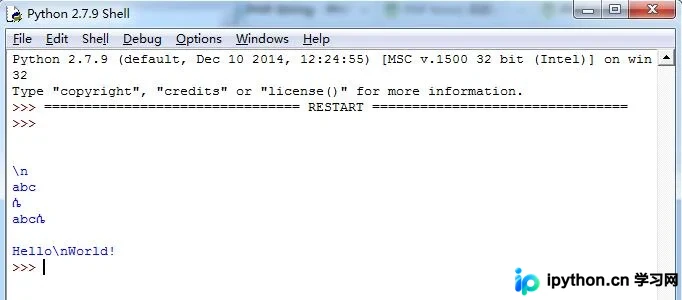
执行上述代码后的输出结果如下所示:
此外,为方便读者进行编码转换操作,以下推荐几款常用的Unicode编码转换工具供参考:
在线Unicode与中文互转工具: http://tools.jb51.net/transcoding/unicode_chinese
Native与Unicode在线编码转换工具: http://tools.jb51.net/transcoding/native2unicode
在线中文汉字、ASCII码与Unicode编码互转工具: http://tools.jb51.net/transcoding/chinese2unicode
若需进一步了解Python相关技术,建议查阅本站系列专题,包括《Python编码操作技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》以及《Python文件与目录操作技巧汇总》。
期望本文提供的关于Python程序设计的知识能对大家的学习与开发工作有所助益。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









