

Python中re.search、re.match与str.find的区别及适用场景
深入解析Python中re.search、re.match与str.find的核心机制、匹配范围、返回结构与性能差异,结合清晰代码示例与流程决策图,提供明确的选型与避坑指导。
2026-10-10
6

深入解析Python中re.search、re.match与str.find的核心机制、匹配范围、返回结构与性能差异,结合清晰代码示例与流程决策图,提供明确的选型与避坑指导。
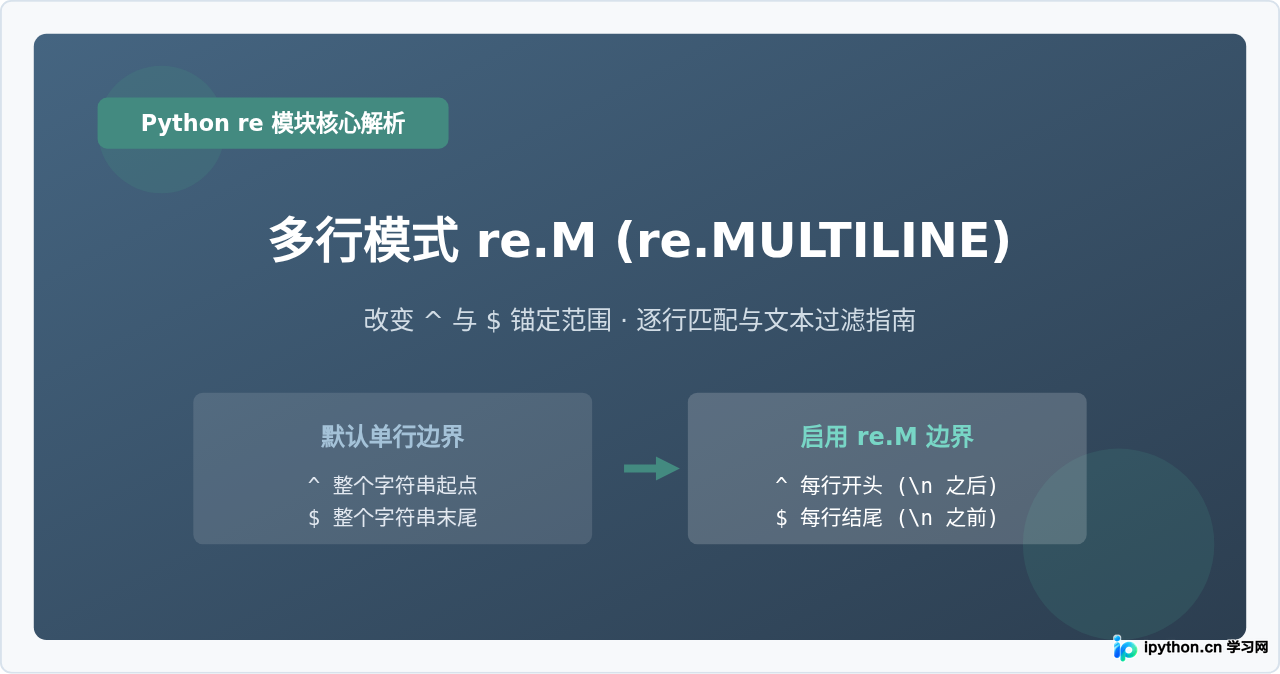
深入讲解Python正则表达式中多行模式re.M (re.MULTILINE) 的作用机制、使用方法与实战场景,对比默认模式与多行模式下^和$的行为差异,助你高效处理多行文本。
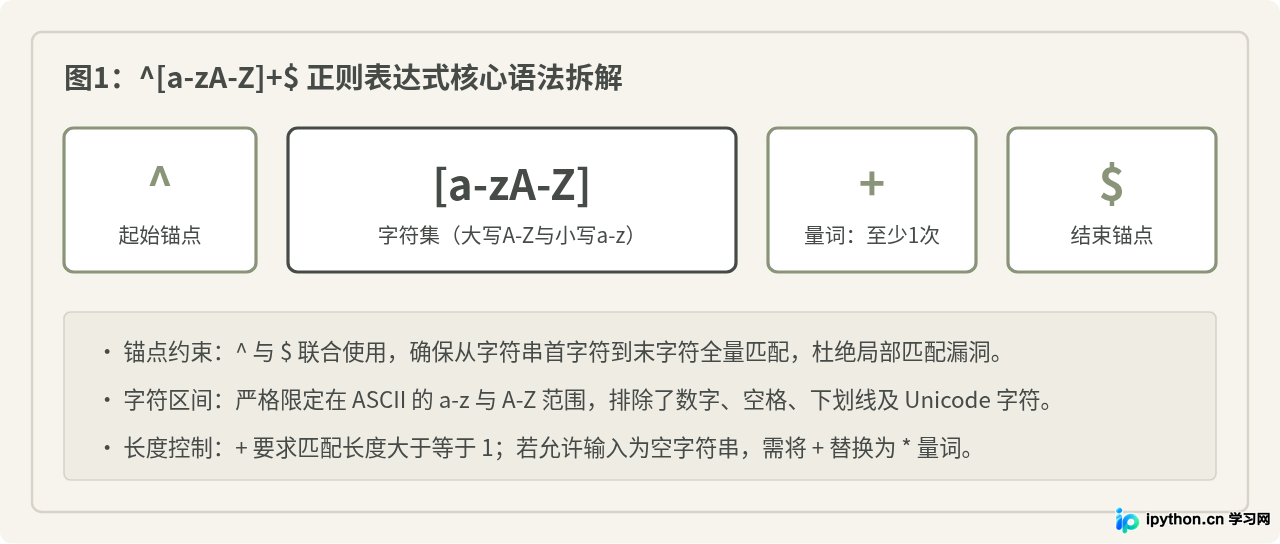
本文介绍在Python中使用正则表达式精确匹配纯字母输入的实现方法,深入剖析正则表达式语法结构、re模块核心函数应用流程及常见误区避坑指南。
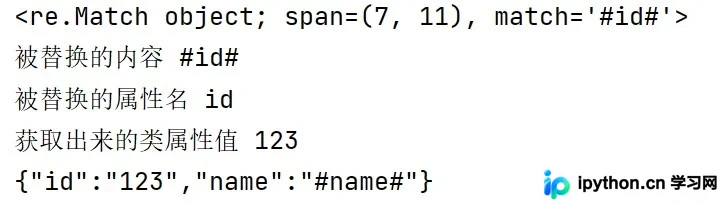
本文详解如何使用Python正则表达式定位字符串中的特定格式占位符,并结合getattr函数动态获取对象属性值进行替换。通过解析基本语法规则与分步代码演示,提供单参数精确替换与多参数循环替换的实用方案,有效解决自动化测试用例生成与数据模板填充问题。
在数据清洗与自然语言处理任务中,文本内的表情符号常引发编码或分词异常。本文详细介绍使用Python清理Emoji的四种方法,涵盖正则匹配、标准库过滤、第三方库处理及特殊符号剥离,提供完整代码示例、适用场景对比与生产环境配置建议。
本文系统介绍 Python 中字符串查找与替换的核心方法。涵盖基础的 find 与 replace 操作、基于 re 模块的正则表达式精准匹配、利用 fuzzywuzzy 处理相似度文本,以及针对海量数据的逐行读取优化策略。结合日志分析实战场景,提供可直接运行的代码模板与性能调优建议。
本文系统讲解Python正则表达式中的四大类元字符,涵盖字符匹配、数量限定、位置锚定与逻辑分组。结合贪婪与非贪婪模式、转义机制及分组捕获原理,详解手机号验证、域名提取与文本去重等实战场景,提供高效构建正则表达式的完整思路。
本文详解 Python re 模块核心用法,涵盖基础元字符到复杂文本替换。通过 match、search、findall 实现精准提取,利用 sub 结合分组与回调完成批量修改。提供日志解析、数据脱敏场景代码及 compile 性能优化方案,助开发者高效处理非结构化文本。
本文详细说明在 Python 中检测字符串是否包含特殊字符的两种常用实现方式,并演示如何将这些字符自动替换为空值。通过对比正则表达式匹配与字符集合遍历,提供可直接运行的清洗代码,适用于 URL 净化、文件名校验及数据预处理场景。
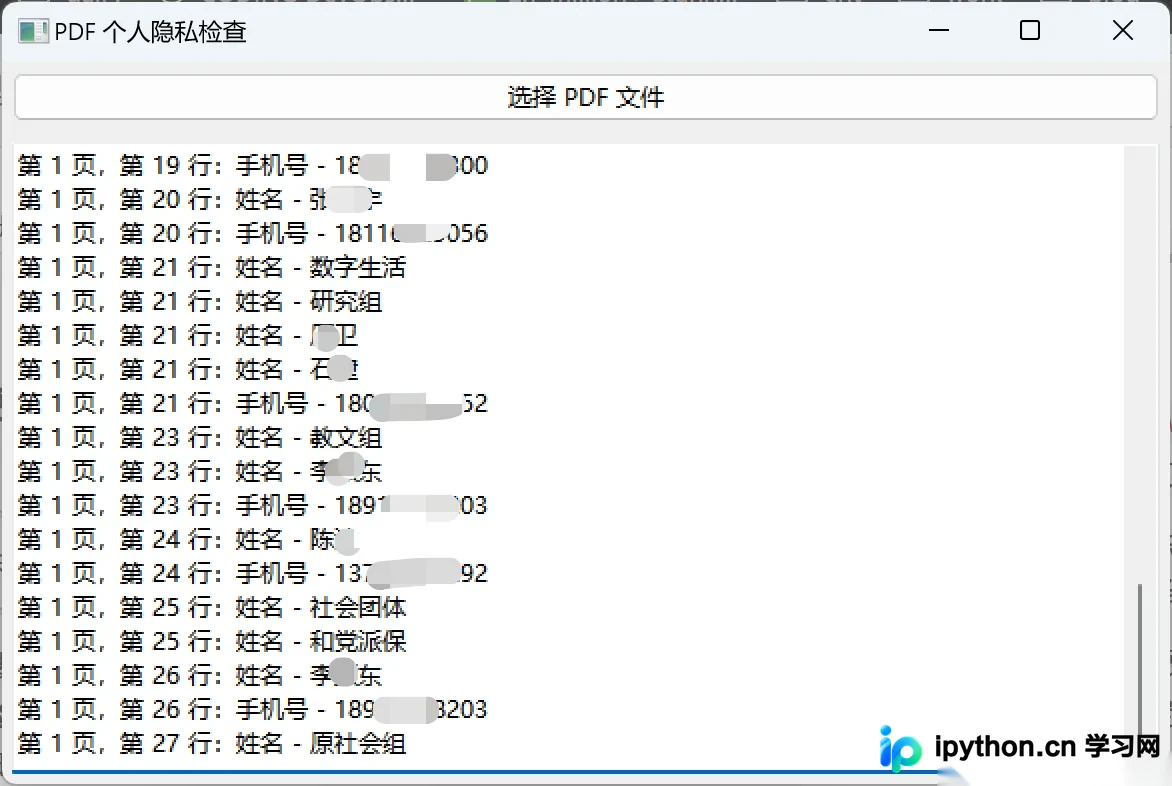
本文介绍使用Python结合pdfplumber库提取PDF文本,并配合正则表达式快速定位姓名、身份证号、手机号等敏感数据的方法。通过wxPython搭建桌面界面,输入文件后自动输出结果页码与行号,支持按需扩展检测规则,适用于日常文档脱敏审查。
数据清洗是数据分析的核心环节。本文整理Python处理字符串、数值、日期及缺失值的18种高效方法,涵盖基础语法技巧,并深入讲解正则提取、Pandas批量操作、异常捕获与函数封装等进阶流程,帮助开发者快速规范数据格式、提升处理效率。
Python 中的 re 模块提供了完整的正则表达式工具链,涵盖模式匹配、文本提取、条件替换及多行处理等核心场景。本文梳理从基础导入到高级断言、分组及编译优化的完整工作流,配合可运行的代码示例,帮助开发者高效解决复杂的字符串解析与数据清洗任务,提升代码健壮性与执行效率。