

Python实战:复杂非结构化文本数据的清洗与标准化处理

本文详解如何利用Python处理数据库中杂乱的非结构化文本数据。针对包含币种、金额及“万”字等混合信息的字符串,通过Python内置函数与逻辑判断,实现数字提取、单位统一(归一化为“万”)及币种标准化。文章提供从环境配置、逻辑拆解到全量代码实现的完整流程,并探讨基于时间戳的增量数据处理方案,适用于需要高灵活性的ETL场景。
一、运行环境
1、Python版本:2.7.13(博客中所有代码均基于此版本编写) 2、系统环境:Windows 7 64位操作系统
二、需求背景:处理杂乱文本数据
部分原始数据截图如下,第一个字段为原始数据,后续三个字段为清洗后提取的字段。从数据库中聚合观察,数据看似有规律,类似“(币种 金额 万元)”的格式。起初考虑使用SQL进行条件判断,统一转换为“万元人民币”单位,并通过SQL脚本截取字符串完成。但随后发现数据并不规则:有的字段前没有左括号,有的字段内缺失币种,有的数字并非整数,有的缺少“万”字。若将数字和“万元人民币”单位分别存储为两个字段,SQL脚本将变得极其复杂。此外,MySQL中似乎没有直接能从文本中提取数字的内置函数(正则表达式通常仅用于where条件)。若有人知晓MySQL中有此类提取函数,可告知,否则使用Kettle等工具虽可行,但需活学活用。
结合Python处理字符串的经验,Python提供了丰富的字符串过滤函数,后续代码将展示如何利用这些方法过滤和处理文本。
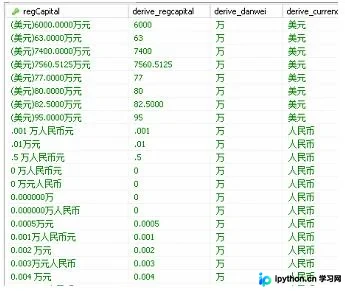
第一次部分清洗数据的效果截图
三、对数据处理宏观逻辑的思考
获取数据后,切勿急于编写代码,应先思考清洗逻辑。这一步至关重要,方向正确则事半功倍,剩余时间主要用于代码实现逻辑和调试。
3.1 思考过程(暂不写代码):
最终目标是实现数据清洗,将资金字段转换为“金额+单位+各币种”的组合形式,或“金额+单位+统一人民币币种”(涉及汇率换算)。此过程可分为两步或三步执行。
3.1.1 拆分出三个字段:数字、单位、币种
(单位分为“万”和“不含万”,币种分为“人民币”和具体“外币”)
3.1.2 将单位统一转换为“万”为单位
第一步中,若单位不是“万”,则数字部分除以10000;若单位是“万”,则数字部分保持不变。
3.1.3 将币种统一为人民币
若币种是人民币,前两个字段(金额和单位)保持不变;若不是人民币,则数字部分乘以各外币兑换人民币的汇率,单位保持第二步中统一的“万”。
3.2 期望各步骤的清洗效果:数据列举示例
基于上述结果逐步拆解,先梳理清洗逻辑部分。
3.2.1 第一次清洗期望效果:拆分出三个字段(数字、单位、币种)
① 字段值=“2000元人民币”,第一次清洗结果: 2000 不含万 人民币 ② 字段值=“2000万元人民币”,第一次清洗结果: 2000 万 人民币 ③ 字段值=“2000万元外币”,第一次清洗结果: 2000 万 外币
3.2.2 第二次清洗期望效果:将单位统一归为“万”
#二次处理条件 case when 单位='万' then 金额 else 金额/10000 end as 第二次金额 ① 字段值=“2000元人民币” 0.2 万 人民币 ② 字段值=“2000万元人民币” 2000 万 人民币 ③ 字段值=“2000万元外币” 2000 万 外币
注意:若上述步骤已满足需求,则清洗完毕;若需将单位转换为人民币,则进行后续三次清洗。
3.2.3 第三次清洗期望效果:单位与币种统一为“万+人民币”
若最终需求是换算成币种统一为人民币,则在二次清洗后的基础上再编写条件即可。
#三次处理条件 case when 币种='人民币' then 金额 else 金额*币种和人民币的换算汇率 end as 第三次金额 ① 字段值=“2000元人民币” 0.2 万 人民币 ② 字段值=“2000万元人民币” 2000 万 人民币 ③ 字段值=“2000万元外币” 2000*外币兑换人民币汇率 万 人民币
四、对具体代码宏观逻辑的思考
币种和单位仅涉及两种情况,编写相对简单。
4.1、币种部分
该条件简单,若字符中出现特定币种值,则新字段等于该币种值。
4.2、单位(以“万”为单位)
该条件也简单,若字符中出现“万”字,则单位变量设为“万”;未出现则设为“不含万”。这样设计便于后续对数字进行二次处理时编写条件判断。
4.3、数字部分:确保清洗后与原值逻辑一致,需做相应判断
确保清洗后与原值逻辑一致的意思是:例如字段“300.0100万”清洗后变为“300.01 万 人民币”也是正确的。
filter(str.isdigit,字段的值)这个代码首先能取出文本中的数字。通过对字段group by聚合后,发现有小数点的字段,取出的值不再带有小数点。例如“20.01万”,filter(str.isdigit,‘20.01万')取出的数字是2001,显然这个数字是不正确的。因此需要考虑有无小数点的情况,若有小数点,需确保处理结果与原字段一致。
四、第一次清洗主要代码(暂不读取数据库数据)
从数据库中抽取约10个异常值进行测试,info是regCapital字段的值。
#带小数点的以小数点分割 取出小数点前后部分进行拼接
  if '.' in info and int(filter(str.isdigit,info.split('.')[1]))>0:
    derive_regcapital=filter(str.isdigit,info.split('.')[0])+'.'+filter(str.isdigit,info.split('.')[1])
  elif '.' in info and int(filter(str.isdigit,info.split('.')[1]))==0:
    derive_regcapital = filter(str.isdigit, info.split('.')[0])

  elif filter(str.isdigit,info)=='':
    derive_regcapital='0'
  else:
    derive_regcapital=filter(str.isdigit,info)
  #单位 以万和不含万 为统一
  if '万' in info:
    derive_danwei='万'
  else:
    derive_danwei='不含万'
  #币种 第一次清洗 外币保留外币字段 聚合大量数据 发现数据中含有外币的情况大致有下面这些情况 如果有新外币出现 进行数据的update操作即可
  if '美元' in info:
      derive_currency='美元'
  elif '港币' in info:
    derive_currency = '港币'
  elif '阿富汗尼' in info:
    derive_currency = '阿富汗尼'
  elif '澳元' in info:
    derive_currency = '澳元'
  elif '英镑' in info:
     derive_currency = '英镑'
  elif '加拿大元' in info:
    derive_currency = '加拿大元'
  elif '日元' in info:
    derive_currency = '日元'
  elif '港币' in info:
    derive_currency = '港币'
  elif '法郎' in info:
    derive_currency = '法郎'
  elif '欧元' in info:
    derive_currency = '欧元'
  elif '新加坡' in info:
    derive_currency = '新加坡元'
  else:
     derive_currency = '人民币'
五、全部代码:读取数据库数据并进行全量清洗
第四步中我对部分数据做了测试,验证代码无误。此时逻辑上应再从宏观角度拓展,将info变量动态变为数据库中所有的值,进行全量清洗。
#coding:utf-8
from class_mysql import Mysql
project=Mysql('s_58infor_data',[],0,conn_type='local')
p2=Mysql('etl1_58infor_data',[],24,conn_type='local')
field_list=p2.select_fields(db='local_db',table='etl1_58infor_data')
print field_list
project2=Mysql('etl1_58infor_data',field_list=field_list,field_num=26,conn_type='local')
#以上部分 看不懂没关系 由于我有两套数据库环境,测试和生产
#不同的数据库连接和网段,因此要传递不同的参数进行切换数据库和数据连接 如果一套环境 连接一次数据库即可 数据处理需要经常做测试 方便自己调用
data_tuple=project.select(db='local_db',id=0)
#data_tuple 是我实例化自己写的操作数据库的类对数据库数据进行全字段进行读取,返回值是一个不可变的对象元组tuple,清洗需要保留旧表全部字段,同时增加3个清洗后的数据字段
data_tuple=project.select(db='local_db',id=0)
#遍历元组 用字典去存储每个字段的值 插入到增加3个清洗字段的表 etl1_58infor_data
for data in data_tuple:
  item={}
#old_data不取最后一个字段 是因为那个字段我想用当前处理的时间
#这样可以计算数据总量运行的时间 来调整二次清洗的时间去和和kettle定时任务对接
#元组转换为列表 转换的原因是因为元组为不可变类型 如果有数据中有null值 遍历转换为字符串会报错
  old_data=list(data[:-1])
  if data[-2]:
    if len(data[-2]) >0 :
      info=data[-2].encode('utf-8')
  else:
    info=''

  if '.' in info and int(filter(str.isdigit,info.split('.')[1]))>0:
    derive_regcapital=filter(str.isdigit,info.split('.')[0])+'.'+filter(str.isdigit,info.split('.')[1])
  elif '.' in info and int(filter(str.isdigit,info.split('.')[1]))==0:
    derive_regcapital = filter(str.isdigit, info.split('.')[0])

  elif filter(str.isdigit,info)=='':
    derive_regcapital='0'
  else:
    derive_regcapital=filter(str.isdigit,info)
  if '万' in info:
    derive_danwei='万'
  else:
    derive_danwei='不含万'
  if '美元' in info:
      derive_currency='美元'
  elif '港币' in info:
    derive_currency = '港币'
  elif '阿富汗尼' in info:
    derive_currency = '阿富汗尼'
  elif '澳元' in info:
    derive_currency = '澳元'
  elif '英镑' in info:
     derive_currency = '英镑'
  elif '加拿大元' in info:
    derive_currency = '加拿大元'
  elif '日元' in info:
    derive_currency = '日元'
  elif '港币' in info:
    derive_currency = '港币'
  elif '法郎' in info:
    derive_currency = '法郎'
  elif '欧元' in info:
    derive_currency = '欧元'
  elif '新加坡' in info:
    derive_currency = '新加坡元'
  else:
     derive_currency = '人民币'
  time_58infor_data = p2.create_time()
  old_data.append(time_58infor_data)
  old_data.append(derive_regcapital)
  old_data.append(derive_danwei)
  old_data.append(derive_currency)
  #print len(old_data)
  for i in range(len(old_data)):
    if not old_data[i] :
      old_data[i]=''
    else:
      pass
    data2=old_data[i].replace('"','')
    item[i+1]=data2
  print item[1]
  #插入测试环境 的表
  project2.insert(item=item,db='local_db')
六、代码运行情况
6.1 读取数据库原表数据和新表创建的字段
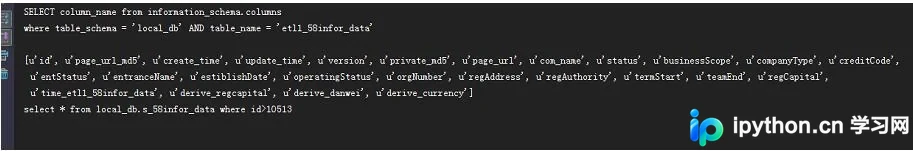
读取数据库原表数据和新表创建的字段
6.2 插入新表并进行第一次数据清洗
红框部分为清洗部分,其他数据已做脱敏处理
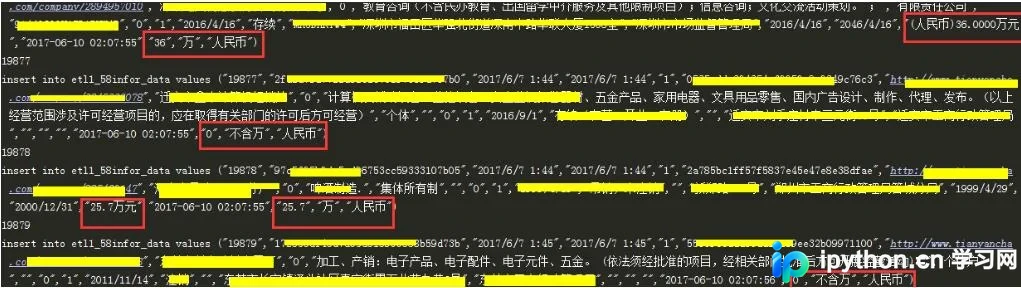
插入新表并进行第一次数据清洗
6.3 数据表数据清洗结果
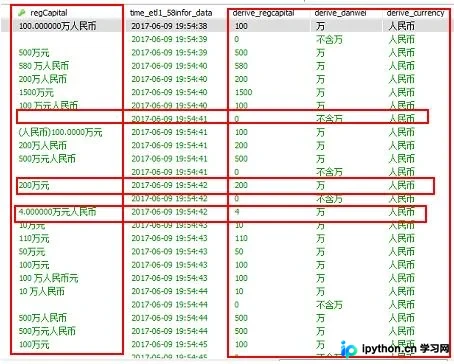
数据表数据清洗结果
七、增量数据处理
由于每天数据有增量进入,因此第一次执行初始化之后,我们需要根据表中的时间戳字段进行判断,读取昨日新的数据进行清洗插入。这部分内容留到下篇博客讨论。
初步计划使用以下函数作为参数判断增量:create_time是爬虫脚本执行时写入的时间,yesterday是昨日时间。在where条件中加以限制,取出昨天进入数据库的数据进行执行。Win7系统支持定时任务。
import datetime
from datetime import datetime as dt
#%进行转义使用%%来转义
#主要构造sql中条件“where create_time like %s%%“ % yesterday
#写入脚本运行的当前时间

def create_time(self):
  create_time = dt.now().strftime('%Y-%m-%d %H:%M:%S')
  return create_time

def yesterday(self):
  yestoday= datetime.date.today()-datetime.timedelta(days=1)
  return yestoday
以上这篇python数据处理实战(必看篇)就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









