

Python正则表达式实战:从基础用法到网页URL批量抓取
本文详解Python中正则表达式(re模块)的使用流程,涵盖compile、search与findall方法及Match对象的应用。通过固话匹配示例解析可选字符处理,进而演示结合requests模块提取网页中所有HTTP/HTTPS链接。最后介绍如何利用正则匹配图片后缀并配合os模块实现批量下载存储,提供从理论到实战的完整代码逻辑。
2026-10-13
6

本文详解Python中正则表达式(re模块)的使用流程,涵盖compile、search与findall方法及Match对象的应用。通过固话匹配示例解析可选字符处理,进而演示结合requests模块提取网页中所有HTTP/HTTPS链接。最后介绍如何利用正则匹配图片后缀并配合os模块实现批量下载存储,提供从理论到实战的完整代码逻辑。
本文详解Python中re模块的正则表达式应用,涵盖match、search、findall及split函数的具体用法。通过对比各函数在匹配位置、返回结果形式上的差异,结合完整代码示例,帮助开发者快速掌握字符串处理技巧,提升代码简洁性与执行效率。
本文通过三道Python正则表达式面试题,详细演示了如何使用re模块处理常见文本清洗任务。内容涵盖利用sub方法去除HTML标签、从URL中提取域名,以及通过split或findall方法提取字符串中的单词。每道题均提供完整代码示例与运行结果,帮助开发者掌握正则表达式在数据预处理中的实际应用技巧。
本文系统介绍Python中正则表达式的基础语法、匹配原理及re模块的核心方法。详细解析贪婪与非贪婪模式的区别,列举compile、match、search、findall等常用函数的参数与返回值,并通过代码示例展示匹配对象的使用,帮助开发者高效处理字符串匹配任务。
本文介绍Python中处理文本字符串的常用技巧。通过string.split()进行基础分割,利用正则表达式排除标点符号,过滤空字符串,并使用.lower()统一大小写。结合完整邮件示例,展示从原始文本到标准化词表的完整处理流程,适用于基础NLP数据清洗场景。
本文深入解析Python re模块中findall()函数的返回机制。重点阐述正则表达式中括号数量对结果格式的影响:多括号返回元组列表,单括号返回匹配子串列表,无括号返回完整匹配列表。通过实例代码清晰展示不同场景下的数据提取方式,帮助开发者准确处理正则匹配结果。
本文介绍使用Python编写网易网络爬虫的完整示例,通过urllib2请求页面、正则表达式提取标题及文本内容,并将结果保存至TXT文件。代码基于Python 2.7开发,涵盖页面加载、编码转换及数据存储流程,适合Python初学者参考学习网络爬虫基础实现。
本文介绍利用Python破解12306按字找图验证码的方法。主要流程包括下载并裁剪验证码图片,调用百度识图接口进行图像分析,最后通过正则表达式提取关键字。文中提供了完整的Python实现代码,并推荐了正则表达式在线测试与生成工具,供开发者参考使用。
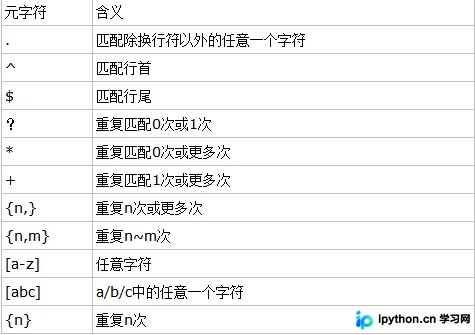
本文详细解析Java与Python中正则表达式的核心语法,涵盖元字符、转义处理及常用匹配模式(如邮箱、身份证、强密码验证)。重点介绍Python re模块的compile、search、match、findall等方法,深入讲解match对象的使用及子模式扩展语法,通过代码示例展示高级匹配技巧,帮助开发者高效处理复杂字符串任务。
本文详细介绍如何使用Python的urllib和re模块抓取网页图片。通过获取HTML源码,利用正则表达式过滤图片URL,并实现本地保存功能。代码以百度贴吧为例,演示了从获取源码、解析链接到创建文件夹保存多张图片的完整流程,适合Python初学者参考学习。
本文提供一段Python代码示例,演示如何抓取大众点评网中关村区域的餐馆信息。通过模拟浏览器请求并解析HTML页面,利用正则表达式提取餐馆名称,最终输出抓取到的餐厅列表。
本文介绍使用Python抓取亚马逊书籍基本信息的完整流程。通过构造包含node参数的GET请求获取搜索结果页,利用正则表达式解析书名、作者、封面等字段,并将结果写入MySQL数据库。代码展示了从请求构造到数据入库的核心逻辑,适用于需要批量采集书籍元数据的场景。