Python递归遍历目录提取文件中文字符代码示例
本文提供一段Python代码,演示如何递归遍历指定目录下的所有文件,利用正则表达式提取其中的中文字符并保存至结果文件。代码包含字符编码处理、文件读取及递归逻辑,供开发者参考使用。
2026-10-13
6

本文提供一段Python代码,演示如何递归遍历指定目录下的所有文件,利用正则表达式提取其中的中文字符并保存至结果文件。代码包含字符编码处理、文件读取及递归逻辑,供开发者参考使用。
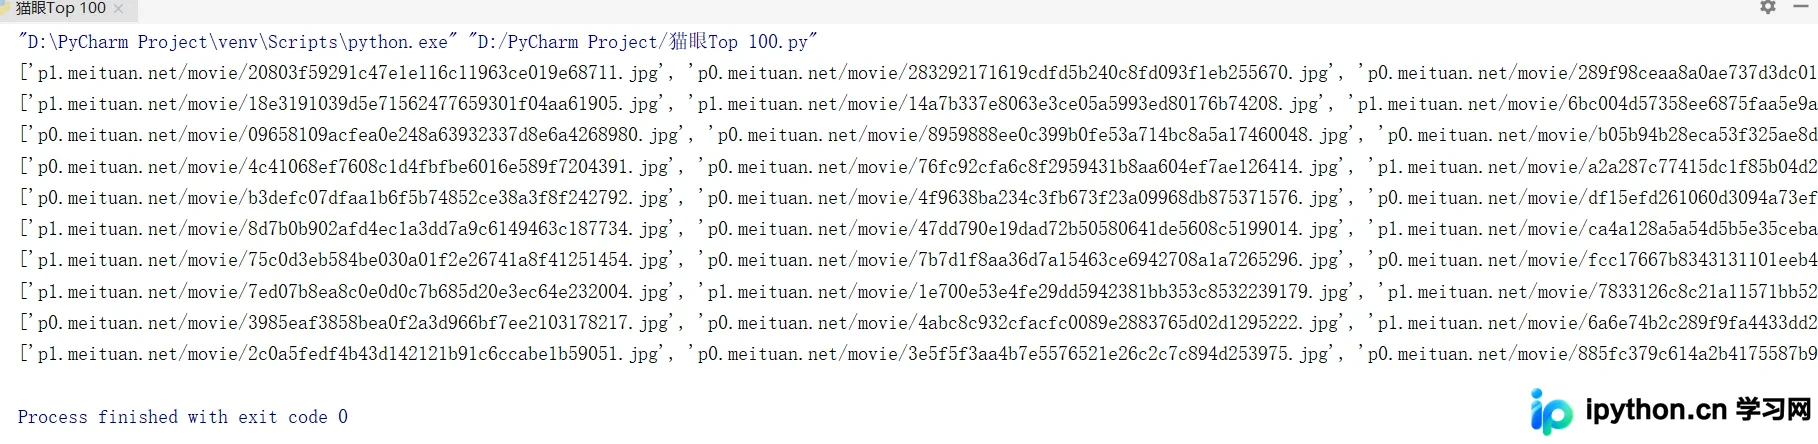
本文通过Python爬虫实战,演示如何使用正则表达式从猫眼电影Top100榜单批量下载电影封面图。文章详细解析了页面元素分析、URL规律观察及正则匹配策略,结合requests与re模块实现数据提取,并探讨该方法的优缺点及与其他爬虫技术的对比。
本文介绍利用Python的docx库结合正则表达式,实现同时批量修改多个Word文档中特定内容的自动化方法。通过遍历段落并执行替换操作,可将指定关键词批量转换为不同目标文本,生成多个新文档,有效提升办公效率。
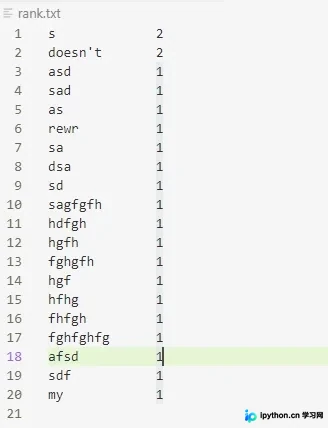
本文介绍如何使用Python合并多个TXT文件并统计出现频率最高的单词。通过读取指定目录下的文本文件,统一写入新文件后,利用正则表达式提取英文单词并排除常见无意义词汇,最终按频次排序输出前10名。此外,还展示了利用collections.Counter模块简化统计过程的更简洁方法,适用于Windows 10及Python 3.7.4环境。
本文介绍使用Python爬虫批量下载Zabbix官方文档的方法。通过requests获取页面链接,利用正则表达式解析目录结构,并拼接导出PDF参数实现批量下载。代码包含错误处理与延时机制,适合需要离线查阅技术文档的场景。
本文系统总结了Python中处理字符串的8种常用方法,涵盖切片、相乘、分割、连接、前后缀判断、查找匹配、统计替换及字符清理。通过具体代码示例,展示如何利用内置函数如split、join、find、replace以及正则表达式re模块,高效解决爬虫解析、文本清洗等场景下的字符串处理问题。
本文介绍如何利用Python的re模块,通过一行正则表达式代码高效过滤文本中的中英文标点符号及特殊字符。详细解析了\W匹配规则及自定义字符集的方法,提供完整代码示例与测试结果,帮助开发者快速实现文本清洗功能。
本文深入解析Python中反斜杠的转义机制,解释为何输出单个反斜杠需使用两个反斜杠。重点介绍原生字符串(raw string)在简化代码和提高可读性方面的优势,并详细剖析原生字符串不能以奇数个反斜杠结尾的常见陷阱及其成因,最后给出通过字符串拼接解决该问题的具体方案。
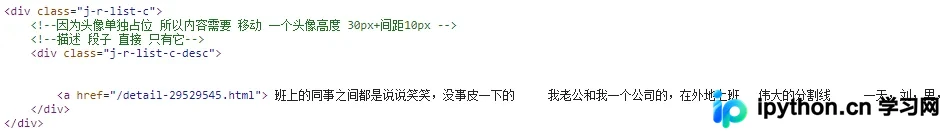
本文详细解析如何使用Python的Requests库结合正则表达式,抓取某段子网站的前20页文本数据。文章从抓包分析入手,梳理URL翻页规律,通过对比正则匹配结果优化提取逻辑,最终实现面向对象风格的完整爬虫代码,将内容保存至本地。
本文详细解析Python中正斜杠与反斜杠在文件路径和正则表达式中的不同用法。通过原始字符串r前缀、双反斜杠转义及正斜杠兼容性等技巧,解决Windows路径中的转义问题,并阐明正则表达式中匹配反斜杠的复杂逻辑,帮助开发者避免常见错误。
本文介绍在PyCharm中利用正则表达式批量修复Python 2代码中Print语句缺失括号的问题,实现从Python 2到Python 3的高效迁移。通过简单的替换操作,快速解决语法兼容性问题,提升代码维护效率。
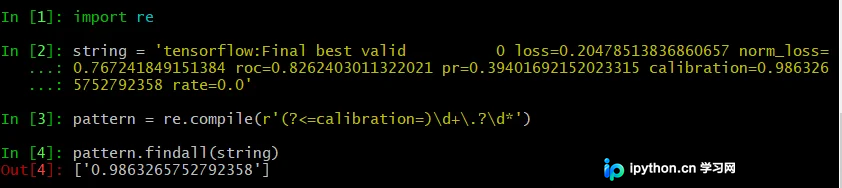
本文详解如何使用Python正则表达式从字符串中提取数字。通过解析\d、\.等核心符号,构建匹配整数与小数的模式,并演示如何提取指定前缀后的数值及时间格式。包含完整代码示例,适用于日志分析与数据清洗场景。