

Python正则表达式提取数字:原理、代码与实战案例详解

发布时间:2026-10-13| 5人浏览过
本文详解如何使用Python正则表达式从字符串中提取数字。通过解析\d、\.等核心符号,构建匹配整数与小数的模式,并演示如何提取指定前缀后的数值及时间格式。包含完整代码示例,适用于日志分析与数据清洗场景。
Python正则表达式提取数字基础
在Python开发中,从文本字符串中提取数字是常见需求。
实现这一目标最有效的方法是使用正则表达式,具体用法如下文所述。
## 总结
## ^ 匹配字符串的开始。
## $ 匹配字符串的结尾。
## \b 匹配一个单词的边界。
## \d 匹配任意数字。
## \D 匹配任意非数字字符。
## x? 匹配一个可选的 x 字符 (换言之,它匹配 1 次或者 0 次 x 字符)。
## x* 匹配0次或者多次 x 字符。
## x+ 匹配1次或者多次 x 字符。
## x{n,m} 匹配 x 字符,至少 n 次,至多 m 次。
## (a|b|c) 要么匹配 a,要么匹配 b,要么匹配 c。
## (x) 一般情况下表示一个记忆组 (remembered group)。你可以利用 re.search 函数返回对象的 groups() 函数获取它的值。
## 正则表达式中的点号通常意味着 “匹配任意单字符”
解题思路分析:
提取数字时,目标数值通常表现为整数、小数或整数与小数混合的形式。
因此,数字字符串的一般结构为:前导数字、可选的小数点、以及后续数字。
基于上述结构,我们可以构建如下正则表达式模式:"\d+\.?\d*"。
该模式中,\d+用于匹配一个或多个数字,注意此处必须使用+而非*,因为即使是纯小数,小数点前也至少需要存在一个数字;\.?用于匹配可选的小数点,即小数点可能存在也可能不存在;\d*用于匹配小数点后的数字,允许出现0个或多个数字。
基础实现代码如下:
import re
string="A1.45,b5,6.45,8.82"
print re.findall(r"\d+\.?\d*",string)
# ['1.45', '5', '6.45', '8.82']
特定前缀数字提取技巧
若需匹配以特定字符串开头的数字,可参考以下示例。
例如针对如下string变量:
tensorflow:Final best valid   0 loss=0.20478513836860657 norm_loss=0.767241849151384 roc=0.8262403011322021 pr=0.39401692152023315 calibration=0.9863265752792358 rate=0.0
提取 calibration=0.9863265752792358 .
# 匹配“calibration=”后面的数字
pattern = re.compile(r'(?<=calibration=)\d+\.?\d*')
pattern.findall(string)
# ['0.9863265752792358']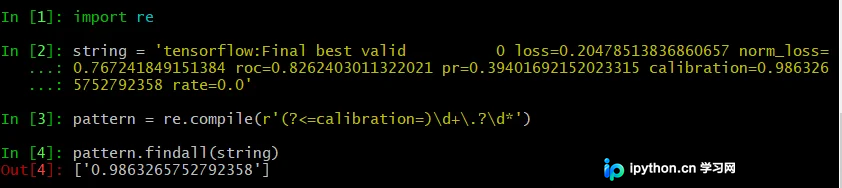
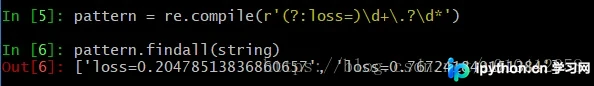
若需匹配包含特定前缀字符串开头的数字,可使用以下方法。
pattern = re.compile(r'(?:loss=)\d+\.?\d*')
pattern.findall(string)
# ['loss=0.20478513836860657', 'loss=0.767241849151384']
时间与日期格式匹配实战
针对时间格式“时:分:秒”(如17:35:24)的匹配方法如下。
string = "WARNING:tensorflow: 20181011 15:28:39 Initialize training"
pattern = re.compile(r'\d{2}:\d{2}:\d{2}')
pattern.findall(string)
# ['15:28:39']
针对包含日期和时间的时间格式(如20181011 15:28:39)的匹配方法如下。
string = "WARNING:tensorflow: 20181011 15:28:39 Initialize training"
pattern = re.compile(r'\d{4}\d{2}\d{2}\s\d{2}:\d{2}:\d{2}')
pattern.findall(string)
# ['20181011 15:28:39']
总结:
以上介绍了利用Python正则表达式从字符串中提取数字的详细思路与实现方法,希望能为读者提供帮助。如有任何疑问,欢迎留言交流,小编将及时回复。感谢大家对本站的支持! 若觉得本文对您有帮助,欢迎转载,请注明出处,谢谢!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









