

Python实现ComicReaper漫画自动爬取脚本详解
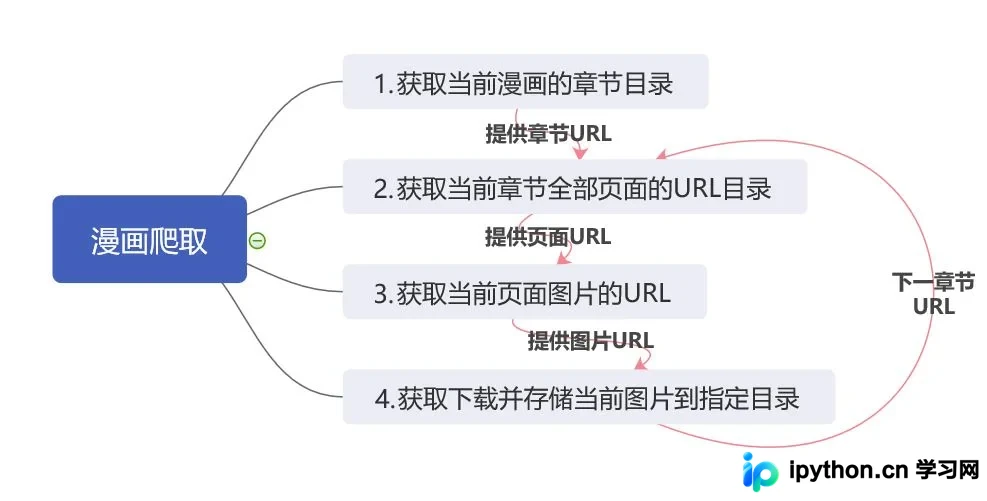
本文详细介绍使用Python 3开发ComicReaper漫画自动爬取脚本的全过程。通过解析HTML结构,利用re与urllib库提取章节标题与URL,并设置User-Agent和Referer请求头以模拟浏览器行为,实现从指定主页URL自动获取整本漫画章节目录的功能。
2026-10-14
6

本文详细介绍使用Python 3开发ComicReaper漫画自动爬取脚本的全过程。通过解析HTML结构,利用re与urllib库提取章节标题与URL,并设置User-Agent和Referer请求头以模拟浏览器行为,实现从指定主页URL自动获取整本漫画章节目录的功能。
本文介绍了一个基于Python3的百度图片批量下载脚本。通过正则表达式解析HTML获取图片链接,并利用requests库进行抓取。代码包含URL构造、分页处理及本地存储逻辑,旨在提供简单的图片采集工具实现参考。
本文详细介绍如何利用Python正则表达式从非结构化文本中提取日期和时间。内容涵盖文本预处理、多种格式的正则匹配规则、函数封装实现以及完整代码示例,帮助开发者高效处理包含中文或标准格式的日期字符串。
本文介绍使用Python爬取幽默笑话网站的技术实现。通过threadpool线程池处理多页并发请求,优化系统性能;利用lxml与正则表达式结合的方式清洗HTML结构中的混乱文本。文章提供了完整的代码示例,包括多线程任务调度、节点提取及文本过滤逻辑,帮助开发者掌握高效的数据抓取技巧。
本文详细解析Python中常用内置模块的核心用法。涵盖time与datetime的时间处理、random随机数生成、os系统操作、sys环境变量、json与pickle数据序列化、xml解析、re正则表达式匹配以及logging日志记录等模块。通过具体代码示例,展示各模块的关键函数与参数配置,帮助开发者高效利用Python标准库进行开发。
本文详细介绍使用Python从XML文件中提取链接的两种方法。第一种利用urllib和正则表达式匹配URL,适用于简单结构;第二种通过xml.dom.minidom遍历节点,适合复杂XML文档。代码包含完整示例,帮助开发者快速实现数据抓取与解析功能。
本文深入解析Python中正则表达式的贪婪与非贪婪模式。通过代码实例说明默认贪婪模式会匹配尽可能多的字符,而在量词后添加问号可启用非贪婪模式,匹配最少字符。文章结合源码分析,解释*?、+?等忽略优先量词的工作原理,帮助开发者准确控制正则匹配行为。
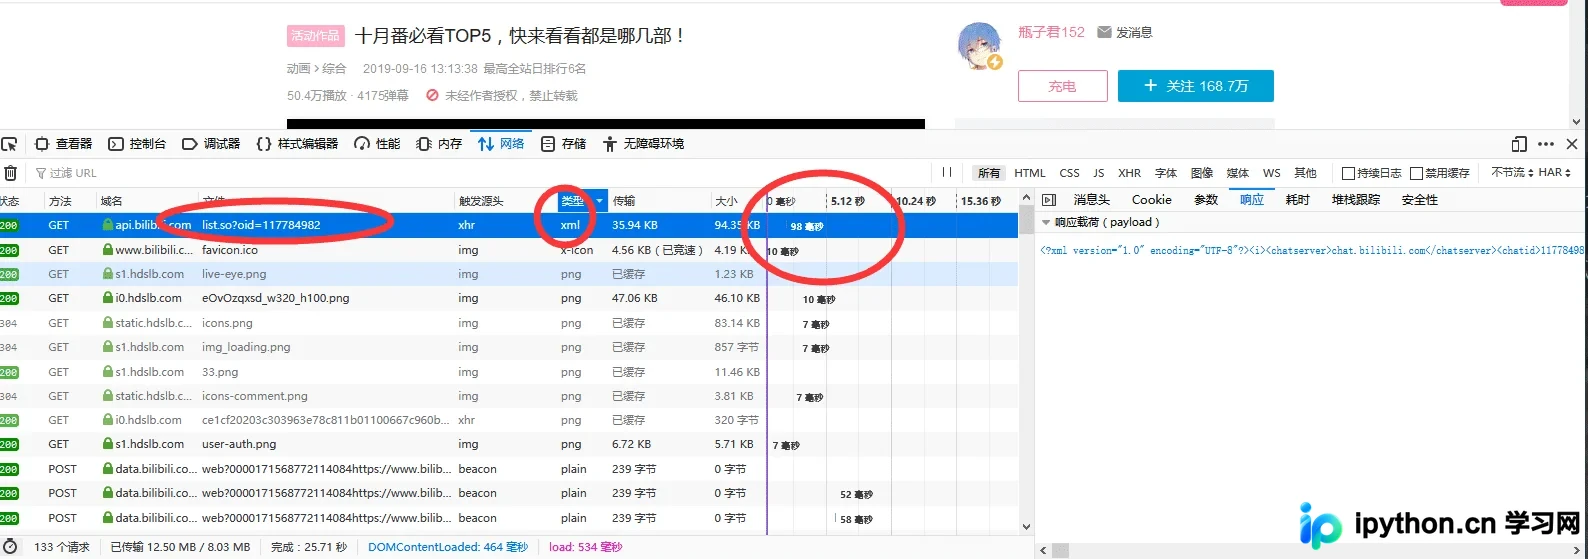
本文解析使用Python抓取B站弹幕的技术流程。针对B站数据异步加载特性,通过浏览器开发者工具定位包含oid的XML请求接口。利用正则表达式从视频页面解析cid和aid,构造API请求获取弹幕文件。文章提供完整代码示例,展示如何从视频链接到最终获取弹幕数据的完整步骤。
本文详解如何利用Python正则表达式编写一个抓取内涵段子的爬虫程序。内容涵盖使用urllib2获取网页源码、通过正则表达式匹配特定HTML标签提取段子内容、处理中文编码乱码问题,以及将结果保存至本地文件。通过分步代码示例,展示从数据获取、筛选到持久化存储的完整流程。
本文介绍在Python中同时替换多个字符或字符串的两种常用方法。第一种通过链式调用replace函数实现,直观简单;第二种利用正则表达式re模块,构建模式并配合lambda函数进行批量替换,适用于复杂场景。
本文介绍利用Python脚本在自动化测试前全局批量为页面元素添加ID的方法。针对重构导致元素层级变化或定位困难的问题,通过正则表达式匹配特定标签(如el-button)并注入唯一ID属性。文章涵盖Python环境配置、环境变量设置及核心脚本逻辑,帮助测试人员快速优化元素定位稳定性。
本文深入解析Python中反斜杠在不同语境下的行为。在普通字符串中,反斜杠用于转义字符;在原生字符串中其特殊含义被剥夺,但仍受限于不能以奇数个结尾的规则。重点阐述在正则表达式中,反斜杠作为元字符的双重身份:既需转义Python字符串中的特殊字符,又需转义正则元字符。通过对比普通字符串、原生字符串及正则表达式中的写法,阐明匹配纯反斜杠的正确方式及常见陷阱。