

Python字符串处理的8个核心技巧与实战
本文系统总结了Python中处理字符串的8种常用方法,涵盖切片、相乘、分割、连接、前后缀判断、查找匹配、统计替换及字符清理。通过具体代码示例,展示如何利用内置函数如split、join、find、replace以及正则表达式re模块,高效解决爬虫解析、文本清洗等场景下的字符串处理问题。
2026-10-13
6

本文系统总结了Python中处理字符串的8种常用方法,涵盖切片、相乘、分割、连接、前后缀判断、查找匹配、统计替换及字符清理。通过具体代码示例,展示如何利用内置函数如split、join、find、replace以及正则表达式re模块,高效解决爬虫解析、文本清洗等场景下的字符串处理问题。
本文介绍如何利用Python的re模块,通过一行正则表达式代码高效过滤文本中的中英文标点符号及特殊字符。详细解析了\W匹配规则及自定义字符集的方法,提供完整代码示例与测试结果,帮助开发者快速实现文本清洗功能。
本文深入解析Python中反斜杠的转义机制,解释为何输出单个反斜杠需使用两个反斜杠。重点介绍原生字符串(raw string)在简化代码和提高可读性方面的优势,并详细剖析原生字符串不能以奇数个反斜杠结尾的常见陷阱及其成因,最后给出通过字符串拼接解决该问题的具体方案。
本文详细解析如何使用Python的Requests库结合正则表达式,抓取某段子网站的前20页文本数据。文章从抓包分析入手,梳理URL翻页规律,通过对比正则匹配结果优化提取逻辑,最终实现面向对象风格的完整爬虫代码,将内容保存至本地。
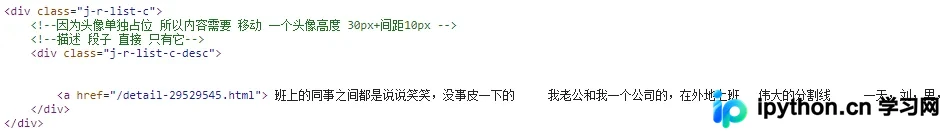
本文详细解析Python中正斜杠与反斜杠在文件路径和正则表达式中的不同用法。通过原始字符串r前缀、双反斜杠转义及正斜杠兼容性等技巧,解决Windows路径中的转义问题,并阐明正则表达式中匹配反斜杠的复杂逻辑,帮助开发者避免常见错误。
本文介绍在PyCharm中利用正则表达式批量修复Python 2代码中Print语句缺失括号的问题,实现从Python 2到Python 3的高效迁移。通过简单的替换操作,快速解决语法兼容性问题,提升代码维护效率。
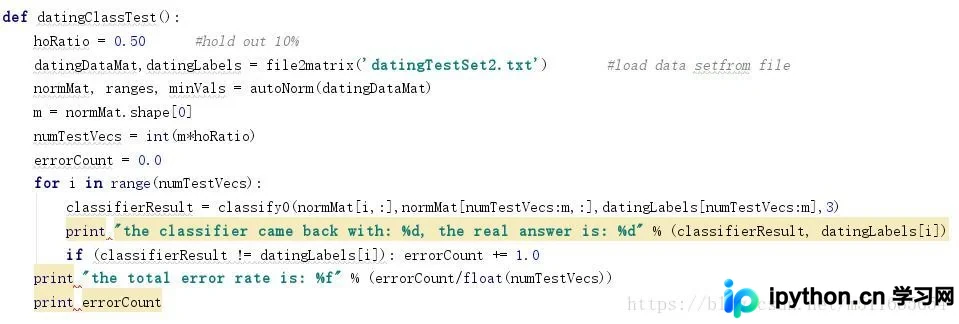
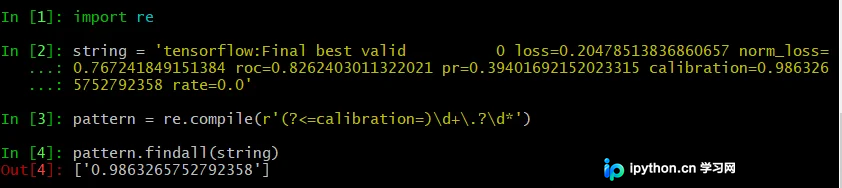
本文详解如何使用Python正则表达式从字符串中提取数字。通过解析\d、\.等核心符号,构建匹配整数与小数的模式,并演示如何提取指定前缀后的数值及时间格式。包含完整代码示例,适用于日志分析与数据清洗场景。
本文详解使用Python提取Bilibili视频弹幕的完整流程。核心在于通过手机User-Agent请求视频页面,利用正则表达式从响应JavaScript中提取弹幕接口所需的cid参数,拼接生成以.xml结尾的弹幕URL。随后发起二次请求获取XML数据,借助lxml库解析并提取文本内容,最终保存至本地文件。

本文系统梳理Python中正则表达式模块re的核心用法。详细解析了re.I、re.S等修饰符及^、$、.等基础模式,深入讲解re.compile、re.match、re.search、re.split、re.findall、re.finditer和re.sub等关键函数的参数与返回值特性,结合代码示例说明分组捕获、非贪婪匹配及替换函数的实际应用,帮助开发者高效掌握正则处理技巧。
本文介绍在Python中使用正则表达式同时匹配TAB和空格的方法。通过\s元字符或[\t ]字符组,可以精确捕获混合空白字符。文章结合re.match示例,演示如何正确分组提取包含TAB和空格的字符串内容,避免(.*)过度匹配的问题。
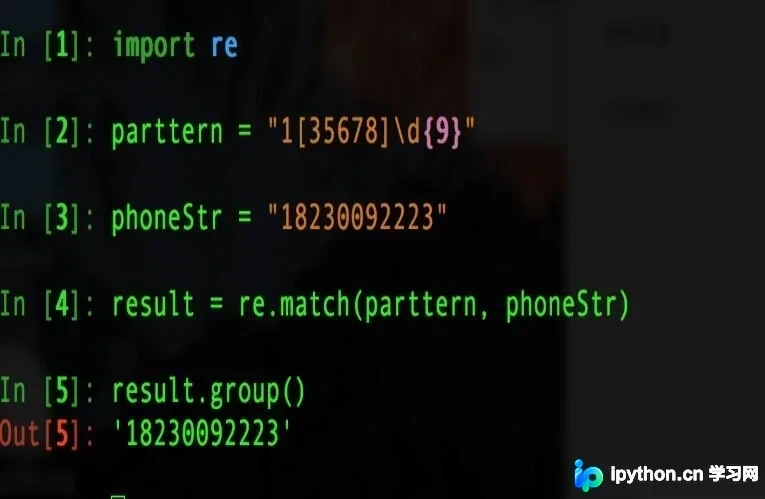
本文详细总结Python3中正则表达式模块re的核心用法。涵盖单字符与数量匹配规则、原始字符串raw在避免转义冲突中的应用、边界匹配技巧,以及分组、分组引用和命名分组的实战案例。通过手机号验证、数字范围匹配及HTML标签提取等示例,帮助开发者掌握正则表达式在爬虫与数据清洗中的关键技能。
本文介绍在Python中使用正则表达式匹配以https?://开头、以jpg/png/jpeg结尾的字符串,并排除空格及引号等干扰字符的方法。通过实例演示从基础表达式到优化表达式的过程,展示如何利用[^ ",]排除特定字符,实现精准匹配。