

Python使用python-docx实现指定文本标红并写入Word
本文介绍如何利用Python的python-docx库读取TXT文件,通过正则表达式定位特定字符串(如“鳌太”),并在生成的Word文档中将该部分文本设置为红色字体。文章提供了完整的代码示例,展示如何分段添加段落、设置Run对象的字体颜色属性以及保存文档,适用于需要自动化生成带高亮标记的Word报告的场景。
2026-10-13
6

本文介绍如何利用Python的python-docx库读取TXT文件,通过正则表达式定位特定字符串(如“鳌太”),并在生成的Word文档中将该部分文本设置为红色字体。文章提供了完整的代码示例,展示如何分段添加段落、设置Run对象的字体颜色属性以及保存文档,适用于需要自动化生成带高亮标记的Word报告的场景。
本文介绍如何使用Python正则表达式验证IP地址,提供完整的代码示例。通过re模块的compile、finditer及search方法,演示如何提取IP地址及捕获分组信息,适用于网络数据处理场景。
本文详细解析Python re模块中贪婪与非贪婪模式的匹配机制。通过对比示例,说明默认贪婪模式尽可能匹配最长字符串,而非贪婪模式通过添加问号“?”实现最少匹配。文章提供具体代码案例,展示如何正确处理数字提取等场景,帮助开发者精准控制正则表达式的匹配行为。
本文介绍在Python中如何获取指定目录下的所有文件和文件夹。通过os.chdir修改路径,利用os.listdir或os.scandir列出内容,并使用os.path.isdir或file.is_dir区分文件与文件夹。示例展示了统计非文件夹文件数量及包含特定关键词(如python)的文件,最后通过正则表达式实现不区分大小写的匹配。
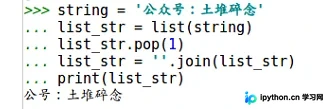
本文介绍在Python中删除字符串特定字符的两种主要方法。由于字符串不可变,需转为列表使用pop()按索引删除,或利用replace()、re.sub()按字符内容替换。重点解析参数用法及返回值处理,适用于需要精确控制删除位置或数量的场景。
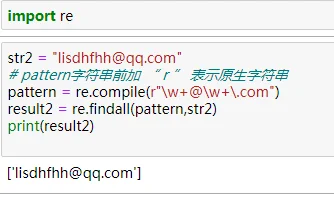
本文详解Python中re库的核心用法,涵盖compile、match、search及findall等关键函数的定义与区别。深入解析正则符号如点号、星号、问号及分组机制,并通过邮箱提取等实例演示group与groups方法的实际应用,帮助开发者掌握文本模式匹配与数据提取技巧。
本文介绍如何使用Python正则表达式处理特定模式的字符串,即去除开头空格与数字间多余的小数点。通过分组匹配提取有效内容,实现字符串清洗。此外,针对包含40万+样本的大规模数据集,文章展示了利用多进程Pool结合文件遍历与路径操作,批量修正标签文件并移动图片至对应文件夹的完整方案。
本文介绍如何使用Python正则表达式替代内置的eval()函数来计算包含括号的字符串算式。通过匹配最内层括号,依次执行乘除和加减运算,并逐步替换结果,最终实现安全、原生的算式解析逻辑。
本文介绍了在Python中利用正则表达式匹配IP地址的方法。文章提供了具体的代码示例,解析了正则表达式的构成逻辑,包括对IP段数值范围(0-255)的处理及整体结构的匹配。同时补充了关于广播地址和保留地址的网络常识,旨在为相关开发工作提供实用的参考。
本文介绍在Python中统计文本文件内特定字符串出现次数的两种常用方法。首先通过两次split操作处理包含换行符和斜杠分隔符的数据,利用字典累计词频;随后展示使用re.split结合正则表达式一次性分割多种分隔符的更高效方案,并附带完整代码示例及注意事项。
本文介绍如何使用 Python 脚本解析 sim.log 文件,通过正则表达式定位 BEGINNING SIM PROCEDURE、CP_W 等关键节点的时间戳。程序自动提取各步骤时间并计算阶段耗时,最终输出从 apply 到 commit 及回滚的完整时间线统计,适用于系统更新流程的性能分析与故障排查。
本文详细介绍Python中正则表达式的应用,涵盖非负整数、整数、非正整数、邮箱、十一位手机号及日期的匹配方法。通过具体代码示例,展示如何编译正则模式并执行搜索,帮助开发者高效解决字符串匹配问题。