

Python中文正则表达式匹配实战:从纯真库到IP138数据解析
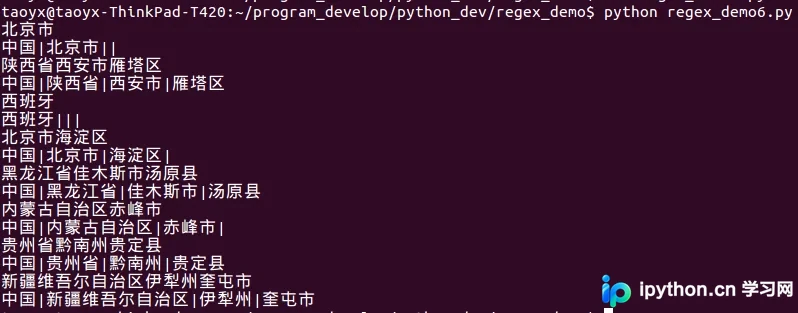
本文详细介绍如何在Python中使用中文正则表达式匹配指定中文字符串。针对GBK与UTF-8编码差异,推荐统一使用UTF-8编码以确保匹配准确性。通过两个实际案例:从纯真数据库解析省市县信息,以及从IP138网站提取ISP数据,展示了懒惰匹配和Unicode处理的关键技巧。
2026-10-13
6

本文详细介绍如何在Python中使用中文正则表达式匹配指定中文字符串。针对GBK与UTF-8编码差异,推荐统一使用UTF-8编码以确保匹配准确性。通过两个实际案例:从纯真数据库解析省市县信息,以及从IP138网站提取ISP数据,展示了懒惰匹配和Unicode处理的关键技巧。
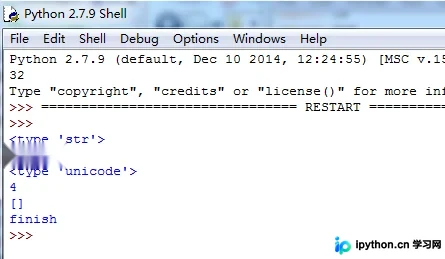
本文详细介绍在Python中使用正则表达式匹配中文字符的方法。核心思路是将字符串转换为Unicode格式,利用[u\u4e00-\u9fa5]模式进行匹配,并注意文件编码(如GBK)的转换。文中提供了完整代码示例及在线正则测试工具链接,帮助开发者高效处理中文文本。
本文详解Python3中提取字符串内数字的两种常用方法。首先解析利用re.sub配合正则表达式\D替换非数字字符的实现原理及代码示例;其次探讨通过split()按空格分隔并取首元素的方式处理特定格式数据。对比两者适用场景与局限性,为处理爬虫数据或格式化文本提供清晰的技术参考。
本文介绍如何在Python中使用正则表达式匹配以特定关键词开头的字符串。通过re.compile定义模式,利用finditer遍历匹配项并提取内容。示例展示了匹配成功与失败的情况,并提供了在线测试工具链接供参考。
本文详细介绍 Python 中字符串处理的核心操作,涵盖字符串输入获取、纯字母判断方法 isalpha(),以及利用 re 模块进行正则表达式匹配的具体实例。同时解析了将字符串转换为小写、多字符串连接拼接以及截取子字符串(去除首尾字符)的常用技巧,帮助开发者掌握基础字符串操作。
本文详解利用Python正则表达式截取成对括号的方法,通过动态生成正则模式支持多层嵌套。文中提供了JavaScript正则测试及在线生成工具链接,并附带Python常用教程合集,旨在帮助开发者高效处理字符串中的括号匹配问题。
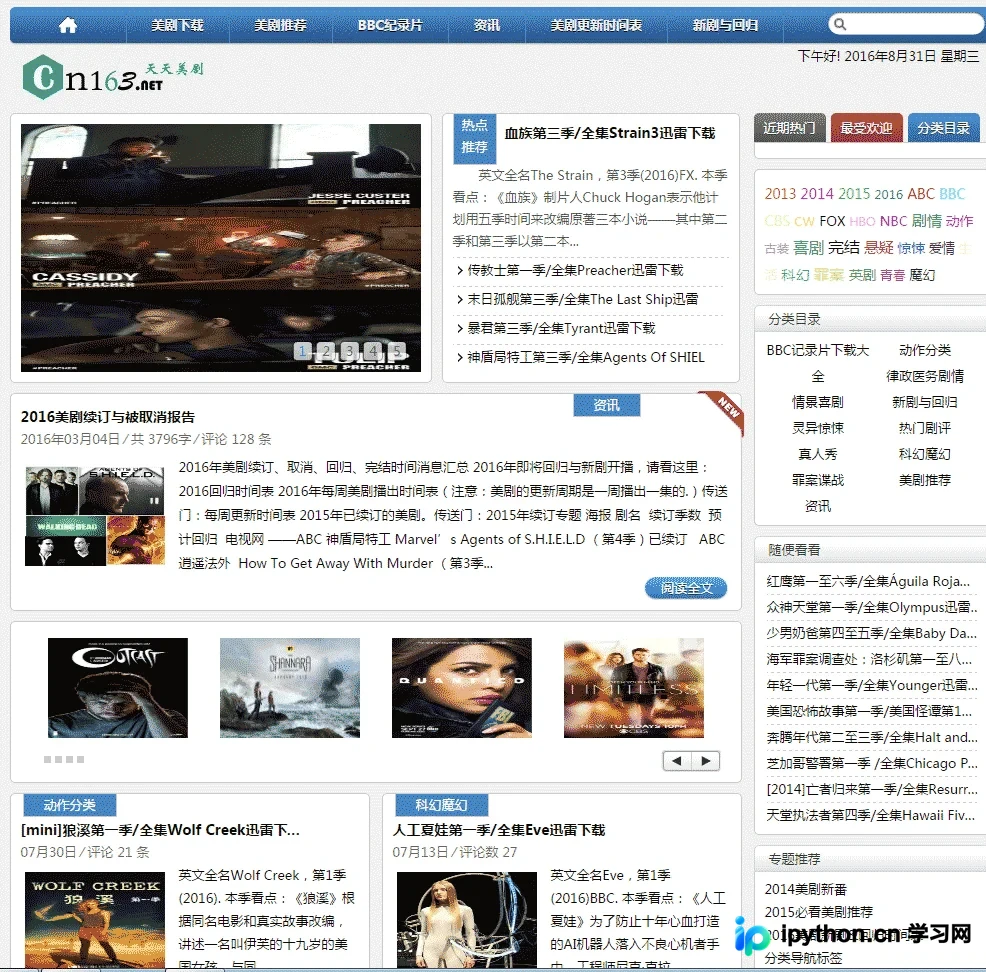
本文介绍如何使用Python编写爬虫程序,自动抓取美剧网站上的所有剧集下载链接。通过遍历URL编号、利用status_code过滤无效页面,并结合正则表达式提取ed2k链接,最终将结果按剧名保存为txt文件。文章还探讨了文件命名中的特殊字符处理及多线程在Python GIL限制下的实际效果。
本文分享了一段基于Python语言的简单爬虫代码,主要利用正则表达式从指定网页中提取图片链接并批量保存至本地。代码涉及urllib库的使用、正则匹配规则定义以及文件保存逻辑,适合Python初学者参考学习基础的网络数据抓取技术。
本文介绍在Django框架中,通过定义正则表达式匹配规则,结合pattern库解析HTML DOM结构,自动抓取指定URL及其关联联系页面上的所有Email地址。代码包含异常处理、URL标准化及缓存机制,适用于批量获取网页联系信息场景。
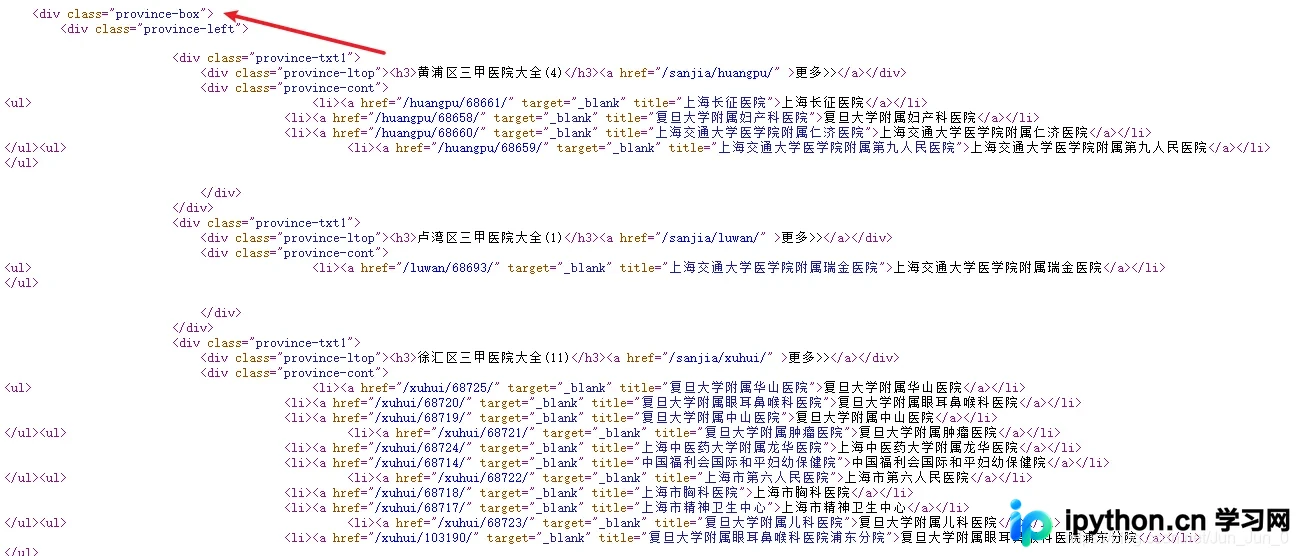
本文详解如何使用Python正则表达式进行网页数据抓取。通过解析上海三甲医院网站源码,演示了利用re模块进行一级和二级过滤以提取医院名称的方法,并展示了如何编写正则表达式从HTML中提取图片URL。包含完整的Python代码示例、正则匹配逻辑分析及运行结果展示,帮助读者掌握文本与图片的批量爬取技巧。
本文深入解析Python工程师面试中的六大经典问题,涵盖tuple与list的相互转换方法、re模块中match与search函数的核心差异、文件与目录的删除API使用,以及is与==在内存地址与值比较上的本质区别。同时探讨了字符串驻留机制、小整数缓存池对对象身份的影响,以及变量交换的多种技巧,帮助开发者巩固基础并应对技术面试。
本文详解如何在Python中利用正则表达式处理PDF转文本产生的多余空格问题。通过特定正则模式,可精准去除中文及数字间的冗余空格,同时严格保留英文单词间的正常间隔。提供re.sub与split两种实现方案,并附完整代码示例,帮助开发者优化文本数据观感与后续处理效果。