Python实现罗马数字转阿拉伯数字算法详解
本文详细介绍使用Python将罗马数字转换为阿拉伯数字的实现方法。文章解析了罗马数字的基本符号(I, V, X等)及其组合规则,重点讲解了利用正则表达式验证输入合法性及通过字典映射进行数值累加的算法逻辑。提供了完整的Python函数代码,可直接用于处理如MDCCCLXXXVIII等标准罗马数字字符串的转换任务。
2026-10-13
6

本文详细介绍使用Python将罗马数字转换为阿拉伯数字的实现方法。文章解析了罗马数字的基本符号(I, V, X等)及其组合规则,重点讲解了利用正则表达式验证输入合法性及通过字典映射进行数值累加的算法逻辑。提供了完整的Python函数代码,可直接用于处理如MDCCCLXXXVIII等标准罗马数字字符串的转换任务。
本文介绍利用Python正则表达式从指定网页提取并保存图片的方法。通过定义匹配规则筛选图片链接,结合urllib库实现批量下载。文中附带Python代码示例及正则表达式在线测试工具链接,帮助开发者快速掌握网页图片抓取技巧。
本文介绍利用Python正则表达式按连续换行符分割大文件,并将每3个段落合并写入新小文件的完整流程。通过遍历切片列表并动态管理文件句柄,实现自动化分段存储,适用于语料处理等场景。
本文深入解析 Python Beautiful Soup 库的搜索功能,涵盖 find() 与 find_all() 的核心用法。详细讲解如何通过标签名、属性、文本及正则表达式精准定位元素,并演示处理自定义属性和 CSS 类属性的技巧。此外,还介绍了利用父级、同级及下级标签进行关联搜索的高级策略,帮助开发者高效提取网页数据。
本文通过Python中re.split函数的实际运行结果,解析了正则表达式中括号分组对匹配结果的影响。当使用带括号的模式如'(\W+)'时,分组内的匹配内容会被单独提取并保留在返回列表中,导致非单词字符出现在结果里。对比无括号模式可知,这是正则表达式标准行为,旨在允许用户获取分隔符信息。
本文介绍如何利用Python的re库进行简单的字符串匹配。通过构建正则表达式模式并编译为对象,调用其方法即可获取匹配结果。文章结合具体代码示例,展示了从导入模块到打印匹配内容的完整流程,适合数据分析与算法工作者参考。
本文详解Python标准库string模块中的字符串常量,并深入剖析Template类的用法。通过对比Template、%格式化及format()方法,展示Template类的优势。重点讲解如何通过继承Template类并重写delimiter和idpattern属性,利用正则表达式自定义变量名匹配规则,实现更灵活的字符串模板替换。
本文解析 PHP 数据采集的核心流程,包括使用 fopen 获取网页源码、利用 preg_match_all 正则提取列表页的链接与标题,以及解决连续请求失效问题的 Meta Refresh 循环技巧。
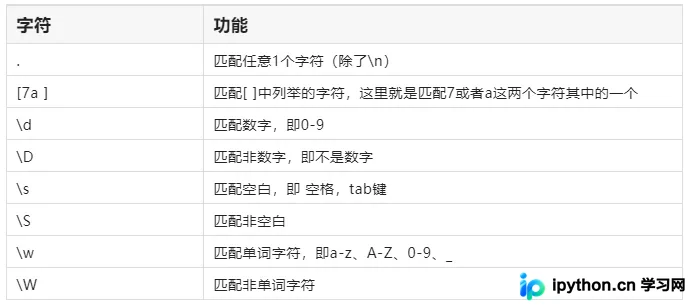
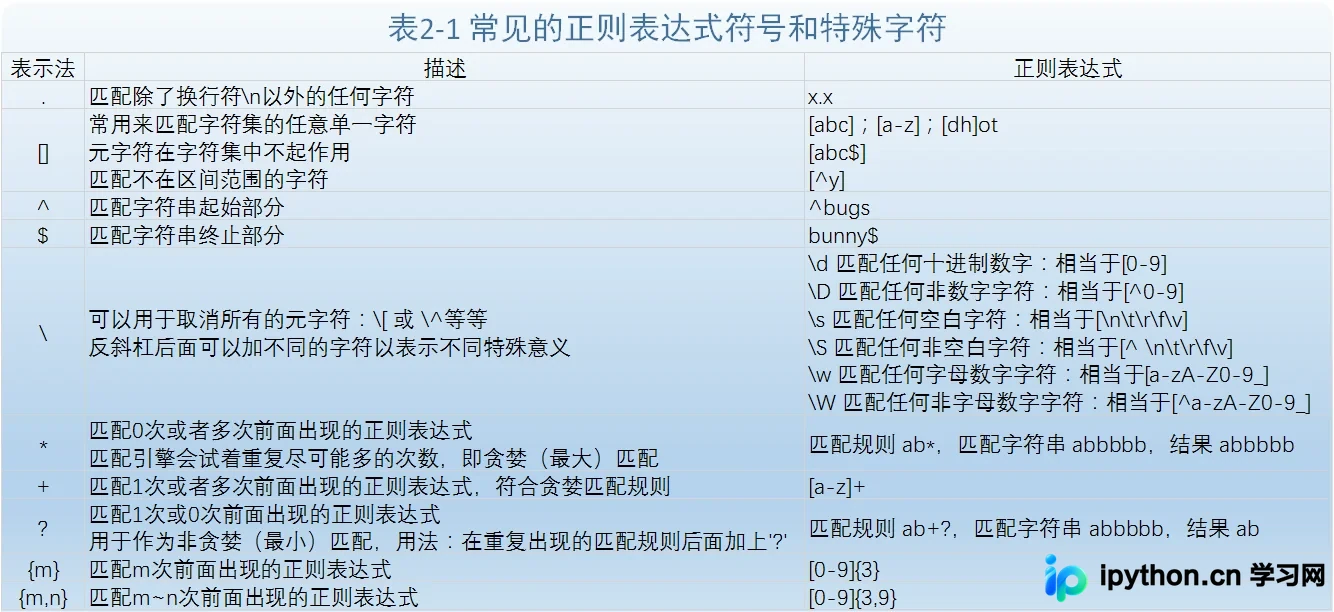
本文详解Python中re模块的正则表达式应用。涵盖元字符使用、compile预编译优化、match与search匹配差异、findall/finditer查找、sub/subn替换及split分割。重点解析group与groups分组提取技巧,结合代码示例展示常用函数的高级用法与标志参数设置。
本文介绍如何使用Python脚本通过输入文件自动生成目标文件。通过定义包含正则匹配与文件读写逻辑的函数,并结合sys.argv获取命令行参数,实现自动化文件处理流程。该方案旨在简化重复性工作,提升开发效率,适用于多种文件格式的批量转换场景。
本文详细讲解了在PHP中如何正确处理包含中文等多字节字符的字符串截取。重点分析了原生substr函数导致的乱码问题,并提供了基于UTF-8正则匹配、GBK编码处理以及BugFree经典算法等多种解决方案,帮助开发者准确截断字符串并保留完整编码结构。
本文详细介绍Python中利用re模块进行接口自动化数据提取的方法。涵盖正则表达式基础语法、贪婪与非贪婪模式、re.match与re.search区别,以及findall和sub函数的实际应用。通过登录接口提取Token的完整案例,帮助开发者掌握高效的数据解析技巧。