

Python利用正则表达式抓取网页文本与图片详解

本文详解如何使用Python正则表达式进行网页数据抓取。通过解析上海三甲医院网站源码,演示了利用re模块进行一级和二级过滤以提取医院名称的方法,并展示了如何编写正则表达式从HTML中提取图片URL。包含完整的Python代码示例、正则匹配逻辑分析及运行结果展示,帮助读者掌握文本与图片的批量爬取技巧。
一、正则表达式是什么?
概念:
正则表达式是一种用于处理字符串的逻辑工具,它通过预先定义的特定字符及其组合,构建出“规则字符串”,从而实现对字符串的过滤逻辑表达。
作为一个特殊的字符序列,正则表达式能够协助用户便捷地检查字符串是否符合特定的匹配模式。
个人理解:
简而言之,正则表达式相当于一个过滤器,用于从杂乱无章的信息(例如网页源代码)中筛选出有价值的目标内容。
二、实战项目
1.爬取内容
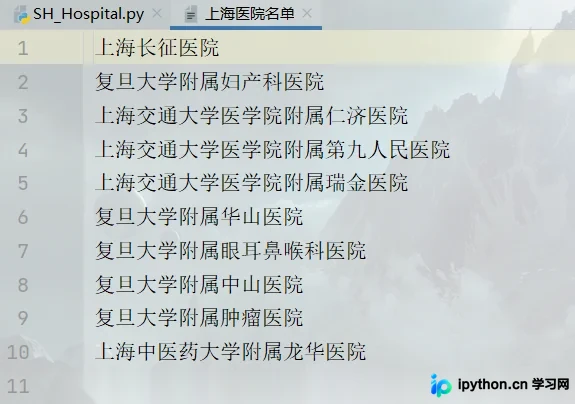
本案例旨在获取上海所有三甲医院的名称,并将结果保存至.txt文件中。
2.访问链接
目标网站为上海三甲医院列表页,链接地址为:https://yyk.99.com.cn/sanjia/shanghai/
3.正则表达式书写的灵感
查看该网页的源代码后发现,医院名称均被包裹在特定的HTML标签结构中。
<div class="province-box"> ...... </div>
我们只需针对该结构区域的数据进行过滤处理,即可提取所需信息。
正则表达式:
法一:
1.一级过滤 :
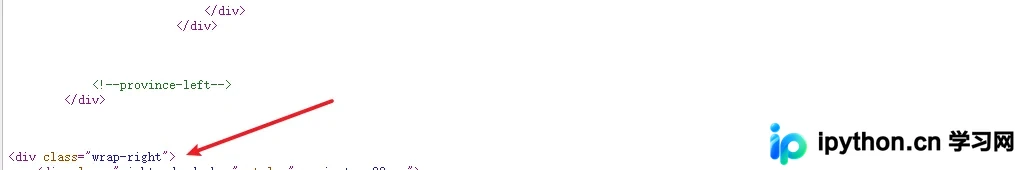
<div class="province-box">(.*)<div class="wrap-right">
匹配逻辑为:以<div class="province-box">开头,以<div class="wrap-right">结尾,中间内容通过(.*)捕获。
2.二级过滤:
title="(.*[院心部])*)" 用于获取title属性双引号内的具体信息。
法二:
优化后一次性过滤:
<li><a href="/[^/].*/" rel="external nofollow" rel="external nofollow" target="_blank" title="(.*)">
贴图片
开头是:
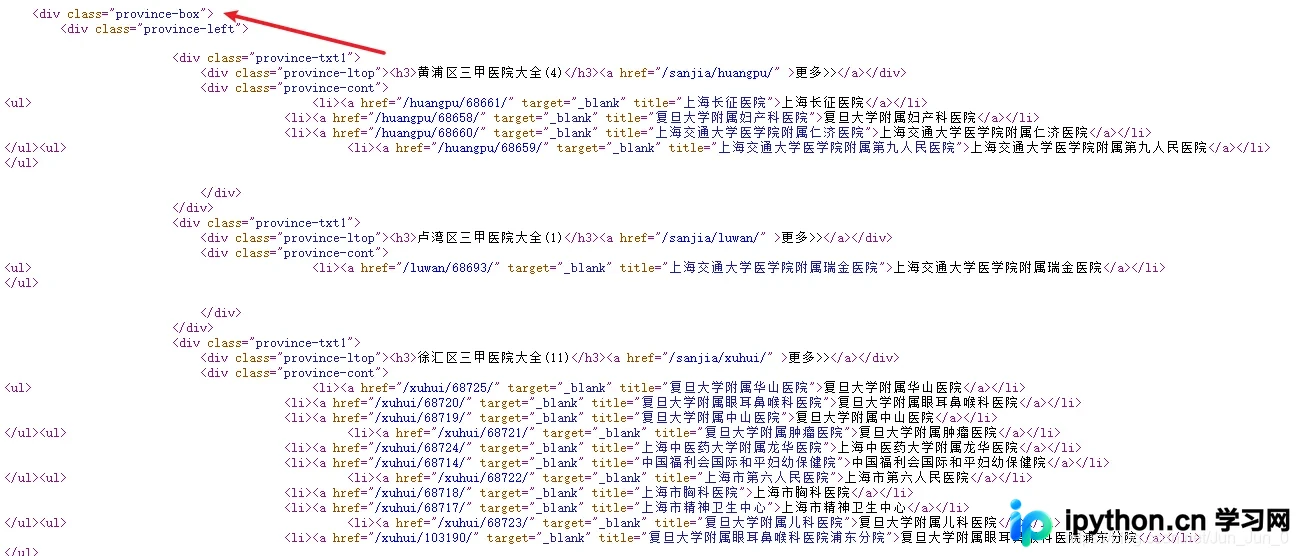
结尾是:
4.项目源代码
import requests
import re

url = "https://yyk.99.com.cn/sanjia/shanghai/"
# 模拟浏览器的访问
headers ={'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:87.0) '
                        'Gecko/20100101 Firefox/87.0'}
res = requests.get(url,headers=headers)

if res.status_code == 200:
	#1.获取网页源代码
    raw_text = res.text

    #2.正则表达式书写:
    #2.2注意:正则表达式默认匹配的是一行  我们的源代码是多行匹配的要加另一个参数 re.DOTALL
	#2.3正则法一:
		#re.findall() 返回的是lsit集合 一次过滤
    re_res = re.findall(r'<div class="province-box">(.*)<div class="wrap-right">', raw_text,re.DOTALL)
    	#re_res[0] 获取下标是的数据    二次过滤
    res=re.findall(r'title="(.*[院心部])*)"',re_res[0])
    	#检查打印获取到的信息
	print(res)

	#2.4正则法二:
		#(优化)不用二次过滤 一次过滤就解决了
    # re_list = re.findall(r'<li><a href="/[^/].*/" rel="external nofollow"  rel="external nofollow"  target="_blank" title="(.*)">', res.text)
    #print(re_list)

    # 写入文件中
    read = open("上海医院名单", "w", encoding='utf-8')
    for i in res:
        read.write(i)
        read.write("\n")
    read.close()
else:
    print("error")
项目目录:
部分结果:
python 正则表达式-提取图片地址
import os,sys,time,json,time
import socket,random,hashlib
import requests,configparser
import json,re
from datetime import datetime
from multiprocessing.dummy import Pool as ThreadPool


def getpicurl(url):
    url = "http://www.mzitu.com/zipai/comment-page-352"
    html = requests.get(url).text
    pic_url = re.findall('img src="(.*?)"',html,re.S)
    for key in pic_url:
        print(key + "\r\n")
    #print(pic_url)

getpicurl("http://www.mzitu.com/zipai/comment-pag.e-352")
输出结果:
python mmm.py http://wx3.sinaimg.cn/mw1024/9d52c073gy1fsvu6578k1j20sg15nk4x.jpg
http://wx1.sinaimg.cn/mw1024/9d52c073gy1fsvu64q4lgj20j60nz0ua.jpg
http://wx1.sinaimg.cn/mw1024/9d52c073gy1fsvu67hhbaj20sg110toc.jpg
http://wx2.sinaimg.cn/mw1024/9d52c073gy1fsvu66bw56j20sg0zjtlr.jpg
http://wx1.sinaimg.cn/mw1024/9d52c073gy1fsvu65vvvtj20sg0mmtfc.jpg
http://wx2.sinaimg.cn/mw1024/9d52c073gy1fsvu66gtnzj20sg0zk48h.jpg
http://wx1.sinaimg.cn/mw1024/9d52c073gy1fsvu65q1qyj20sg11vtmo.jpg
http://wx3.sinaimg.cn/mw1024/9d52c073gy1fsvu64wgejj20e60iwtax.jpg
http://wx1.sinaimg.cn/mw1024/9d52c073gy1fsvu66a8xfj20lt0rptgw.jpg
http://wx4.sinaimg.cn/mw1024/9d52c073gy1fsnr6n7n66j20k00ozn52.jpg
http://wx1.sinaimg.cn/mw1024/9d52c073gy1fsnr6njhjyj20sg0zkn88.jpg
http://wx3.sinaimg.cn/mw1024/9d52c073gy1fsnr6n2zmyj20sg0ldten.jpg
总结
到此这篇关于Python如何利用正则表达式爬取网页信息及图片的文章就介绍到这了,更多相关Python正则表达式爬取内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









