

Python爬虫实现美剧资源批量抓取与保存

本文介绍如何使用Python编写爬虫程序,自动抓取美剧网站上的所有剧集下载链接。通过遍历URL编号、利用status_code过滤无效页面,并结合正则表达式提取ed2k链接,最终将结果按剧名保存为txt文件。文章还探讨了文件命名中的特殊字符处理及多线程在Python GIL限制下的实际效果。
保持观看美剧的习惯,既能锻炼英语听力,也能打发闲暇时光。此前,视频网站还能提供在线播放服务,但受广电总局相关管理规定影响,进口的美剧和英剧不再像过去那样同步更新。然而,对于不愿追剧的我来说,这并非不可克服的障碍。经过网络搜索,我发现了一个支持迅雷下载的美剧资源站【天天美剧】,上面提供了丰富的下载资源。近期,我还迷上了BBC制作的高清自然纪录片,画面精美,令人赏心悦目。
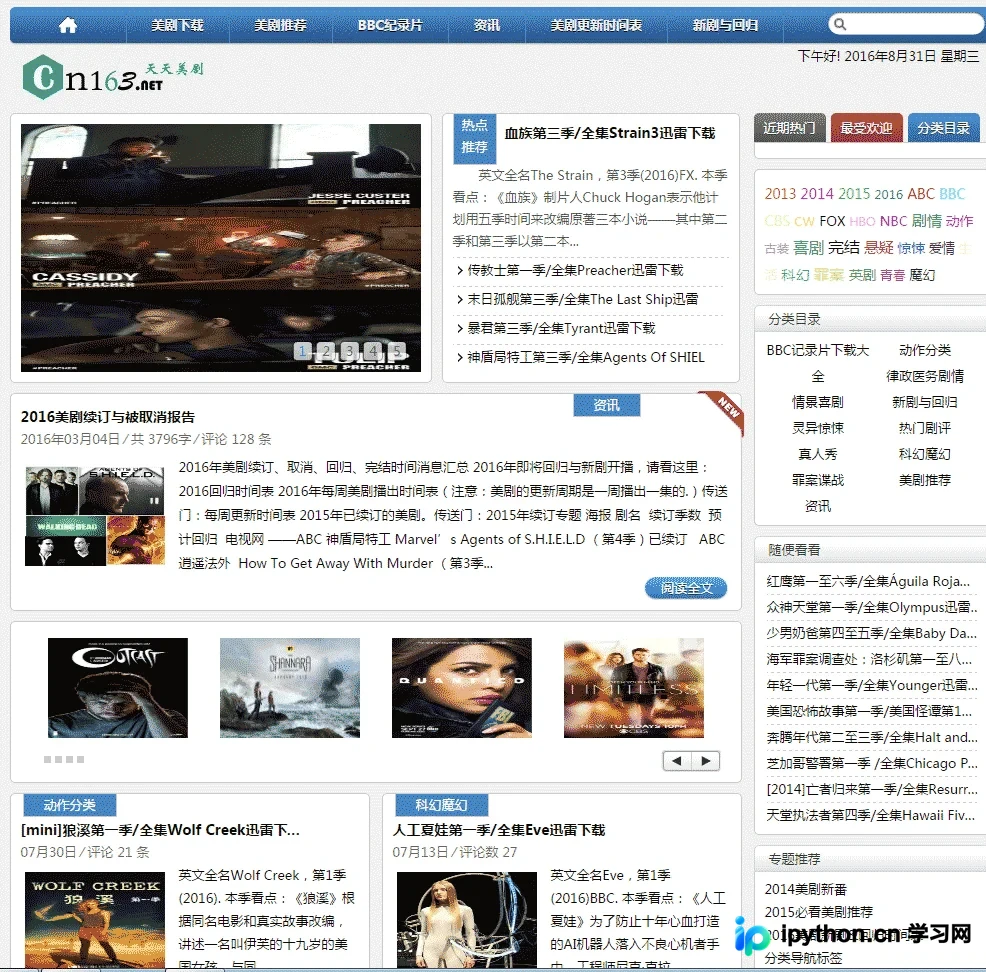
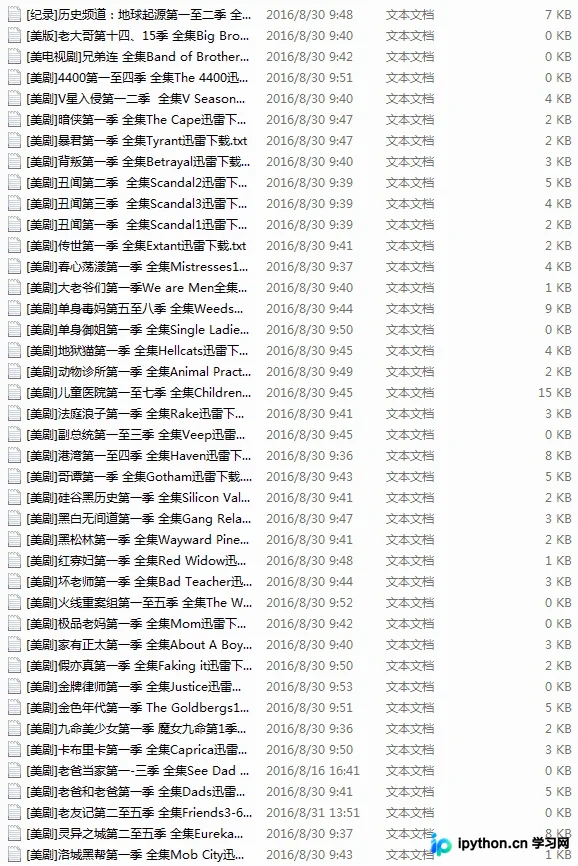
虽然找到了资源网站,但每次下载都需要手动打开浏览器、输入网址、寻找特定剧集并点击下载链接。这一过程繁琐且耗时,加之网站链接偶尔无法访问,体验并不理想。鉴于我一直在学习Python爬虫技术,于是决定动手编写一个爬虫程序,旨在抓取该网站上所有的美剧链接,并将其保存至文本文档中。这样,用户只需打开文档,复制所需的链接到迅雷即可进行下载,极大简化了操作流程。
起初,我计划采用一种递归式的爬取策略:从主页出发,发现一个URL便使用requests库打开并抓取下载链接,试图覆盖全站。然而,该网站存在大量重复链接,且其URL结构并不像我预期的那样规则。经过多次尝试,我未能构建出理想的发散式爬虫逻辑,或许是因为技术积累尚浅。尽管如此,这仍是一个继续学习和努力的过程。
随后,我注意到电视剧的下载链接均位于文章内部,而文章的URL末尾包含一个数字编号,例如http://cn163.net/archives/24016/。基于这一发现,我借鉴了之前的爬虫经验,采取了一种更高效的解决方案:通过自动生成URL来遍历网站。既然URL末尾的数字是变化的,且每部剧对应唯一的编号,我便尝试估算文章的大致数量,并利用Python的range函数连续生成数字,从而构造出完整的URL序列。
在遍历过程中,许多URL实际上并不存在,直接访问会导致程序报错。对此,我们利用requests库自带的status_code属性来判断请求返回的状态。对于返回状态码为404的URL,我们直接跳过;而对于其他状态的URL,则进入页面进行链接爬取。这一机制有效解决了无效URL导致程序中断的问题。
以下是上述步骤的具体实现代码。
def get_urls(self):
  try:
    for i in range(2015,25000):
      base_url='http://cn163.net/archives/'
      url=base_url+str(i)+'/'
      if requests.get(url).status_code == 404:
        continue
      else:
        self.save_links(url)
  except Exception,e:
    pass
后续流程进展较为顺利。我在网上参考了前人编写的类似爬虫,但那些代码仅能爬取单篇文章,因此我借鉴了其正则表达式部分。虽然我也尝试使用BeautifulSoup库,但发现其效果不如正则表达式理想,故果断放弃。此外,当前抓取效果并非完美,约有半数左右的链接未能正确抓取,后续仍需进一步优化算法。
# -*- coding:utf-8 -*-
import requests
import re
import sys
import threading
import time
reload(sys)
sys.setdefaultencoding('utf-8')
class Archives(object):

  def save_links(self,url):
    try:

      data=requests.get(url,timeout=3)
      content=data.text
      link_pat='"(ed2k://\|file\|[^"]+?\.(S\d+)(E\d+)[^"]+?1024X\d{3}[^"]+?)"'
      name_pat=re.compile(r'<h2 class="entry_title">(.*?)</h2>',re.S)
      links = set(re.findall(link_pat,content))
      name=re.findall(name_pat,content)
      links_dict = {}
      count=len(links)
    except Exception,e:
      pass
    for i in links:
      links_dict[int(i[1][1:3]) * 100 + int(i[2][1:3])] = i#把剧集按s和e提取编号
    try:
      with open(name[0].replace('/',' ')+'.txt','w') as f:
        print name[0]
        for i in sorted(list(links_dict.keys())):#按季数+集数排序顺序写入
          f.write(links_dict[i][0] + '\n')
      print "Get links ... ", name[0], count
    except Exception,e:
      pass

  def get_urls(self):
    try:
      for i in range(2015,25000):
        base_url='http://cn163.net/archives/'
        url=base_url+str(i)+'/'
        if requests.get(url).status_code == 404:
          continue
        else:
          self.save_links(url)
    except Exception,e:
      pass
  def main(self):
    thread1=threading.Thread(target=self.get_urls())
    thread1.start()
    thread1.join()
  if __name__ == '__main__':
  start=time.time()
  a=Archives()
  a.main()
  end=time.time()
  print end-start
完整代码中使用了多线程技术,但考虑到Python的全局解释器锁(GIL)机制,多线程的实际加速效果有限。尽管网站显示有两万多部剧集,本以为抓取过程会耗时良久,但排除掉无效URL和未匹配到的内容后,总抓取时间不到20分钟。原本我还考虑使用Redis在两台Linux服务器上分布式爬取,但经过尝试后发现并无必要,因此决定维持当前方案。若未来需要处理更大数据量,再考虑扩展架构。
在开发过程中,我还遇到了一个令人头疼的问题:文件名的保存规则。特此吐槽一下,txt文本格式的文件名允许包含空格,但严禁包含斜线、反斜线、括号等特殊字符。正是由于这个限制,我花费了大量时间排查。起初我误以为是数据抓取错误,经过仔细检查才发现,问题根源在于爬取的剧名中包含了斜杠符号,这给文件保存带来了巨大困扰。
本文作者:码农网 – 肖豪
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









