Python正则替换中处理匹配项后还原的两种实现方式
本文介绍在Python中使用正则表达式进行替换时,如何先对匹配到的内容进行特定处理(如转大写并反转),再将结果替换回原文。通过对比使用Lambda表达式和定义独立函数的两种实现方式,展示了re.sub函数的灵活用法,并附带了完整的代码示例与运行输出结果供参考。
2026-10-13
6

本文介绍在Python中使用正则表达式进行替换时,如何先对匹配到的内容进行特定处理(如转大写并反转),再将结果替换回原文。通过对比使用Lambda表达式和定义独立函数的两种实现方式,展示了re.sub函数的灵活用法,并附带了完整的代码示例与运行输出结果供参考。
本文介绍在Python中获取命令行执行结果并过滤所需信息的方法。以Windows系统为例,通过os.popen执行ipconfig命令,结合正则表达式精准提取本机物理地址(MAC)和IP地址,并展示完整代码与运行结果,供Python开发者参考。
本文系统讲解Python中正则表达式(Regular Expression)的基础用法。内容涵盖re模块中findall、search、match、split、sub等核心函数的功能与参数,详细解析元字符如点号、星号、加号、问号、方括号及圆括号的具体作用与贪婪/非贪婪匹配差异,帮助读者掌握文本处理与爬虫数据提取的关键技能。
本文提供基于Python的手机号归属地查询示例,通过读取包含手机号码的文本文件,利用urllib获取网页源码,并结合正则表达式解析归属地、运营商、区号及邮编等关键信息,最终将结果写入日志文件。
本文深入解析Python中正则表达式的核心概念,涵盖原始字符串定义、基础与预设元字符、边界与重复匹配、分组及贪婪与非贪婪模式。结合爬虫场景,详细演示如何利用re模块提取邮箱、处理相对路径及批量替换,助力开发者高效进行文本处理与数据抓取。
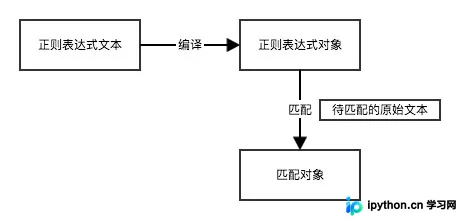
本文系统讲解Python中正则表达式的核心概念,涵盖原始字符串定义、基础与预设元字符、边界与重复匹配、逻辑分支及分组技巧。重点解析贪婪与非贪婪模式,并结合爬虫场景演示如何利用sub函数与正则表达式进行HTML标签处理与路径替换,帮助开发者高效处理文本提取与验证任务。
本文系统介绍了Python中正则表达式的基本用法。详细解析了re模块中的核心函数,包括match与search的区别、sub与subn的替换操作、findall与finditer的提取方式,以及split和escape辅助函数的应用。通过具体代码示例,帮助开发者掌握文本处理、日志分析及数据清洗中的正则技巧。
本文深入解析Python中正则表达式的应用,涵盖re模块的核心功能。从基础字符匹配、字符串切分到分组提取与贪婪匹配机制,结合具体代码示例,详细讲解如何高效处理文本验证、数据提取及复杂模式匹配,帮助开发者掌握正则表达式的强大能力。
本文详细介绍如何使用Python的urllib、urllib2及re模块实现网页信息抓取。通过解析百度贴吧示例,演示如何构建请求、处理多页URL、利用正则表达式提取标题与正文,并包含文件读写及异常处理的完整代码实现,适合Python初学者参考。
本文介绍使用Python正则表达式从网页中提取新闻标题及链接的具体实现方法。通过urllib获取页面内容,利用正则匹配特定HTML结构,并对提取结果进行字符串替换处理,最终将标题和链接保存至本地文件。
本文介绍使用Python正则表达式抓取网易新闻评论的方法。通过抓包工具定位隐藏评论接口,利用urllib2发起请求并获取HTML数据,再经正则处理提取JSON中的评论字段。代码包含分页处理、异常捕获及文件写入逻辑,适合Python初学者参考正则在爬虫中的应用。