

Python中文正则表达式匹配实战:从纯真库到IP138数据解析

本文详细介绍如何在Python中使用中文正则表达式匹配指定中文字符串。针对GBK与UTF-8编码差异,推荐统一使用UTF-8编码以确保匹配准确性。通过两个实际案例:从纯真数据库解析省市县信息,以及从IP138网站提取ISP数据,展示了懒惰匹配和Unicode处理的关键技巧。
本文介绍了一种在Python中利用中文正则表达式精确匹配指定中文字符串的方法,旨在为相关开发者提供实用的参考方案。
应用场景背景:
核心需求是从包含中文的文本中精准提取特定的子字符串。此类需求在实际开发中极为常见,本文对此类场景进行了系统的梳理与总结。
技术难点分析:
主要挑战在于处理GBK和UTF-8等不同字符编码,尤其是在正则表达式模式(Pattern)中包含汉字时,必须谨慎处理以确保匹配正常。强烈建议统一采用UTF-8编码;若无法统一,则需根据具体情况采取相应的处理策略。
一个通用且高效的正则表达式能够显著简化代码逻辑,提升处理效率,这也是区分资深开发者与初级开发者的关键因素之一。
案例一:
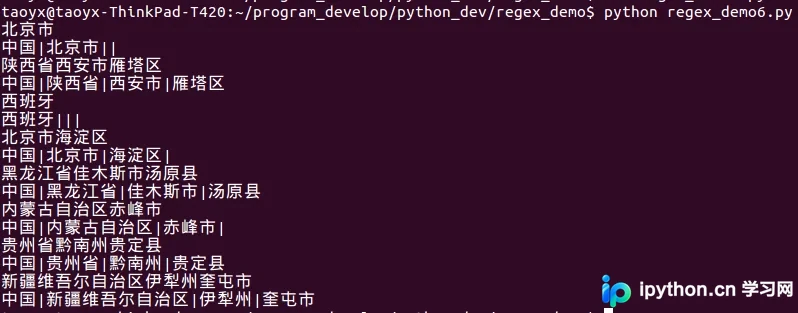
本例展示了如何从QQ纯真IP数据库中解析出省、市、县等特定地理信息。所使用的正则表达式基本能满足该业务场景,其中“懒惰匹配”(使用?符号)至关重要,若处理不当可能导致结果偏差。具体细节建议读者结合代码深入理解。 核心代码如下:
#!/usr/bin/env python
#encoding: utf-8
#description: 从字符串中提取省市县等名称,用于从纯真库中解析解析地理数据
import re
import sys
reload(sys)
sys.setdefaultencoding('utf8')
#匹配规则必须含有u,可以没有r
#这里第一个分组的问号是懒惰匹配,必须这么做
PATTERN = \
ur'([\u4e00-\u9fa5]{2,5}?(?:省|自治区|市))([\u4e00-\u9fa5]{2,7}?(?:市|区|县|州)){0,1}([\u4e00-\u9fa5]{2,7}?(?:市|区|县)){0,1}'
data_list = ['北京市', '陕西省西安市雁塔区', '西班牙', '北京市海淀区', '黑龙江省佳木斯市汤原县', '内蒙古自治区赤峰市',
'贵州省黔南州贵定县', '新疆维吾尔自治区伊犁州奎屯市']
for data in data_list:
 data_utf8 = data.decode('utf8')
 print data_utf8
 country = data
 province = ''
 city = ''
 district = ''
 #pattern = re.compile(PATTERN3)
 pattern = re.compile(PATTERN)
 m = pattern.search(data_utf8)
 if not m:
  print country + '|||'
  continue
 #print m.group()
 country = '中国'
 if m.lastindex >= 1:
  province = m.group(1)
 if m.lastindex >= 2:
  city = m.group(2)
 if m.lastindex >= 3:
  district = m.group(3)
 out = '%s|%s|%s|%s' %(country, province, city, district)
 print out
程序运行结果截图
案例二:
本例演示如何从IP138网站获取指定IP地址的地理位置及相关信息。
IP138是常用的IP查询平台。为了获取每个IP对应的ISP(互联网服务提供商)信息,需要对该网站页面进行解析。
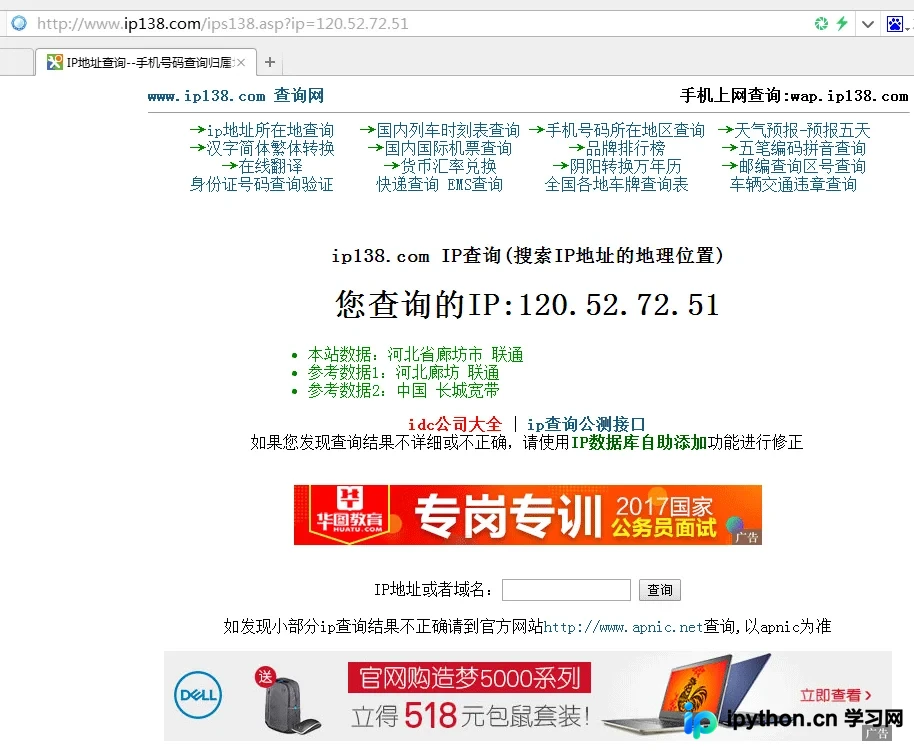
经搜索发现,IP138并未提供返回JSON格式的标准API接口,因此只能通过解析HTML页面来获取数据。虽然使用DOM解析指定div标签是常规思路,但效率较低。更简洁高效的方式是利用中文正则表达式,直接从返回的HTML中提取“本站主数据:”后的关键信息。
以下是经过测试验证的实现代码:
#!/usr/bin/env python
#encoding: utf-8
#date: 2016-03-31
#note: 测试中遇到的问题,请求指定的链接会有超时现象,可以多请求几次
import requests, re
import sys
reload(sys)
sys.setdefaultencoding('utf8')
IP138_API = 'http://www.ip138.com/ips138.asp?ip='
PATTERN = ur'<li>本站主数据:(.*?)</li>'
def query_api(url):
 data = ''
 r = requests.get(url)
 if r.status_code == 200:
  data = r.content
 return data
def parse_ip138(html):
 #只能是unicode编码,不能在后面再转换为utf-8,否则无法正则匹配上.
 html = unicode(html, 'gb2312')
 #html = unicode(html, 'gb2312').encode('utf-8')
 #print html
 pattern = re.compile(PATTERN)
 m = pattern.search(html)
 if m:
  print m.group(1)
 else:
  print 'regex match failed'
if __name__ == '__main__':
 url = IP138_API + '14.192.60.0'
 resp = query_api(url)
 if not resp:
  print 'no content'
 parse_ip138(resp)
代码运行效果截图

补充说明:以下提供两款实用的正则表达式在线工具供参考:
JavaScript正则表达式在线测试工具: http://tools.jb51.net/regex/javascript
正则表达式在线生成工具: http://tools.jb51.net/regex/create_reg
如需了解更多Python相关知识,可参考本站系列教程:《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python Socket编程技巧总结》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》以及《Python文件与目录操作技巧汇总》。
希望上述内容能对各位Python程序员的开发工作有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









