Python爬虫实战:解析某婚恋网站征婚数据抓取流程
本文详细演示如何使用Python抓取某婚恋网站的公开征婚数据。通过浏览器开发者工具分析页面加载机制,确定采用同步加载处理方式。文章逐步解析URL规律、构造请求头、利用XPath提取关键信息,并完整展示数据保存至CSV文件的代码实现,为初学者提供清晰的爬虫开发思路。
2026-10-14
3

本文详细演示如何使用Python抓取某婚恋网站的公开征婚数据。通过浏览器开发者工具分析页面加载机制,确定采用同步加载处理方式。文章逐步解析URL规律、构造请求头、利用XPath提取关键信息,并完整展示数据保存至CSV文件的代码实现,为初学者提供清晰的爬虫开发思路。
本文介绍使用Python编写的影视网站资源抓取工具,通过requests和re模块解析网页结构,结合多线程与并发处理提升效率。代码包含自定义请求头、Cookie管理及正则提取逻辑,支持批量获取指定影视内容的下载链接,适合对Python爬虫感兴趣的用户参考学习。
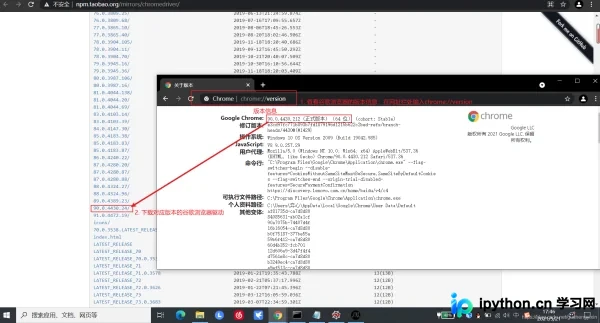
本文详细讲解Python中Selenium库的安装方法及Chrome浏览器驱动的下载与配置步骤。通过版本匹配检查和代码示例,演示如何利用Selenium控制浏览器进行网页数据抓取,帮助开发者快速搭建爬虫环境。
本文详细讲解如何使用Python爬取爱奇艺热门电影列表。通过分析目标网页结构,利用requests和BeautifulSoup库解析HTML,提取电影名称与链接。教程涵盖环境配置、代码实现及结果验证,帮助开发者掌握基础爬虫技巧,快速获取影视资源信息。
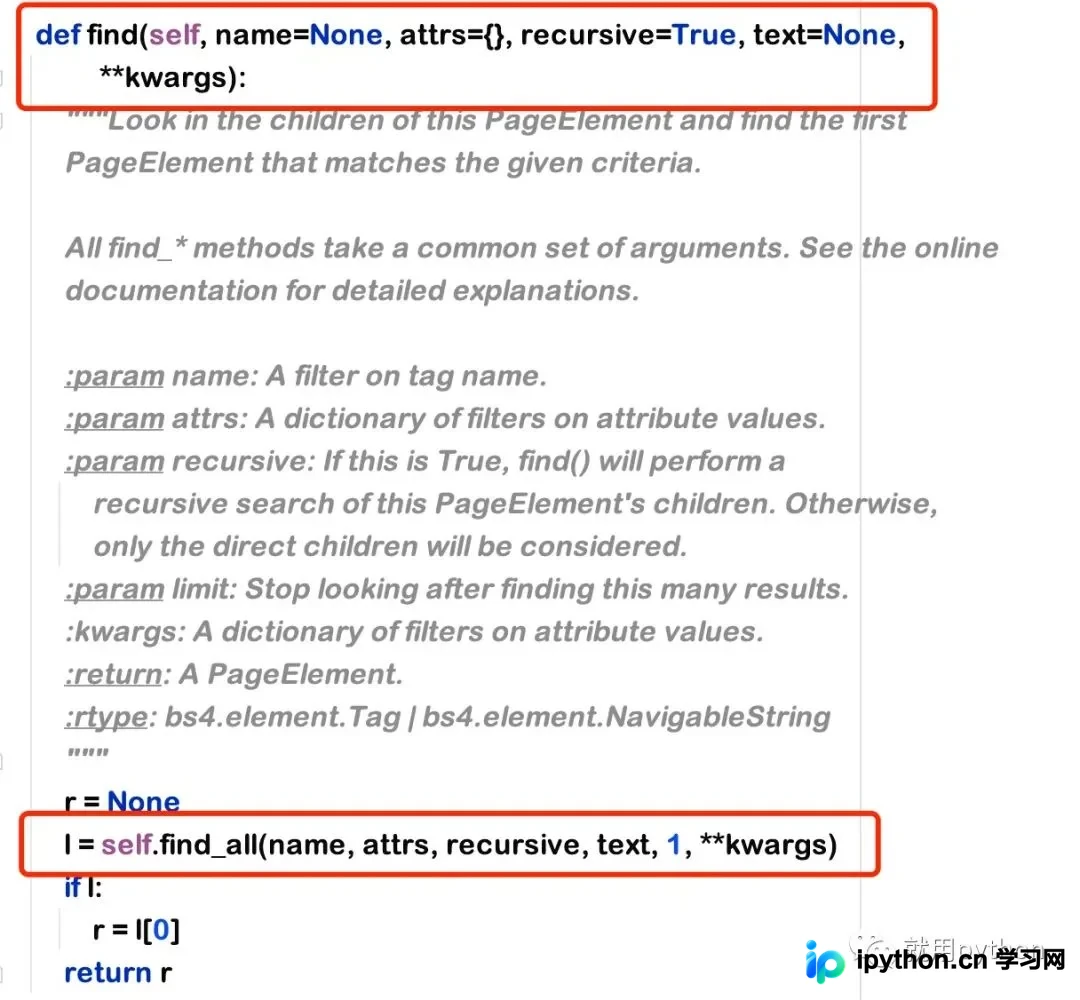
本文详细解析Python爬虫开发中的关键技巧,涵盖网络请求阶段的HTTPError与URLError异常处理,以及BeautifulSoup解析HTML时的NoneType错误防御。深入讲解find与find_all方法的区别、参数配置(如limit、recursive)及属性过滤技巧,通过豆瓣电影数据抓取实例,展示如何高效获取特定标签文本并处理常见编码问题,帮助开发者提升爬虫稳定性与数据提取精度。
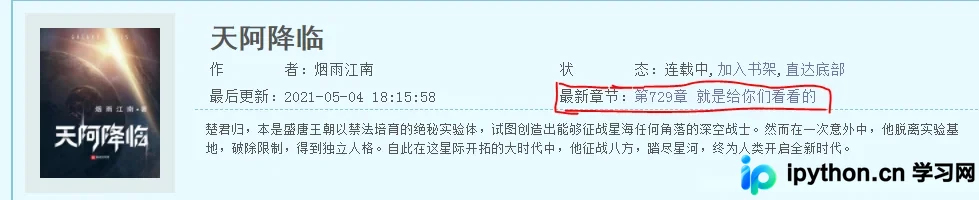
本文介绍如何使用Python爬虫技术,通过模拟百度搜索请求解析搜索结果页面,提取小说最新章节链接。程序结合访问耗时计算权重,自动筛选出更新最快且响应速度最优的前5个网站链接,解决手动查找小说更新慢、网站打开困难的问题,并提供完整代码实现与案例演示。
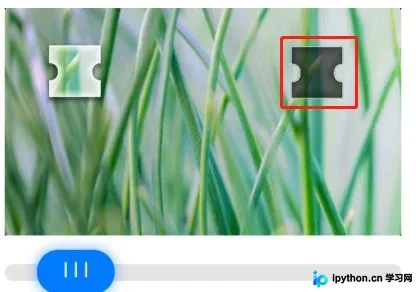
本文详解如何使用Python结合OpenCV与Selenium破解常见的滑动图片验证码。通过高斯模糊去噪、Canny边缘检测及轮廓筛选,精准定位缺口坐标,最终实现自动化拖动验证,有效应对初级反爬机制。
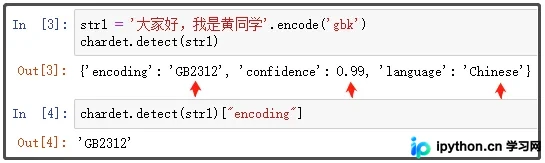
本文详细介绍Python中chardet库的安装方法及核心用法。针对爬虫中常见的网页编码不一致导致的乱码问题,讲解如何利用chardet.detect()函数自动检测字符串或网页源码的编码格式(如GBK、UTF-8等)。通过百度网页抓取实例,演示如何结合requests库动态设置编码,从而高效解决乱码难题,提升数据抓取成功率。
本文介绍Python爬虫中常见的反爬机制及应对策略。通过requests库发起请求时,若未设置User-Agent,服务器可能识别为爬虫并拒绝访问。文章详细演示了如何获取浏览器的User-Agent值,并在代码中通过headers字典进行UA伪装,从而成功抓取特定网页数据。
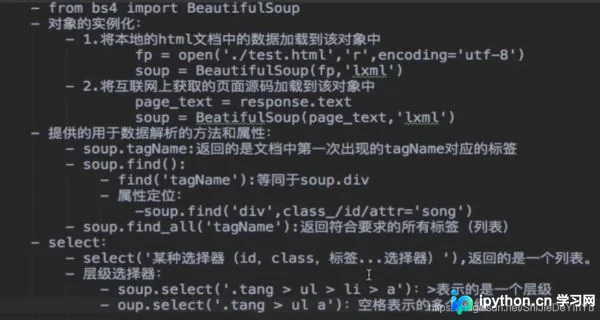
本文详细介绍Python中Bs4库的安装方法及数据解析技巧。通过pip安装bs4和lxml后,结合requests库实现图片批量下载与文本内容爬取。文章提供完整代码示例,涵盖UA伪装、URL遍历及文件存储操作,帮助开发者快速掌握Bs4在爬虫中的应用。
本文介绍Python爬虫的基础流程,包括指定URL、发送请求及数据存储三步。详细讲解requests外部库的安装方法,并通过完整代码示例演示如何爬取搜狗首页并保存为HTML文件,帮助初学者快速掌握网络数据抓取的基本操作。
本文详细介绍如何使用Python的Requests和BeautifulSoup库编写爬虫程序,从笔趣阁网站抓取小说列表及正文内容。重点解决编码乱码问题,并通过DOM解析提取章节链接与文本,最终实现小说文件的自动保存。