

Python Selenium库安装与浏览器驱动配置详解

发布时间:2026-10-14| 6人浏览过
本文详细讲解Python中Selenium库的安装方法及Chrome浏览器驱动的下载与配置步骤。通过版本匹配检查和代码示例,演示如何利用Selenium控制浏览器进行网页数据抓取,帮助开发者快速搭建爬虫环境。
在Python环境中使用Selenium之前,首要任务是完成该库的安装。
与Python生态中的其他第三方库一致,Selenium必须经过安装步骤才能被调用。
pip install selenium # Windows电脑安装selenium

pip3 install selenium # Mac电脑安装selenium
接下来需要下载与浏览器版本匹配的驱动程序,并将其放置在合适的位置。
Selenium脚本能够操控市面上常见的各类浏览器,但在正式使用前,必须预先安装对应浏览器端的驱动程序。
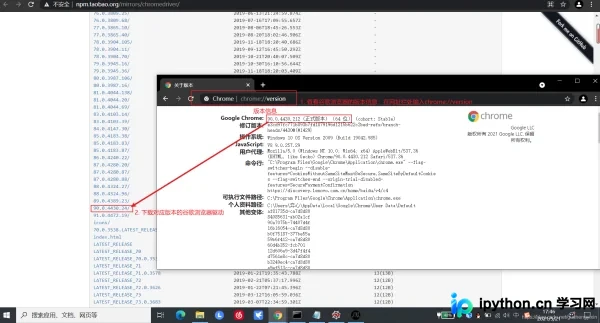
需要特别注意:所下载的驱动程序版本必须与本地安装的浏览器版本严格对应,否则可能导致运行失败。
建议优先使用Chrome浏览器,并前往官方渠道下载对应的ChromeDriver。
启动Chrome浏览器,在地址栏输入chrome://version/以访问版本信息页面,根据页面上显示的版本号下载相匹配的Chrome驱动。
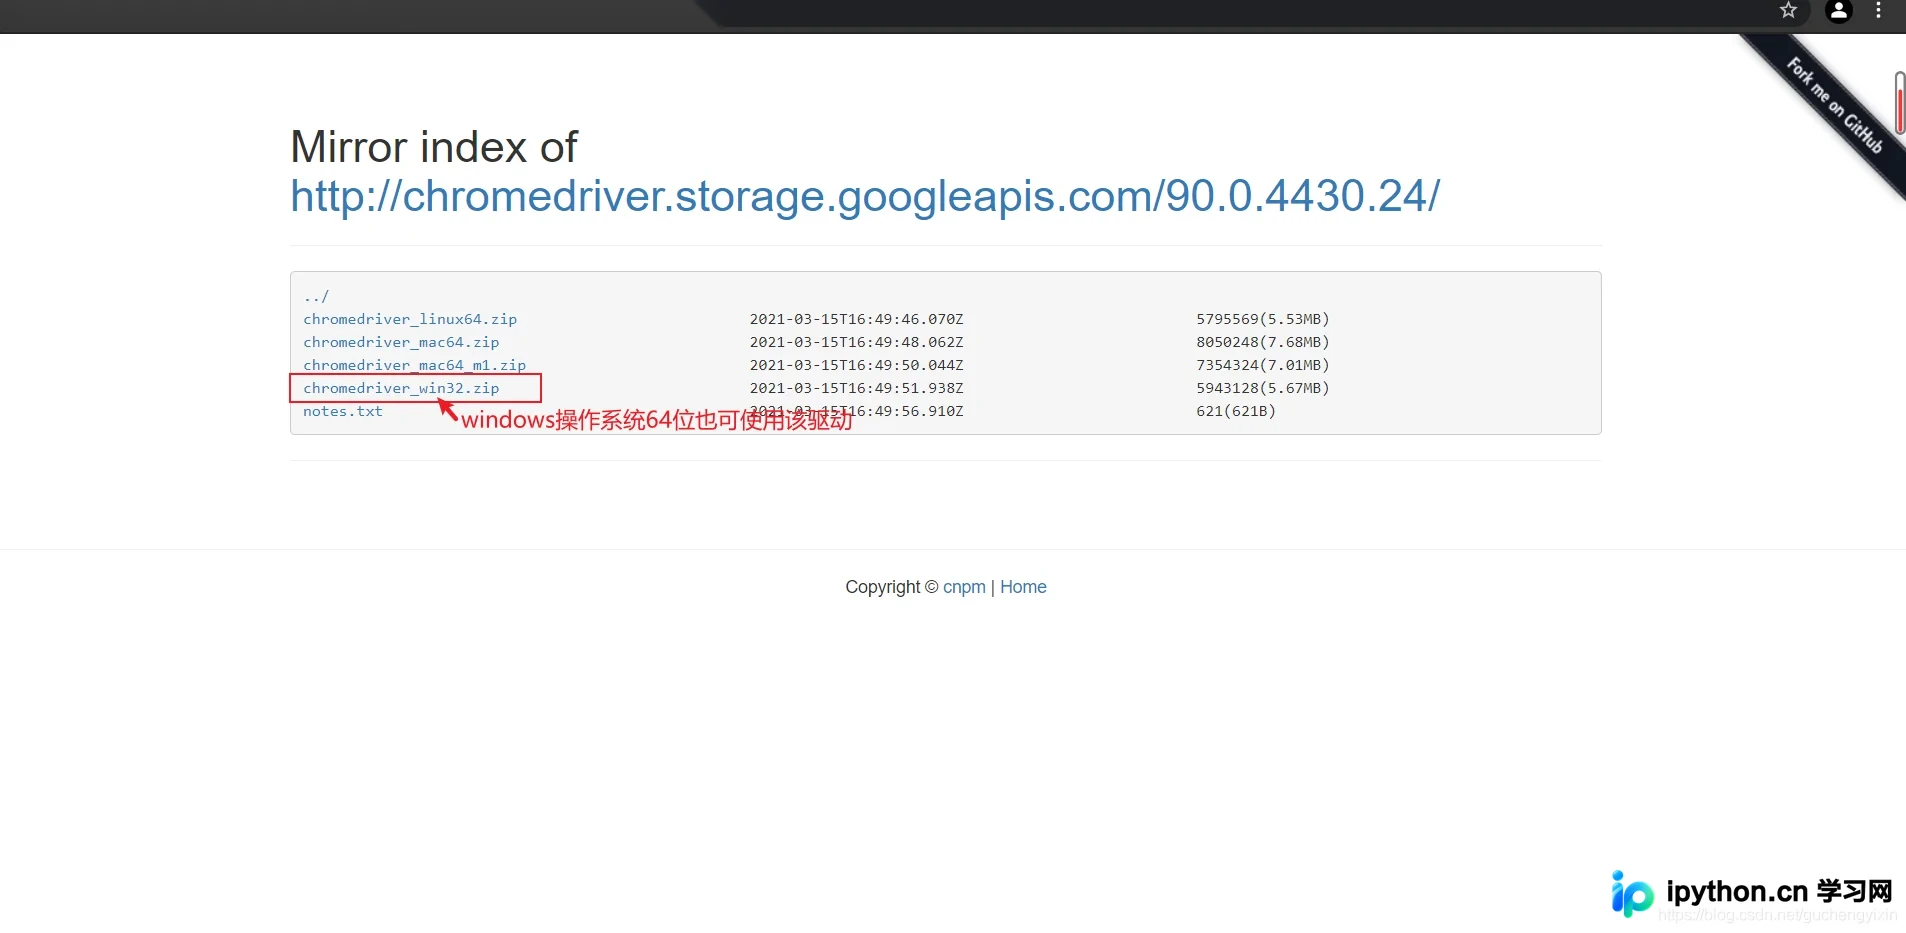
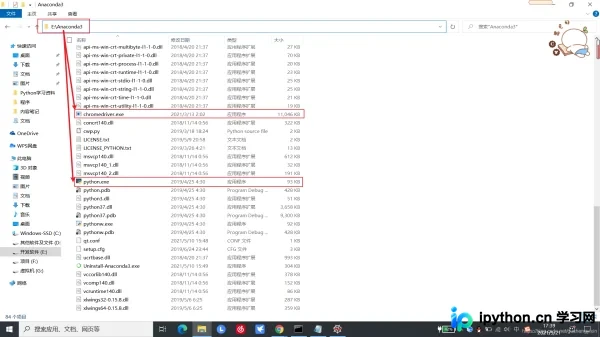
将下载好的驱动程序放置于Python的安装目录下(例如,若Python集成在Anaconda3环境中,则需放入Anaconda3的相关目录)。
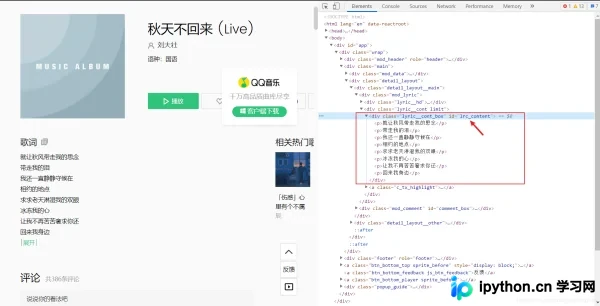
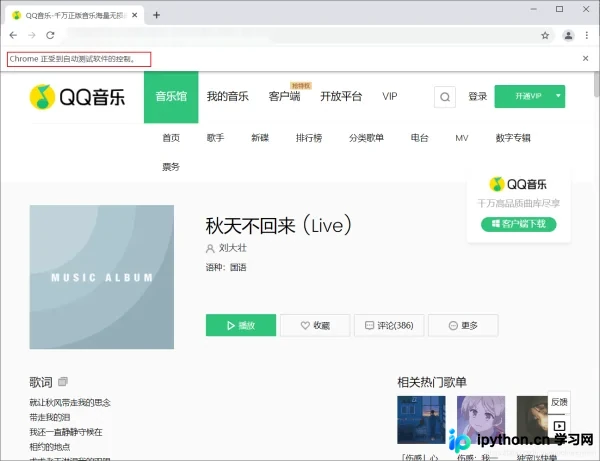
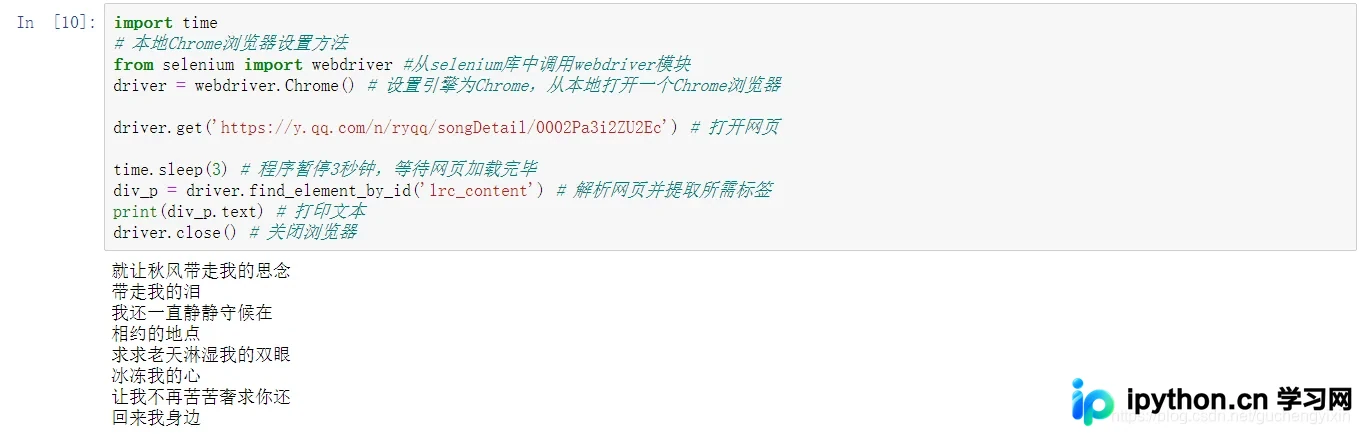
最后,通过一个简单示例展示如何使用Selenium爬取QQ音乐歌词。
import time
# 本地Chrome浏览器设置方法
from selenium import webdriver #从selenium库中调用webdriver模块
driver = webdriver.Chrome() # 设置引擎为Chrome,从本地打开一个Chrome浏览器

driver.get('https://y.qq.com/n/ryqq/songDetail/0002Pa3i2ZU2Ec') # 打开网页

time.sleep(3) # 程序暂停3秒钟,等待网页加载完毕
div_p = driver.find_element_by_id('lrc_content') # 解析网页并提取所需标签
print(div_p.text) # 打印文本
driver.close() # 关闭浏览器
至此,关于Python爬虫中Selenium库的安装及使用教程介绍完毕。如需了解更多关于Selenium库的安装与使用内容,建议搜索本站往期文章或继续浏览后续相关教程,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









