

Python爬虫防封IP实战技巧:UA、代理与Cookie策略

本文详解Python爬虫应对网站反爬机制的多种策略。通过随机化User-Agent、设置随机请求间隔、复用浏览器Cookie以及轮换代理IP,可有效降低被封禁风险。文中提供具体代码示例及GitHub相关项目参考,帮助开发者在大数据量爬取时保持连接稳定。
Python爬虫防IP封禁策略概述
在进行数据爬取时,许多目标网站部署了反爬虫机制,导致请求者极易遭遇IP被封禁的情况,从而中断数据采集任务。特别是在处理大规模数据抓取时,这种风险尤为显著,开发者往往需要时刻警惕IP被封锁的可能性。
针对上述问题,本文整理了一系列应对方案。这些策略既可以独立使用,也能组合应用以增强防护效果,从而提升爬虫的稳定性和成功率。
伪造User-Agent模拟浏览器
伪造User-Agent
一种常见做法是在HTTP请求头中将User-Agent字段修改为浏览器的标准标识,以此模拟浏览器访问行为。例如:
headers ={'User-Agent':'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/52.0.2743.116 Safari/537.36'} resp = requests.get(url,headers = headers)
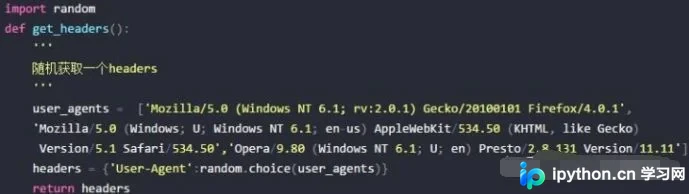
为了进一步提升安全性,建议预先收集多种浏览器的User-Agent字符串,并在每次发起请求时从中随机选取一个使用。这种随机化策略能有效降低被识别为自动化脚本的概率。
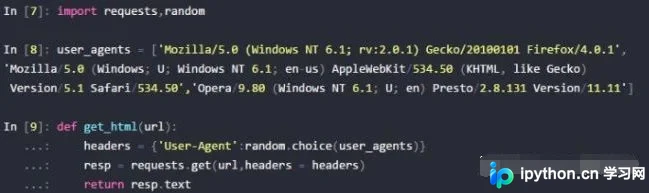
可以将上述随机选择User-Agent的逻辑封装为一个独立函数,以便在爬虫代码中重复调用:
设置随机请求间隔
在连续发起爬取请求的间隙,引入随机时间间隔是避免触发频率限制的有效手段。
例如:
time.sleep(random.randint(0,3)) # 暂停0~3秒的整数秒,时间区间:[0,3]或:
time.sleep(random.random()) # 暂停0~1秒,时间区间:[0,1)复用浏览器Cookie技巧
伪造cookies
如果通过浏览器可以正常访问目标页面,可以直接提取并复用该页面的Cookie信息来发起请求。具体操作示例如下:
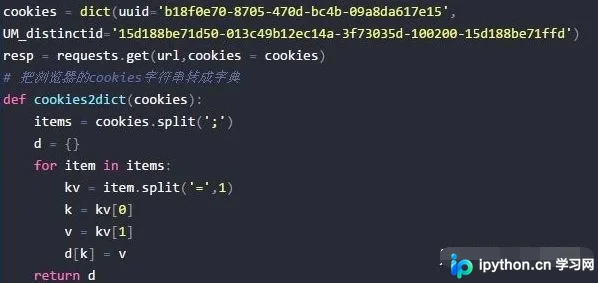
需要注意的是,即使使用了浏览器Cookie,若请求频率过高仍可能触发IP封禁。此时,建议在浏览器端完成相应的人工验证(如点击验证码图片等),验证通过后即可继续使用该Cookie发起后续请求。
轮换代理IP地址
使用代理
通过轮换使用多个代理IP地址进行访问,可以避免单一IP因发起过多请求而被封禁。具体实现示例如下:
相关开源项目推荐
附:GitHub上的一个"反反爬虫"项目
正如“道高一尺,魔高一丈”,面对网站的反爬措施,开发者也有相应的对抗手段。GitHub上有一位开发者专门整理了一个名为Anti-Anti-Spider的项目,旨在帮助爬虫应对各种反爬机制。感兴趣的研究者可以访问链接:github.com/luyishisi/An 进行深入了解。
以上便是关于Python爬虫防止IP被封禁的详细技巧。如需获取更多相关资源,请持续关注本站发布的其他技术文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









