Python新手必学的10个核心库:从Requests到Pandas入门指南
专为Python初学者梳理的10个核心第三方库入门指南,涵盖Requests、Pandas、NumPy、BeautifulSoup等高频库的适用场景、核心用法、示例代码与避坑要点。
2026-10-11
7

专为Python初学者梳理的10个核心第三方库入门指南,涵盖Requests、Pandas、NumPy、BeautifulSoup等高频库的适用场景、核心用法、示例代码与避坑要点。
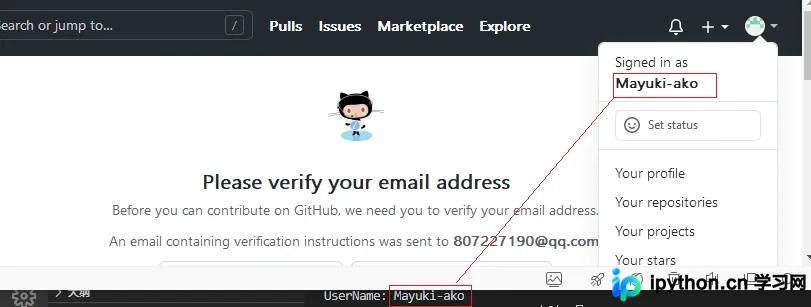
本文介绍如何使用 Python 的 requests 库模拟登录 GitHub。核心步骤包括:初始化 Session 保持状态、获取登录页的 CSRF Token、构造 POST 请求提交表单数据。代码展示了如何提取 authenticity_token 并处理登录响应,适用于学习 Web 自动化与爬虫基础。
本文详细介绍 Python requests 模块的标准用法与二次封装方法。通过基础示例掌握 GET/POST 请求与响应对象各属性的获取方式,结合第三方 retrying 库编写具备自动重试功能的 HTTP 请求类,提供稳定高效的 API 调用方案。
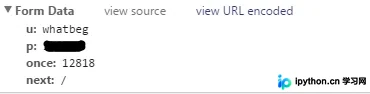
本文详细解析如何使用Python的requests.Session实现网站模拟登录。通过V2EX网站的登录流程为例,演示如何利用BeautifulSoup解析HTML获取动态参数(如once值),构建POST请求数据,并利用Session对象跨请求保持Cookie状态,最终验证登录成功。
本文介绍在Python3中使用requests库获取网页内容时,如何正确处理编码问题。通过设置r.encoding或r.apparent_encoding属性,可以有效解决网页乱码问题,并演示了将网页内容保存为本地文件的完整流程。
本文介绍如何使用 Python 第三方库 requests 快速构建 HTTP 请求,详细演示 GET 与 POST 请求的参数传递、响应属性读取,并针对 macOS 环境下多进程并发调用 requests 引发的崩溃问题提供了原理分析与实用规避方案。
本文深入解析 Python Requests 库处理 HTTP 响应时的编码机制,重点阐述 r.text 与 r.content 的区别。通过 r.encoding 属性手动指定编码(如 utf-8)解决中文乱码问题,并提供 bytes 转 str 的多种代码实现方案,帮助开发者快速定位并修复响应内容解码异常。
本文详细介绍如何在 Python 中使用 BeautifulSoup 库解析 HTML 网页。通过安装依赖、配置代理请求、结合 find 方法与 CSS 选择器提取标题、链接及指定元素文本,帮助开发者快速实现静态页面的自动化数据抓取与结构化处理。
本文详解Python爬虫中BeautifulSoup库的数据解析流程。从环境安装、对象实例化到标签定位(find/select)、文本提取及属性获取,结合三国演义小说爬取案例,演示如何解析列表页与详情页,实现指定内容的持久化存储。
本文详解Python爬虫中requests库发送POST请求的三种核心方式:Form表单、JSON数据及文件上传。通过httpbin.org测试接口,展示data与files参数的具体用法、Content-Type头部的自动处理及返回结果解析,帮助开发者掌握不同场景下的数据提交技巧。
针对网站频繁访问同一IP导致封禁的问题,本文详细说明如何通过requests库构建代理池、在HTTP请求中切换IP,并结合随机User-Agent、控制请求间隔与完善异常重试机制,有效提升Python数据采集任务的稳定性与存活率。
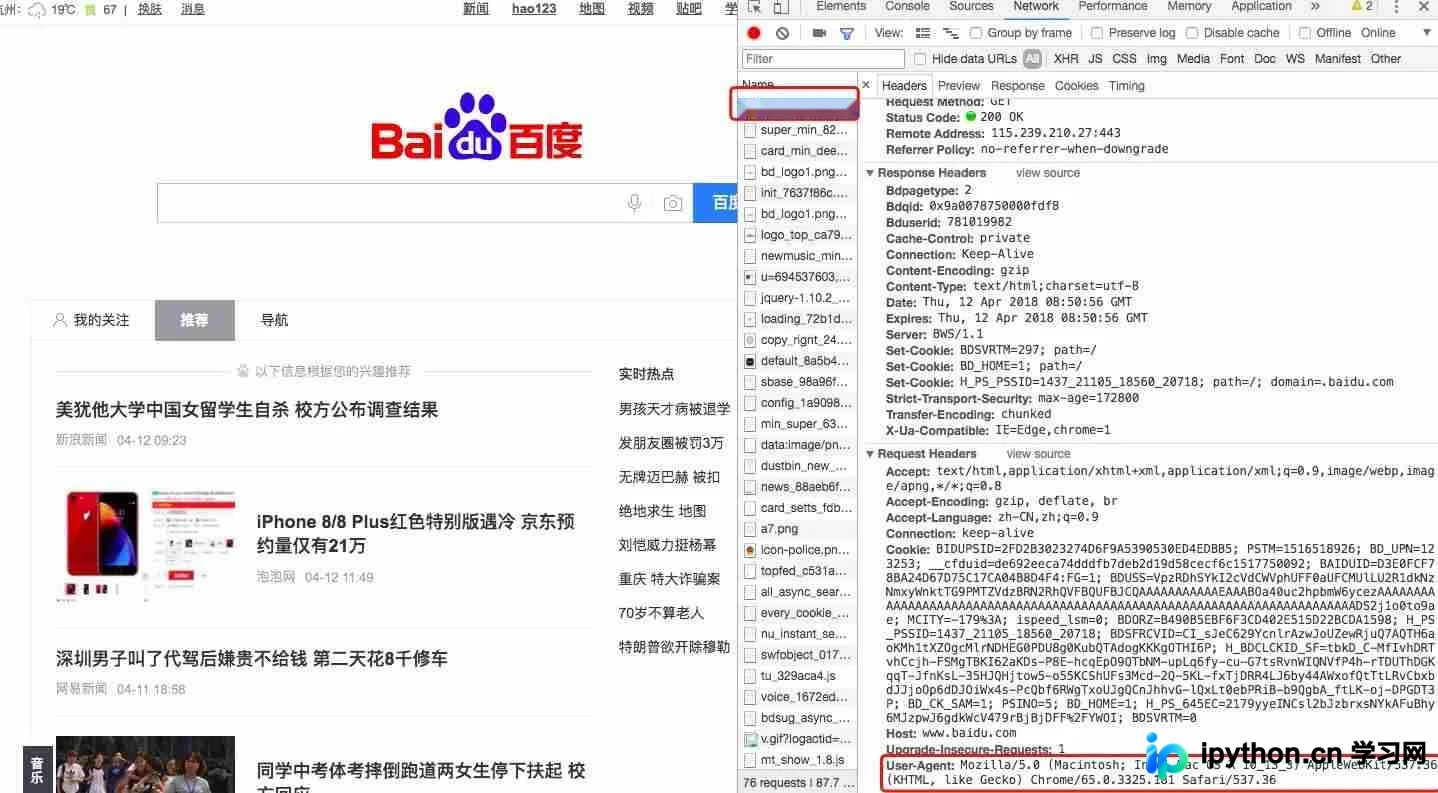
本文介绍如何利用Python的requests库通过伪装浏览器User-Agent来绕过网站的反爬机制。通过模拟真实浏览器的请求头(如Accept、Connection等),并随机切换User-Agent,可以有效防止IP被封禁,提高爬虫的稳定性和成功率。