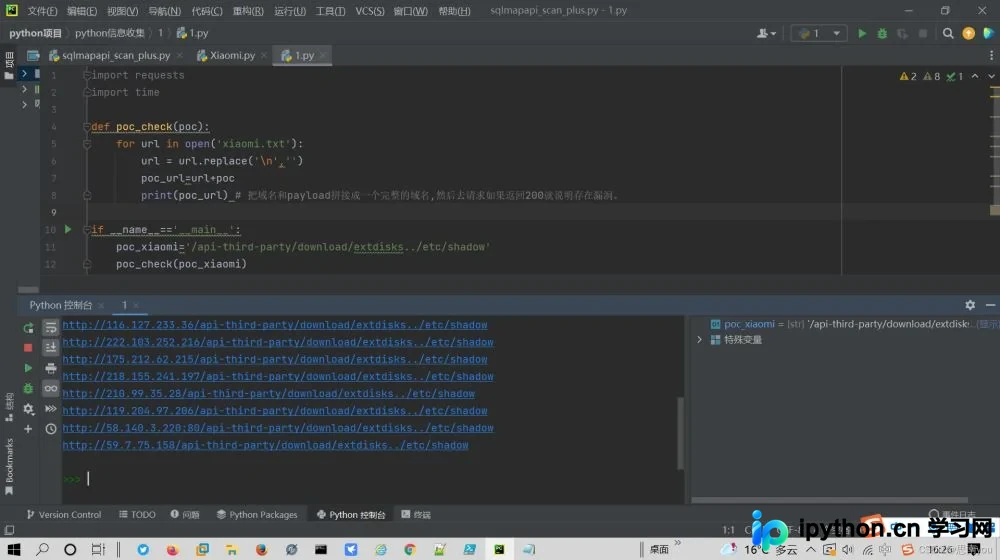
Python 编写漏洞验证脚本的核心逻辑与实现步骤
本文以实际目录穿越漏洞为例,详解如何使用 Python 标准库 requests 编写自动化漏洞验证脚本。通过逐行读取目标列表、拼接测试载荷、发送 HTTP 请求并匹配响应状态码,最终将存在风险的域名自动归档,帮助安全人员快速搭建批量检测流程。
2026-10-12
7

本文以实际目录穿越漏洞为例,详解如何使用 Python 标准库 requests 编写自动化漏洞验证脚本。通过逐行读取目标列表、拼接测试载荷、发送 HTTP 请求并匹配响应状态码,最终将存在风险的域名自动归档,帮助安全人员快速搭建批量检测流程。
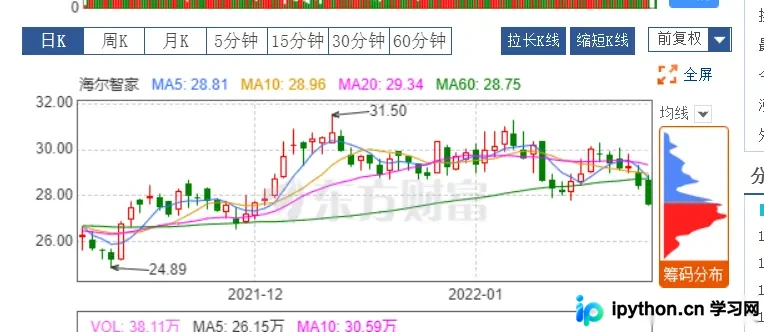
通过逆向分析东方财富行情页面的内部接口,本文介绍如何使用 Python 的 requests 库直接获取股票日线、周线等 K 线数据。文章详细拆解了 secid、klt、fqt 等核心参数的构造方法,并提供完整的请求与 JSON 解析代码,帮助开发者高效获取结构化金融时间序列数据。
在使用Python处理网络请求时,直接缓存全量响应会迅速耗尽系统内存。本文针对该痛点,利用requests的流式传输机制与分块读取技术,详细演示如何通过拦截服务端返回的Content-Length头信息,实时计算已下载占比。结合终端控制符循环刷新界面,最终输出平滑的动态进度条与实际运行耗时,兼顾稳定性与可视化效果。
简要说明使用 Python 结合 requests 和 BeautifulSoup 库,通过模拟请求与 HTML 解析,批量获取京东商城特定分类下商品详情页链接的方法。提供完整代码、运行条件及反爬注意事项,适合初学者掌握基础网页数据提取流程。
本文详解如何在Python中安全有效地模拟HTTP POST数据提交并自动处理Cookie。通过对比现代requests库与内置urllib模块的实操代码,展示自动维持登录状态、自定义请求头及参数编码的完整流程,帮助开发者快速适配Web接口调用需求。
本文基于Python 3与Requests库重构原版抓取逻辑,通过遍历MV编号区间、配置请求头伪装、正则表达式解析页面结构,并实现自动建目录与流式文件保存。针对静态页面解析瓶颈提供完整代码框架与异常处理方案,适用于学习网络请求与数据批量落盘的标准化流程。
本文详细介绍Python中requests模块的核心用法,涵盖基础GET请求发送、HTTP基本身份验证配置、响应头与信息提取,以及通过status_code和raise_for_status()进行错误处理的方法。同时补充POST、PUT等常用接口的调用技巧,助力开发者高效完成网络数据交互任务。
针对飞速中文网小说内容采用JavaScript加密及接口请求验证的情况,本文提供基于Python 3的自动化下载方案。结合Requests会话保持与LXML解析技术,通过模拟POST请求获取Base64编码数据并清洗Unicode转义符,最终将完整章节保存为文本文件。
本文演示如何使用现代Python工具编写网页爬虫,以豆瓣电影Top100为例,讲解构建URL地址池、伪造请求头、利用BeautifulSoup稳定解析HTML结构,并将提取到的电影名称与相关图片安全保存至本地。全文已修复原代码的版本缺陷,提供更可靠的执行逻辑与反爬规避建议。
本文深入解析Python requests库中text属性乱码的成因,并详细讲解如何通过content属性结合decode()方法进行手动解码。重点介绍了errors参数(strict、ignore、replace、xmlcharrefreplace)在应对非法字符时的不同处理策略,帮助开发者解决因编码不匹配导致的转码异常问题。
本文详细介绍如何使用Python快速获取服务器或本机的外网IP地址。通过调用稳定公开的HTTPS接口,结合requests库提取JSON响应字段,并提供完整的超时控制、异常捕获与标准库备选方案,适用于自动化运维、日志追踪及网络调试等实际开发场景。
本文以抓取公开课程列表为例,详解 Python 单线程爬虫的实现流程。通过观察网址翻页规律构造请求队列,利用 requests 获取 HTML 源码,并结合 re 模块的正则表达式精准剥离课程标题与参与人数,最后将结构化数据写入本地文本。该方法适用于静态页面的基础数据采集学习。