

结合Selenium与Requests实现网页登录及Cookie复用详解
本文详解如何利用Selenium模拟浏览器登录以获取完整Cookie,随后通过Requests库的Session对象复用这些凭证进行后续请求。文章提供了从配置Chrome选项、提取Cookie到构建Headers及随机User-Agent的完整代码示例,旨在解决需要登录态才能访问资源的爬虫场景,并指出了fake-useragent库在使用中可能存在的版本兼容问题。
2026-10-12
6

本文详解如何利用Selenium模拟浏览器登录以获取完整Cookie,随后通过Requests库的Session对象复用这些凭证进行后续请求。文章提供了从配置Chrome选项、提取Cookie到构建Headers及随机User-Agent的完整代码示例,旨在解决需要登录态才能访问资源的爬虫场景,并指出了fake-useragent库在使用中可能存在的版本兼容问题。
本文详细介绍使用Python实现12306网站登录并保存Cookie的方法。通过构造特定的请求头、获取设备指纹、处理验证码以及利用Session对象管理Cookie,实现自动登录流程。代码包含完整的请求工具类、会话管理器及URL配置,适用于需要模拟用户登录场景的爬虫开发。
本文介绍利用Python脚本解决公司网页认证断网问题。通过requests库模拟POST请求,自动提交用户名和密码,实现账号自动登录。结合定时任务,确保设备24小时在线,便于远程办公及TeamViewer连接,无需每日手动操作。
本文介绍利用Python的threading模块结合requests库,实现针对POST请求的高并发服务器测试方法。通过创建多个线程并行发送包含文件的POST请求,模拟真实负载场景。代码展示了线程池管理、请求发送及耗时统计逻辑,适用于需要验证服务器在高并发POST请求下的性能与稳定性的场景。
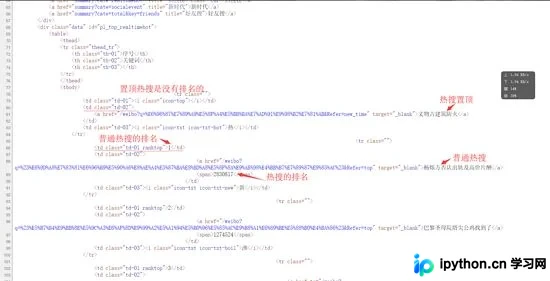
本文介绍使用Python的Requests和Lxml库抓取微博热搜数据的方法。通过解析HTML源码,利用XPath定位热搜标题、排名及阅读量节点,并处理置顶微博的特殊逻辑,最终格式化输出结果。
本文详解如何在Python3中利用requests模块实现文件下载进度的实时显示。通过设置stream参数启用流式传输,结合Response.iter_content分块读取数据,并自定义ProgressBar类利用\r控制光标刷新,从而在控制台输出美观的下载进度条。
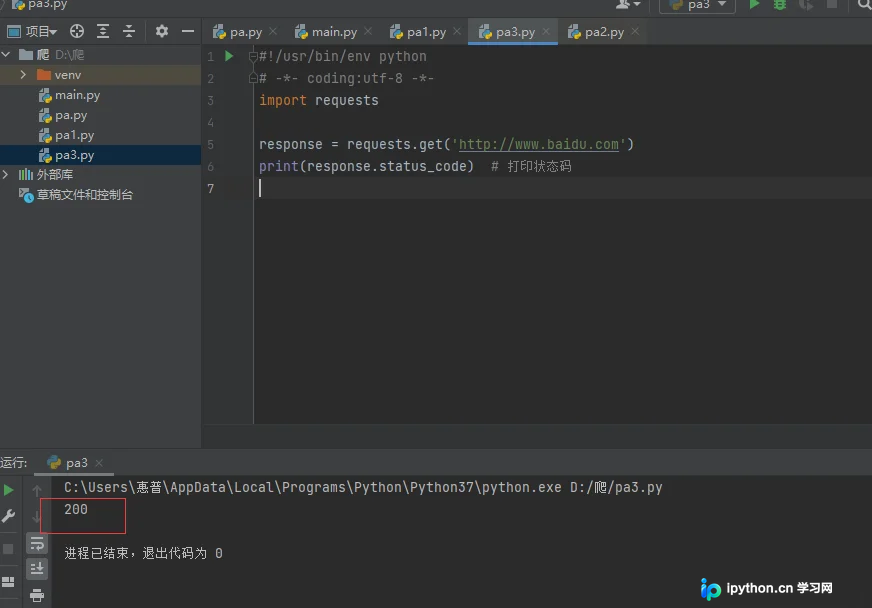
本文详细介绍如何在Python中使用requests模块发起HTTP请求。涵盖GET和POST两种常用方法,演示如何导入模块、选择请求方式及处理响应报文。通过百度访问示例说明HTML解析与编码设置,通过登录接口示例讲解字典参数传递与JSON响应处理,并展示如何获取响应头、编码格式及状态码等关键信息。
本文介绍使用Python多线程技术实现大文件分片下载并合并的完整流程。通过计算文件大小并设定步长,利用requests库的Range请求头并发获取数据块,最后按顺序写入文件完成合并。
本文介绍如何使用Python多线程技术批量检测代理IP的有效性。通过读取本地IP文件,利用requests库发起HTTP请求,并结合threading模块实现并发测试。示例代码展示了线程池管理、结果去重及有效IP写入文件的完整流程,帮助开发者快速验证代理池质量。
本文详细解析Python中requests库的核心用法,涵盖安装配置、GET与POST请求参数传递、JSON解析、文件保存、Headers与代理设置、Cookie会话维持、证书验证及超时异常捕获等关键操作,帮助开发者高效构建稳定的网络爬虫程序。
在软件授权或防篡改场景中,常需通过比对网络时间与本地时间来校验有效期。本文介绍两种Python实现方案:一是利用内置http.client模块解析HTTP响应头,手动转换时区;二是结合requests与arrow库同步服务器时钟偏差。文章提供完整可运行代码及关键参数说明,适用于本地部署与服务端对时的场景。
本文详解如何通过Postman将API请求快速转换为Python脚本,结合requests库与unittest框架实现接口自动化测试。内容涵盖环境配置、pip升级、脚本生成及断言编写,帮助开发者建立完整的接口测试知识体系。
