Python发送JSON参数请求的正确姿势
本文介绍如何在Python脚本中使用requests库发送JSON格式参数。关键在于设置Header中的Content-Type为application/json,并在请求方法中直接使用json参数传入字典数据。通过完整代码示例展示如何构建请求、处理响应及避免中文乱码,适用于API接口测试与自动化脚本开发。
2026-10-13
5

本文介绍如何在Python脚本中使用requests库发送JSON格式参数。关键在于设置Header中的Content-Type为application/json,并在请求方法中直接使用json参数传入字典数据。通过完整代码示例展示如何构建请求、处理响应及避免中文乱码,适用于API接口测试与自动化脚本开发。
本文介绍在Python中保存文件或图片的三种常用方式。首先分析已弃用的urllib.request.urlretrieve方法;其次演示使用requests库获取文件内容并处理HTTP元数据;最后介绍通过命令行工具wget在Python中调用下载的实现。
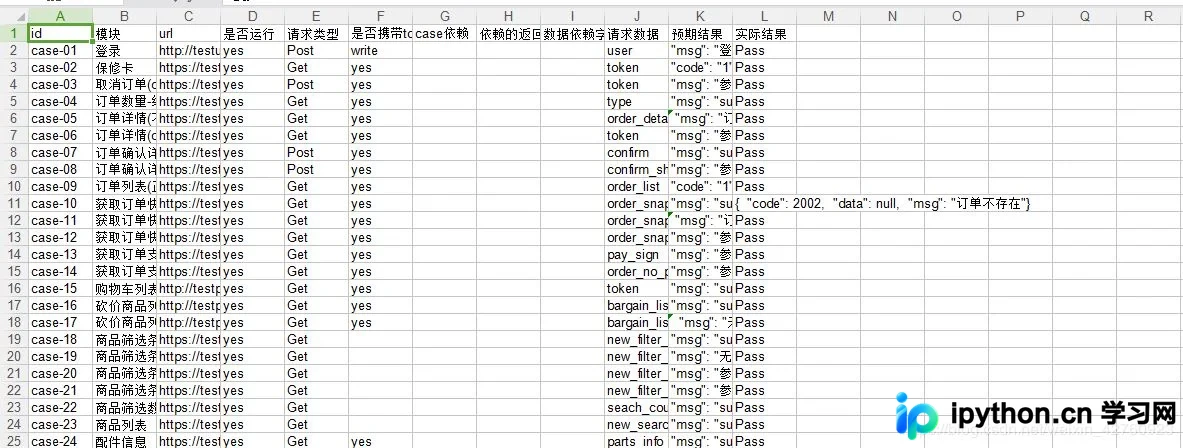
本文详细介绍如何使用Python3、Requests库结合Excel构建一套完整的接口自动化测试框架。内容涵盖项目目录结构设计,包括基础请求封装、Excel数据读取、依赖数据处理、Token实时获取与写入以及主运行程序等核心模块的实现逻辑,旨在帮助开发者快速搭建可维护的接口测试解决方案。
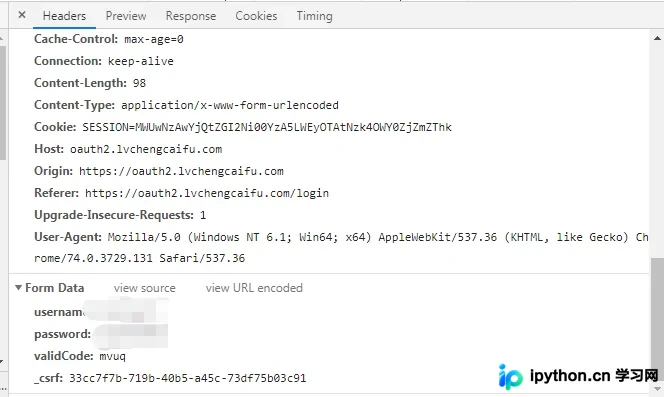
本文介绍使用Python的Requests库实现网站自动登录及表单数据提交的方法。通过Session保持会话状态,处理CSRF令牌与验证码,并演示如何保存和加载Cookie以维持登录状态,适用于Web自动化测试与数据采集场景。
本文介绍在使用 Python requests 库请求 HTTPS 网站时遇到的 SSL 证书错误(SSLerror)的两种常见解决方案。第一种方法是通过将 verify 参数设置为 False 来关闭 SSL 证书验证,适用于开发测试或受控环境;第二种方法是将本地证书文件路径赋值给 verify 参数,以指定具体的 CA 证书进行验证。文章提供了基于 requests.get 和 requests.post 的代码示例,帮助开发者快速解决证书验证问题。
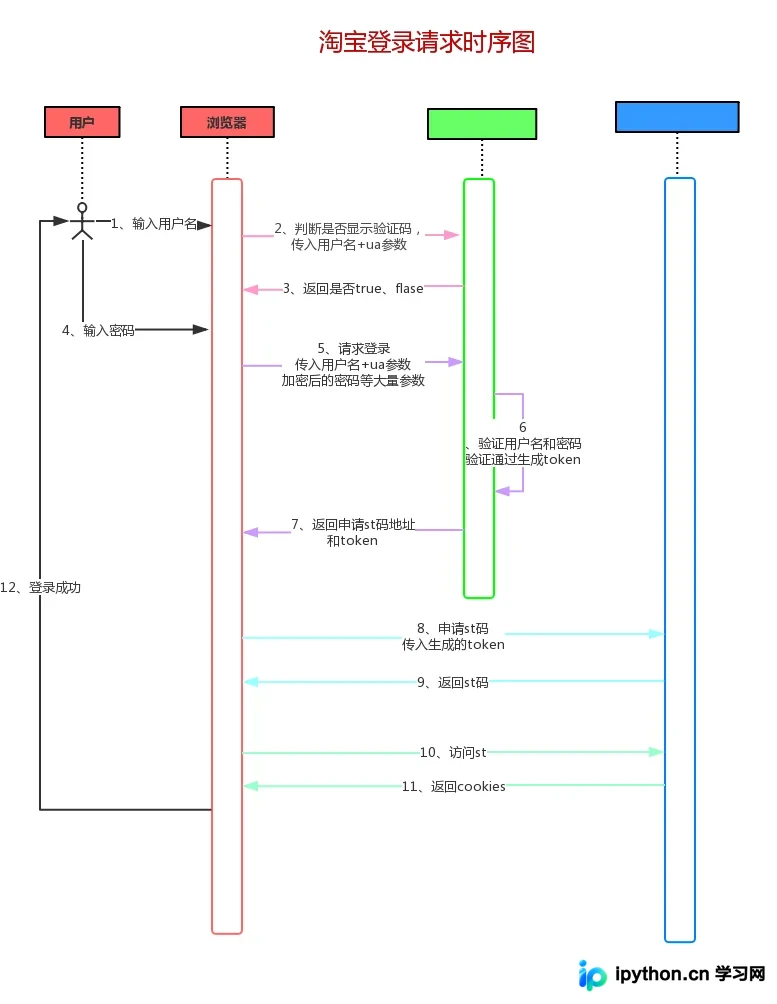
本文详细讲解如何使用Python Requests库模拟登录淘宝,并重点介绍2.0版本新增的Cookie持久化功能。通过序列化与反序列化技术,实现登录状态的文件保存与自动读取,避免每次运行重新登录。文章涵盖四步登录法、代码重构及完整的测试流程,适用于需要长期维持登录状态的爬虫开发场景。
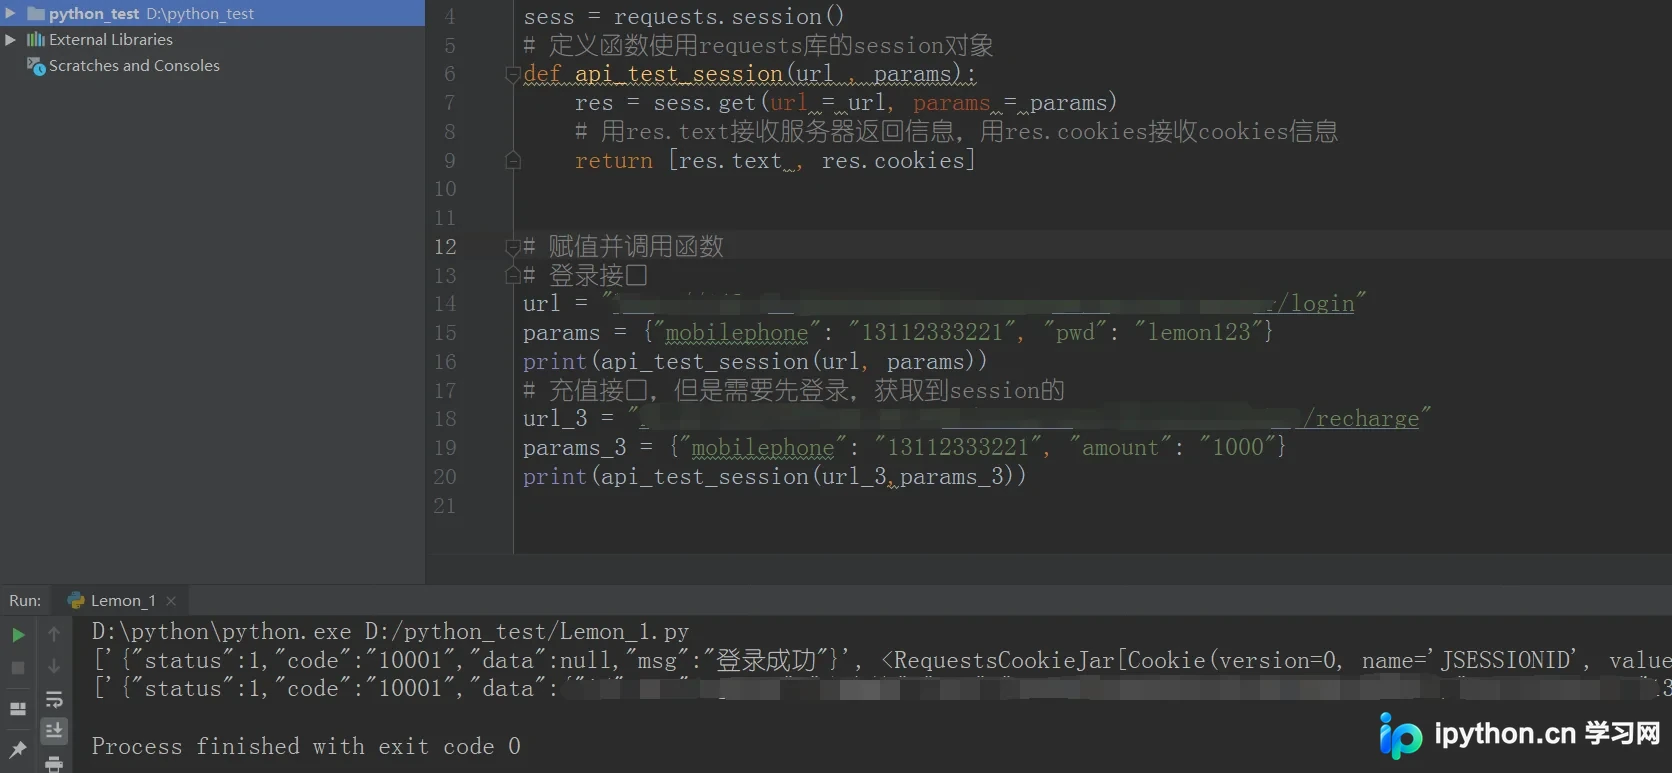
本文详解Python中requests库的session机制。针对HTTP无状态特性,通过对比普通请求与session对象,说明如何利用requests.session保持登录状态、保存Cookie及会话信息,适用于接口与UI自动化测试中的登录场景。
本文通过两个Python爬虫实例详解XPath技术的应用。案例一演示如何从图片列表页提取内页链接,进而获取百度网盘地址与提取码,涉及函数传参、循环控制及异常跳过逻辑。案例二针对豆瓣读书评论,解析为何直接获取节点无效,并指出使用/text()提取文本内容的正确方法。文章涵盖requests与lxml库的基础用法及常见错误排查。
本文介绍在Python多网卡环境中,如何通过修改socket的source_address参数来指定特定网卡发送HTTP请求。文章详细解析了urllib和requests库的底层实现,提供了针对urllib3的适配方案及解决ConnectionError异常的代码示例,帮助开发者在多IP场景下精确控制网络出口。
本文介绍使用Python爬虫批量下载Zabbix官方文档的方法。通过requests获取页面链接,利用正则表达式解析目录结构,并拼接导出PDF参数实现批量下载。代码包含错误处理与延时机制,适合需要离线查阅技术文档的场景。
本文详解Python中Requests模块发起GET请求的两种常见场景:携带查询参数与自定义请求头。通过搜狗首页及搜索接口的实战代码,演示如何利用params字典传递URL参数,以及通过headers参数设置User-Agent以模拟浏览器访问,帮助开发者掌握基础爬虫请求构造技巧。
本文详解如何使用Python的Requests模块发起Ajax GET请求以爬取豆瓣电影分类排行榜数据。通过抓包工具定位异步加载的接口,解析返回的JSON字符串,并调整start和limit参数获取不同范围的电影详情,实现高效的数据抓取。