

Python3 requests库解析中文页面乱码解决方案
本文介绍Python3中requests库处理HTTP响应时常见的中文乱码问题。由于requests自动猜测的encoding属性可能导致解码错误,建议直接使用content属性获取字节码,或手动设置正确的encoding(如gbk)以获取正确的unicode文本。
2026-10-13
6

本文介绍Python3中requests库处理HTTP响应时常见的中文乱码问题。由于requests自动猜测的encoding属性可能导致解码错误,建议直接使用content属性获取字节码,或手动设置正确的encoding(如gbk)以获取正确的unicode文本。
本文介绍如何使用Python编写爬虫程序,通过搜狗微信搜索接口抓取公众号文章标题、封面及正文内容,并利用pymysql库将数据持久化存储到MySQL数据库中。代码示例展示了数据库连接、数据去重检查及插入逻辑,供初学者参考学习。
本文介绍了如何使用Python通过requests库调用钉钉开放平台接口,发送Text格式的消息。文中提供了完整的代码示例,包括设置访问令牌、构造JSON数据以及发送POST请求的关键步骤,帮助开发者快速实现自动化消息通知功能。
本文介绍Python中广泛使用的HTTP库requests。它基于Apache2许可证,旨在提供比标准库urllib2更简洁、人性化的API。文章涵盖通过pip或easy_install安装requests的方法,并演示了GET、POST等常见HTTP请求类型、参数传递、响应处理、编码设置及代理配置等核心功能,帮助开发者快速上手网络请求开发。
本文介绍如何使用Python调用有道翻译API接口。首先需通过pip安装requests库,随后申请API密钥。文中提供了完整的Python代码示例,涵盖请求发送、JSON解析及错误处理逻辑,旨在帮助初学者快速实现简单的翻译功能。
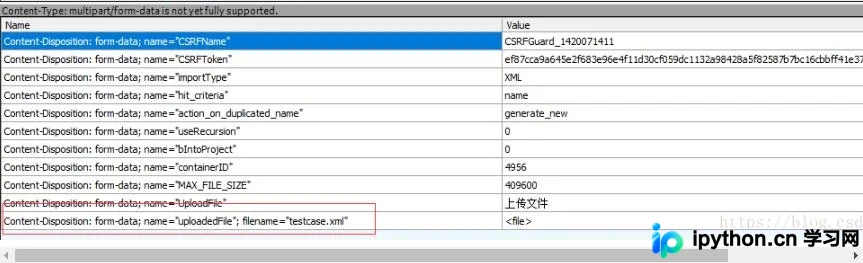
本文详解如何使用Python Requests库调用包含文件参数的接口。针对Fiddler抓包显示的Form-Data结构,说明不能仅用data传参,需将文件参数通过files字典传递。通过对比抓包结果验证请求一致性,确保文件上传逻辑正确。
本文介绍如何利用Python将浏览器开发者工具中复制的原始Headers字符串转换为标准的字典格式,并进一步序列化为JSON字符串。通过字符串分割与字典生成式技术,自动处理键值对提取及协议头修正,适用于网络爬虫调试与接口开发场景。
本文介绍了如何使用 Python 的 requests 库发送带有自定义 Header 和 Body 的 POST 请求。通过构建完整的 URL、定义请求头信息以及序列化数据体,展示了两种传递 Body 的方式:使用 data 参数配合 json.dumps 或使用 json 参数直接传入字典对象。
本文介绍在Python中使用Requests库获取网站Cookie时遇到的常见陷阱。通过调试发现,某些情况下服务器返回的Cookie可能存在于r.request.headers而非r.headers中。文章分析了请求头中Host和Referer字段对Cookie返回的影响,并推荐通过会话对象自动管理Cookie的最佳实践,帮助开发者解决模拟登录中的Cookie获取问题。
本文详解Python中模拟登录的两种主要方式:直接复制浏览器Cookie与使用Session维持会话。重点解析为何普通请求无法保持登录状态,并通过代码示例展示如何利用requests.Session对象自动管理Cookie,实现跨请求的身份验证与数据获取,解决多页面交互中的会话断开问题。
在使用Python requests库发送POST请求时,若data参数包含嵌套字典,默认form编码会导致数据解析异常。本文指出官方文档仅演示单层字典情况,并提供通过将内层字典转为JSON字符串作为解决方案,确保多层数据结构正确传输。
本文介绍如何使用Python的requests库高效提交HTTP表单数据。通过实例演示了无Cookie、显式添加Cookie及Session隐式维持Cookie三种场景下的POST请求实现。同时提供利用tcpdump进行网络抓包以辅助脚本调试的实用技巧,帮助开发者快速定位网络交互问题。