Python实现自动访问网页的代码示例
本文介绍了使用Python自动访问网页的两种方法。第一种利用requests库结合IP池和User-Agent随机化,模拟浏览器请求以规避简单反爬;第二种通过socket直接构建TCP连接并发送原始HTTP报文,解析响应体保存为HTML文件。代码包含完整实现细节,供开发者参考。
2026-10-13
5

本文介绍了使用Python自动访问网页的两种方法。第一种利用requests库结合IP池和User-Agent随机化,模拟浏览器请求以规避简单反爬;第二种通过socket直接构建TCP连接并发送原始HTTP报文,解析响应体保存为HTML文件。代码包含完整实现细节,供开发者参考。
本文详解使用 Python requests 模块获取网页源码的标准流程。通过封装 Crawler 类,演示如何自动获取并持久化站点 Cookie,利用 dict_from_cookiejar 转换格式以便后续请求携带。核心方法 get_html_text 实现了通用的爬取框架,包含状态码校验、编码自动识别及异常处理,为构建稳定爬虫提供基础代码参考。
本文提供使用Python爬取疫情数据的完整源码。通过requests库获取接口数据,利用json模块解析嵌套JSON结构,提取全国及各省累计确诊病例等关键指标。代码包含类封装、数据下载与解析逻辑,适合Python初学者参考学习网络爬虫基础及数据抓取技巧。
本文详细介绍Python中requests库的核心用法。涵盖如何引入模块,执行GET、POST等多种HTTP请求,利用params参数便捷构造带参URL(包括多值参数处理),以及通过字典定制请求头Headers。提供完整代码示例,帮助开发者快速掌握网络请求基础。
本文详细介绍如何利用Python的requests库处理两种常见的接口请求场景:无需鉴权的直接访问接口,以及需要登录后获取Session信息的鉴权接口。通过封装HttpRequest和HttpSession类,结合登录与充值接口的具体代码示例,演示如何正确传递参数、处理响应数据及保持会话状态,为接口自动化测试提供清晰参考。
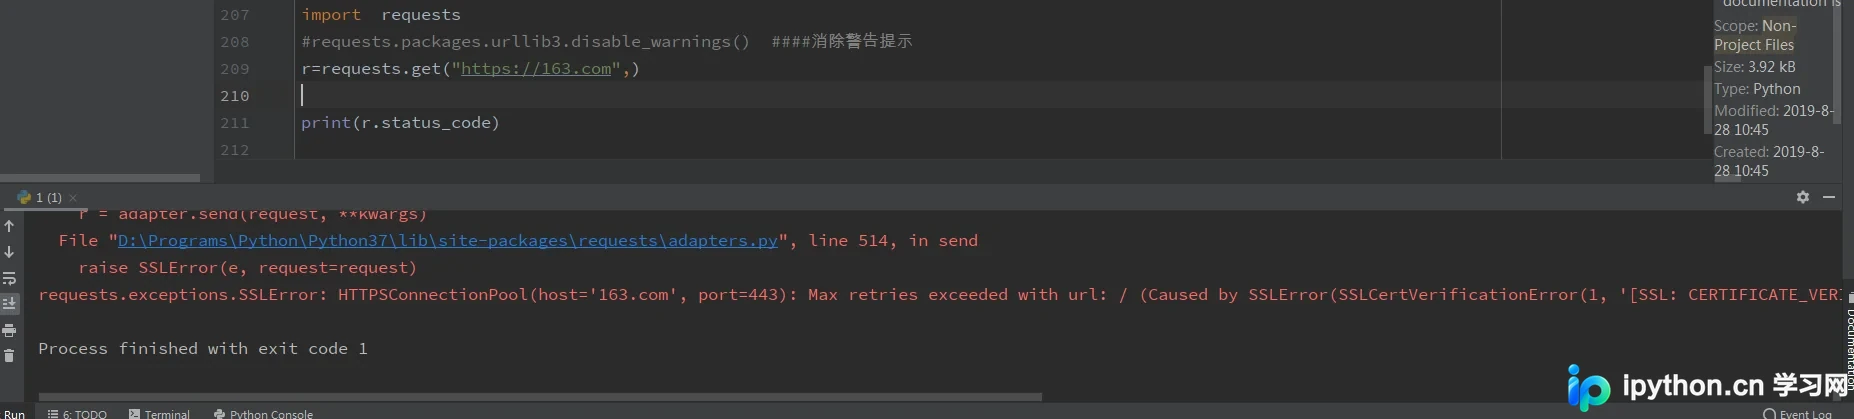
本文详解Python中HTTPS请求遇到的SSL证书验证问题。分析Fiddler抓包对SSL的影响,介绍Requests库verify参数的用法,并提供三种禁用SSL警告的代码方案,帮助开发者快速解决证书验证失败及Warning提示。
本文介绍Python中将JSON序列化字符串转换为字典的方法。通过json.loads()实现基础转换,并演示如何添加try-except块处理JSONDecodeError和TypeError等异常,确保程序健壮性。结合requests库获取网络JSON数据并转换为字典的完整示例,涵盖文件读写及参数设置,适用于实际开发中的数据处理场景。
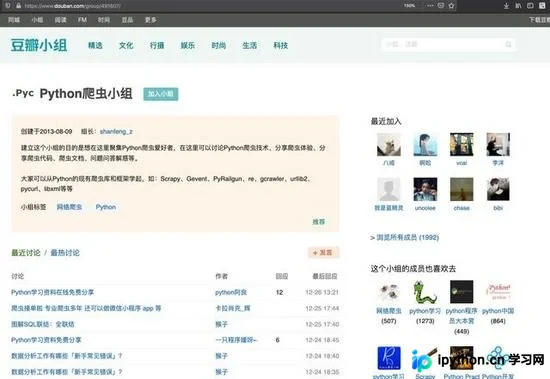
本文详细解析Python中解析HTML网页的四种主流方式:正则表达式、requests-html、BeautifulSoup及lxml XPath。通过豆瓣小组页面抓取实例,对比各库在代码复杂度、执行效率及适用场景上的差异,帮助开发者根据实际需求选择最高效的数据提取工具。
本文介绍利用Python实现一键抠除图片背景的方法。通过对比requests模块直接调用API与使用removebg库两种方式,展示代码实现细节。针对removebg库添加纯色背景参数报错的问题,提供使用PIL库手动填充背景色的解决方案,并附带完整代码示例与效果说明。
本文详细介绍在Python爬虫开发中如何添加请求头,分别通过requests、urllib以及PhantomJS三种方式给出具体代码示例。内容涵盖常见Header字段的配置方法,如User-Agent、Referer等,帮助开发者绕过基础反爬机制。
本文介绍使用Python3结合xlrd和requests库,从Excel文件中读取URL链接并批量下载音视频文件的完整代码。示例包含文件夹创建、路径拼接及文件写入逻辑,适用于自动化媒体资源抓取场景。
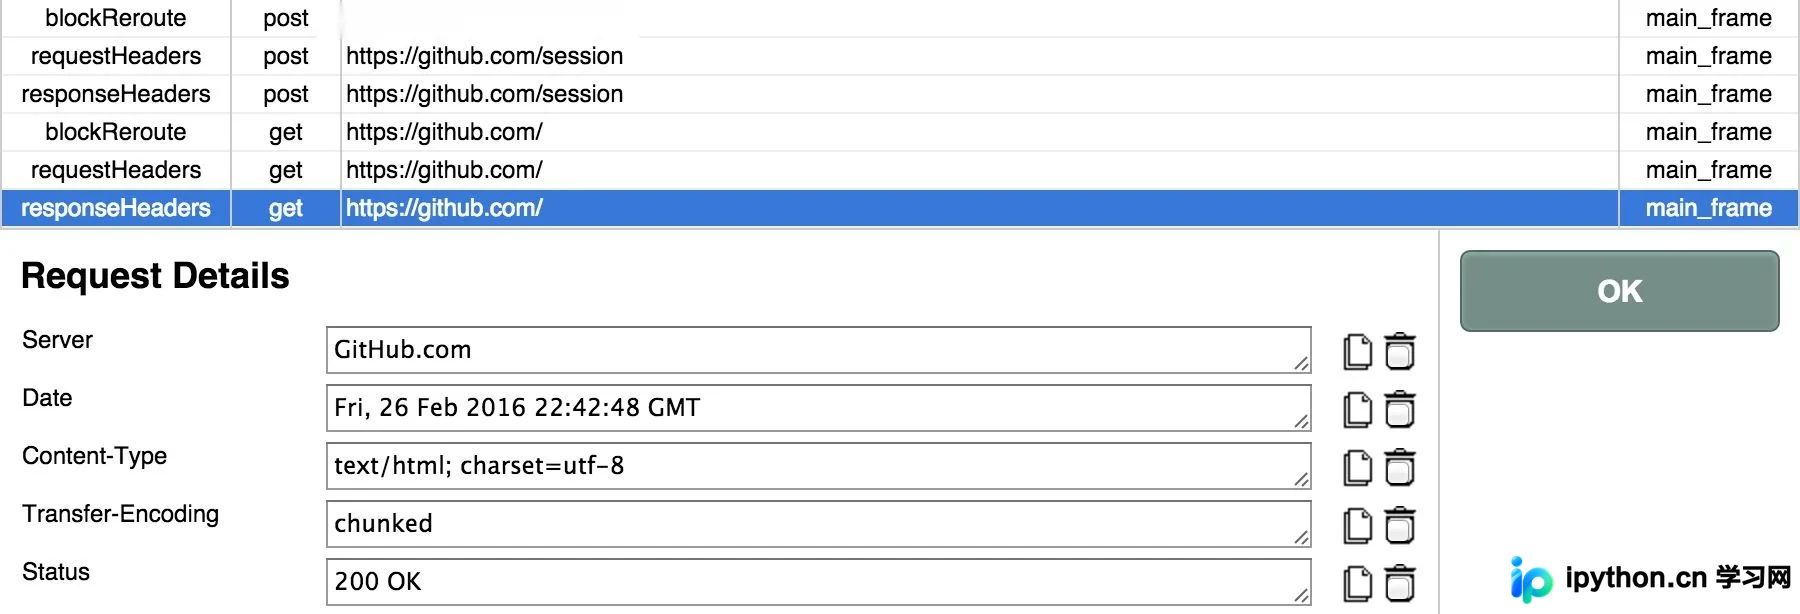
本文详解如何利用Python的requests库模拟GitHub登录流程。通过解析HTTP无状态特性,掌握Cookie与Session的维护机制。重点讲解如何从登录页面提取authenticity_token(CSRF令牌),构造POST表单数据,并发送请求至session接口实现自动登录,最终通过状态码判断登录结果。