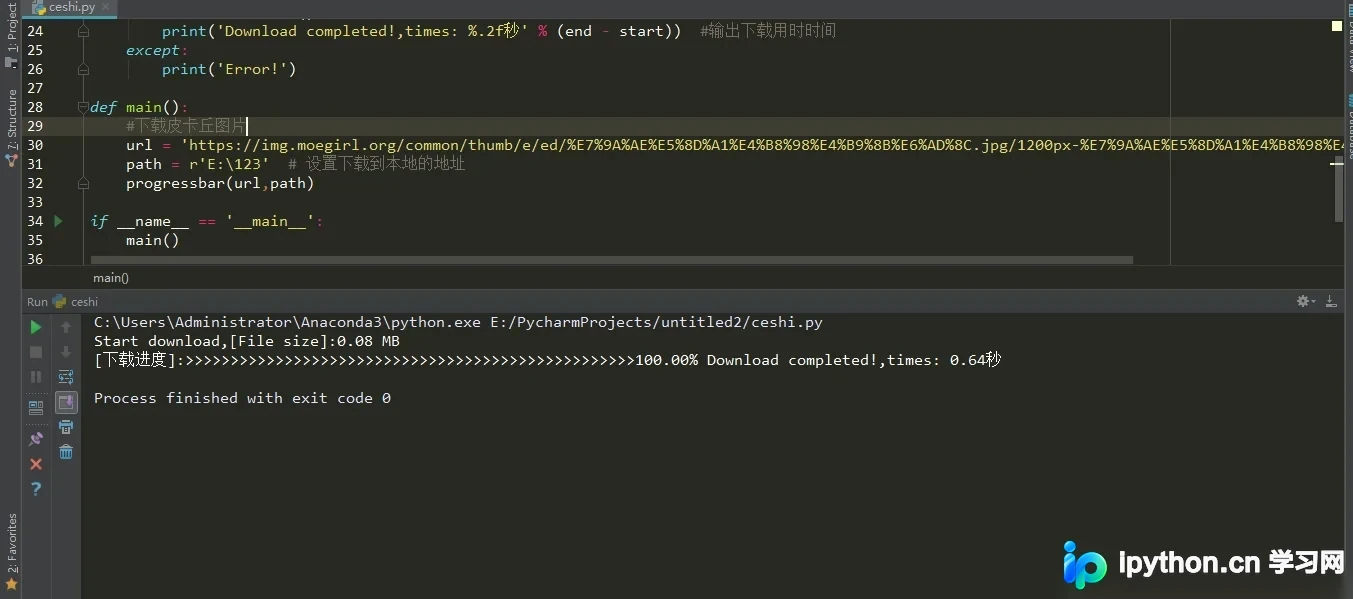
Python 实现文件下载进度条与耗时统计
本文介绍如何使用 Python 的 requests 库实现文件下载时的实时进度条显示与耗时统计。通过设置 stream=True 并分块读取数据,结合 os 和 time 模块,可直观展示下载百分比及所用时间,适用于各类文件下载场景。
2026-10-13
6

本文介绍如何使用 Python 的 requests 库实现文件下载时的实时进度条显示与耗时统计。通过设置 stream=True 并分块读取数据,结合 os 和 time 模块,可直观展示下载百分比及所用时间,适用于各类文件下载场景。
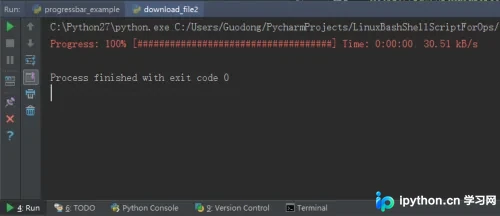
本文详细介绍如何使用Python的requests库下载HTTP文件,并结合progressbar模块实现实时下载进度条显示。通过示例代码演示了如何获取文件大小、分块读取数据以及动态更新进度,帮助开发者在文件传输过程中获得直观的用户体验。
本文详解 Django 中 API 接口的互相调用方法。首先介绍如何从请求元数据中提取客户端 IP、端口及各类 HTTP 请求头信息。随后通过具体代码示例,演示使用 Python requests 库发起 GET 和 POST 请求的关键步骤,重点解析 JSON 数据序列化、Content-Type 设置及常见错误码(如 400、415)的排查与解决。
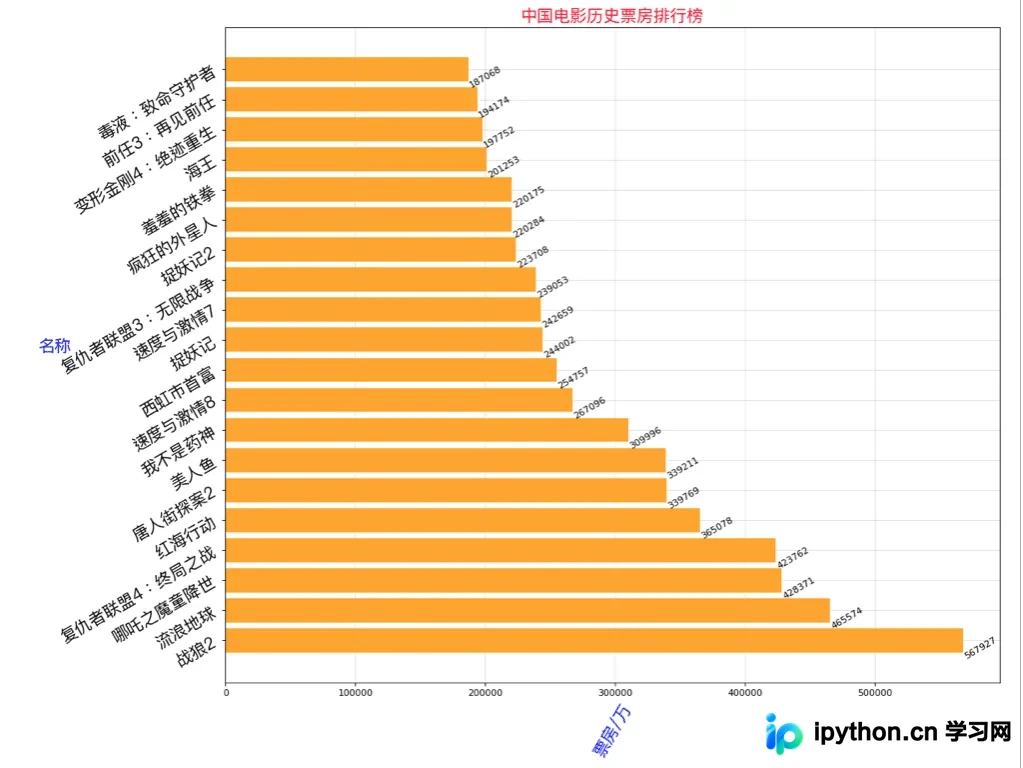
本文通过Python实现电影历史票房数据的抓取与可视化展示。利用requests库请求指定API获取JSON数据,结合matplotlib库绘制横向条形图。代码采用面向对象设计,封装了请求、解析及绘图逻辑,可直接运行查看结果,适合Python初学者参考学习。
本文通过一个实际案例,演示如何使用Python自动下载网站图片。从基础的单线程脚本入手,逐步优化至多进程和多线程版本,对比不同并发策略在I/O密集型任务中的性能差异,帮助开发者掌握提升爬虫效率的关键技术。
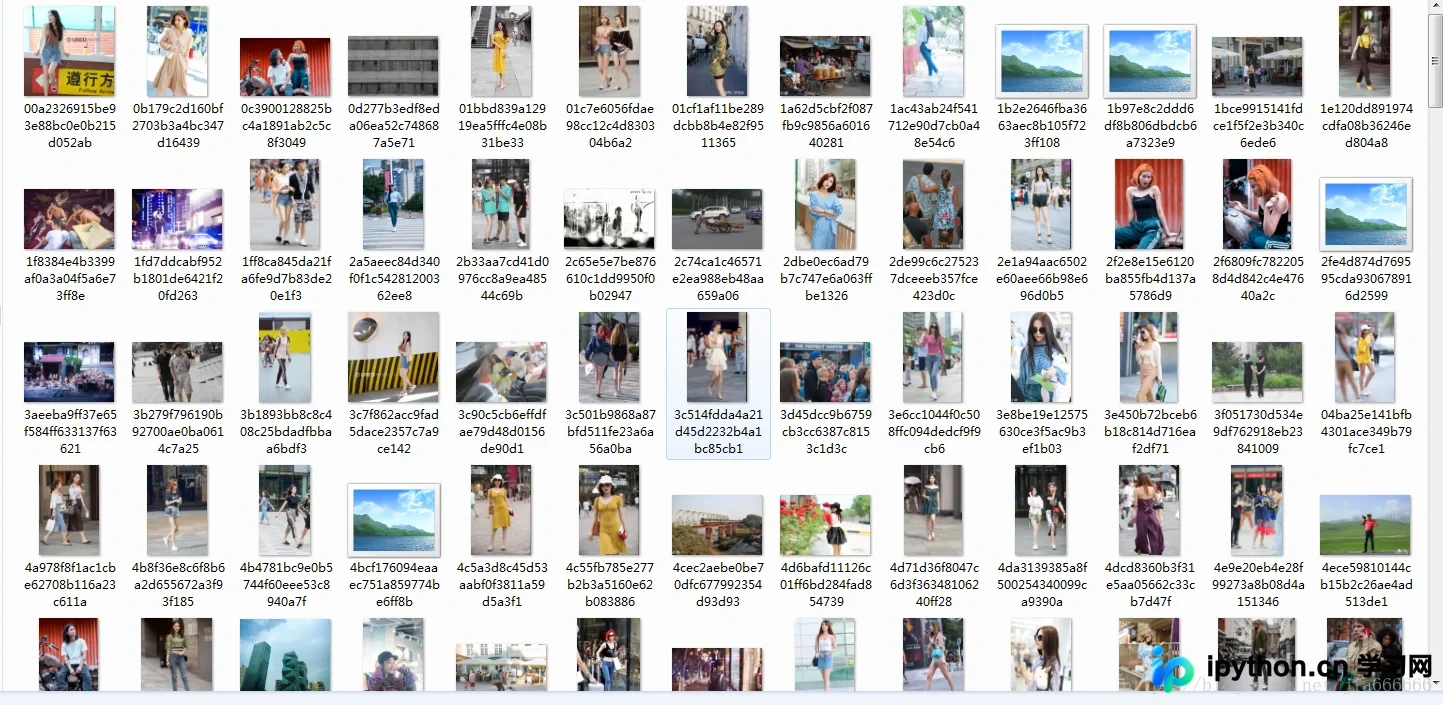
本文详细介绍如何使用Python的requests和urllib库,结合OS模块爬取今日头条街拍美图。通过解析索引页获取图集链接,再深入详情页提取图片URL,最终实现批量保存本地。代码包含完整注释,适合Python爬虫初学者参考学习。
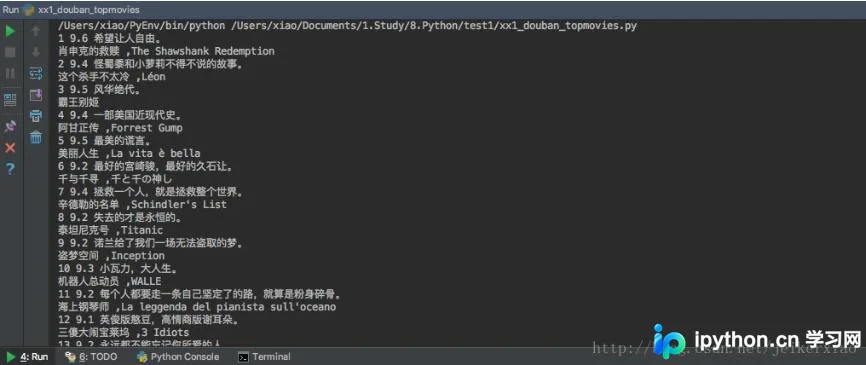
本文通过豆瓣电影Top250及新浪新闻两个实例,详细演示了Python3中requests库发送HTTP请求与lxml库etree模块进行XPath解析的完整流程。内容涵盖会话保持、编码处理、节点定位及数据清洗,帮助开发者掌握基础的网页抓取与解析技术。
本文通过五个Python代码实例,详解如何使用requests库进行网络爬虫开发。内容涵盖普通页面爬取、模拟浏览器请求规避限制、搜索引擎关键词抓取、图片保存以及IP地址归属地查询,提供完整代码与参数解析,帮助开发者快速掌握网络数据提取核心技巧。
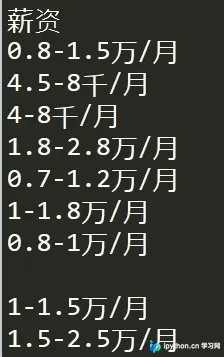
本文详细介绍如何使用Python的requests库发送HTTP请求获取网页内容,并结合BeautifulSoup库解析HTML结构。通过百度首页及51job招聘网站两个具体案例,演示了处理编码问题、设置请求头防反爬以及提取特定文本信息的完整流程,帮助开发者掌握基础的网络数据采集技能。
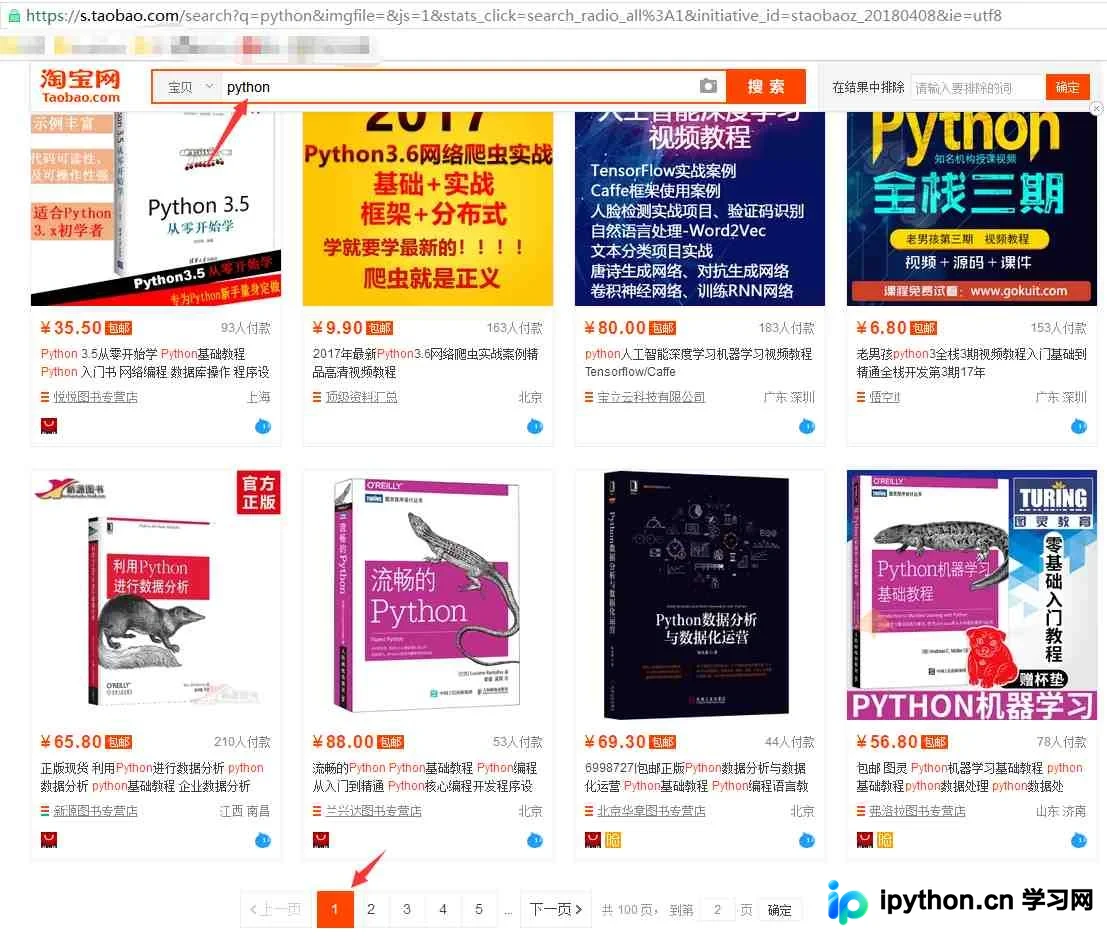
本文详细介绍如何使用Python的requests和re库爬取淘宝商品列表。通过解析URL参数q和s,构建分页请求,利用正则表达式精准提取raw_title和view_price字段。代码示例展示了从获取HTML源码、解析数据到存储结果的完整流程,适合Python初学者学习网络爬虫基础。
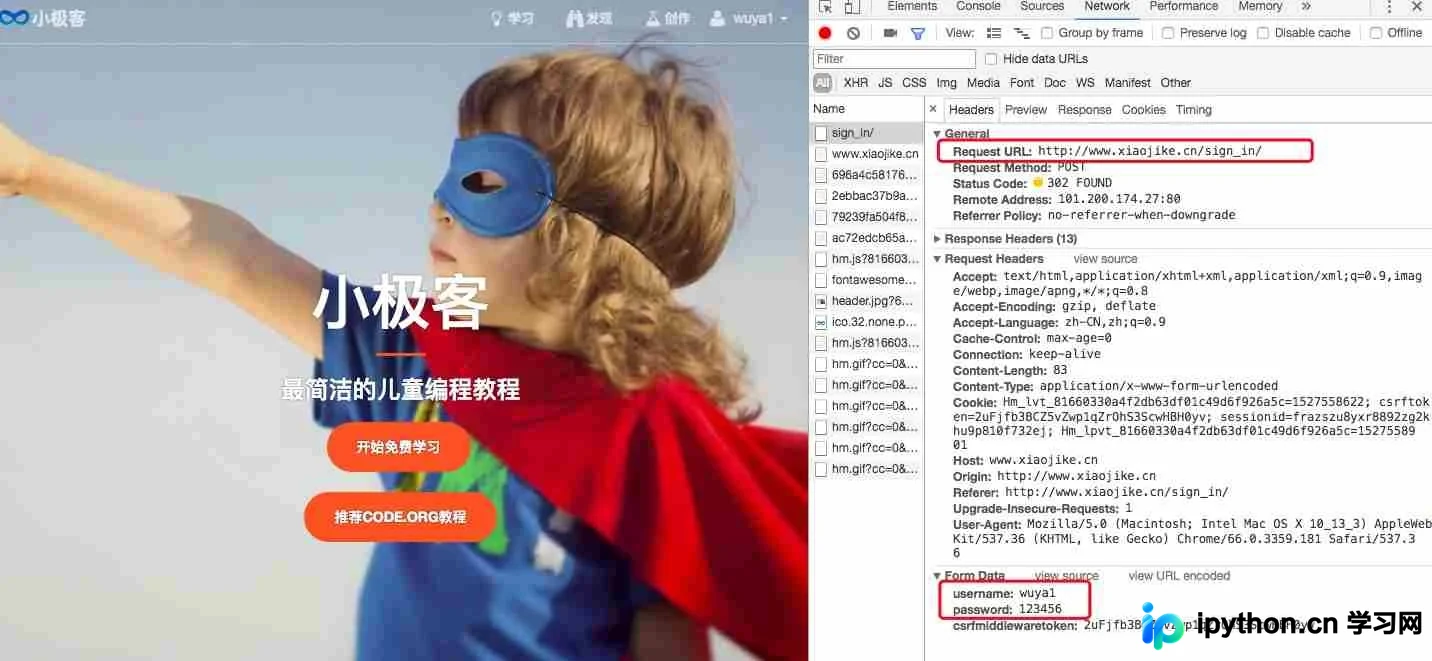
本文详细演示了如何使用Python的requests库发送Post请求以模拟网站登录过程。通过抓取小极客网的登录接口、分析用户名与密码参数,并编写代码发送请求,最终验证返回的状态码、URL及请求头,实现与手动登录一致的效果。
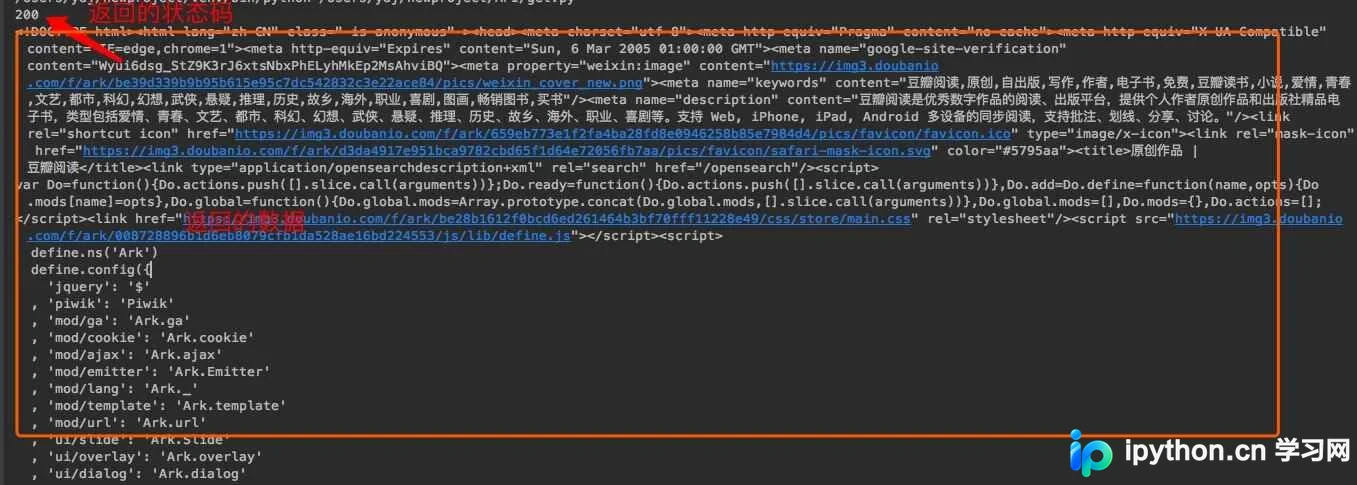
本文详解Python中使用requests模块进行接口测试的GET请求流程。涵盖直接请求、字典形式参数传递(如豆瓣搜索示例)、状态码判断及响应对象属性(status_code, text, json等)的获取方法,帮助开发者掌握基础接口测试技能。