

Python xlutils库修改Excel文件及保留格式的方法
本文介绍如何使用Python的xlutils库修改Excel文件。重点讲解通过xlrd打开工作簿时设置formatting_info=True,以及使用copy()方法复制工作簿,从而在写入新数据时保留原有的单元格格式。
2026-10-11
13

本文介绍如何使用Python的xlutils库修改Excel文件。重点讲解通过xlrd打开工作簿时设置formatting_info=True,以及使用copy()方法复制工作簿,从而在写入新数据时保留原有的单元格格式。
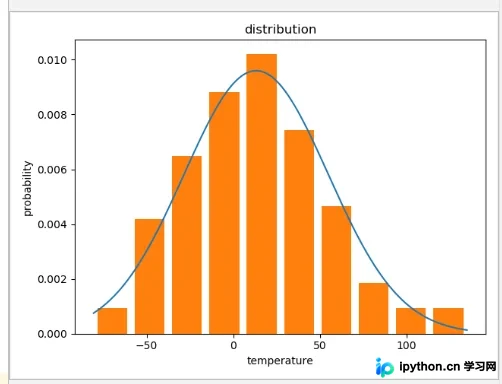
本文详解如何使用Python生成正态分布数据,并通过Matplotlib绘制概率分布图与离散图。内容涵盖基于均值和标准差的随机数生成、正态性假设检验(如Scipy的normaltest)、置信区间计算以及基于四分位距(IQR)的异常值识别方法,附带完整代码与图表解析。
本文介绍如何使用 Python 的 requests 库模拟登录 GitHub。核心步骤包括:初始化 Session 保持状态、获取登录页的 CSRF Token、构造 POST 请求提交表单数据。代码展示了如何提取 authenticity_token 并处理登录响应,适用于学习 Web 自动化与爬虫基础。
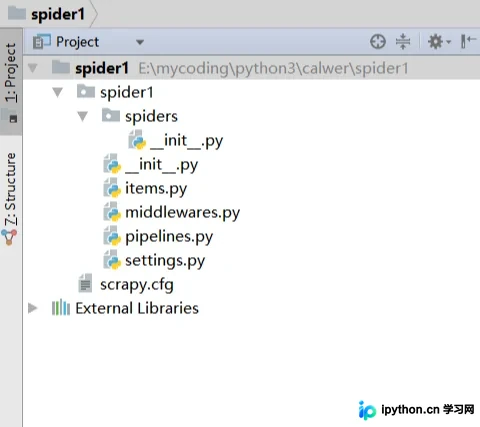
本文详细讲解如何利用Python Scrapy框架搭建电影数据爬虫。内容涵盖项目初始化命令、核心文件功能解析、Spider类的定义规范(包括name、allowed_domains等属性),以及通过XPath提取电影名称与评分的具体代码实现,帮助开发者快速掌握Scrapy基础用法。
本文解析Python中析构函数__del__的定义与工作原理。通过代码示例说明__del__在对象资源释放时的触发机制,以及Python如何利用gc模块和引用计数算法进行内存管理。
本文介绍如何在Python3环境中使用FuzzyWuzzy库进行字符串模糊匹配。通过安装fuzzywuzzy及python-Levenshtein依赖,利用fuzz模块计算字符串相似度(如ratio方法),并使用process模块从候选列表中提取最相关的字符串,适用于数据清洗和模糊搜索场景。
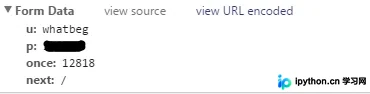
本文详细解析如何使用Python的requests.Session实现网站模拟登录。通过V2EX网站的登录流程为例,演示如何利用BeautifulSoup解析HTML获取动态参数(如once值),构建POST请求数据,并利用Session对象跨请求保持Cookie状态,最终验证登录成功。
本文详解如何利用Python多线程技术高效抓取小米应用商店数据。通过分析动态加载接口,使用requests、threading和queue库构建爬虫,实现聊天社交类应用名称与链接的快速批量获取,并展示控制台输出结果及执行时间统计。
本文介绍如何使用Python通过paramiko模块远程登录Linux并执行命令,同时解决密码登录时的AuthenticationException问题。此外,还介绍了利用expect脚本实现远程文件传输的方法,并提供完整的Python调用示例。
本文深入解析 Python 中 __init__.py 文件的核心作用,包括标识目录为模块包、控制导入行为及执行初始化代码。详细说明了绝对路径与相对路径在导入子模块时的差异,以及 __all__ 变量如何精确控制 'from ... import *' 的导出范围,帮助开发者规范 Python 项目结构。
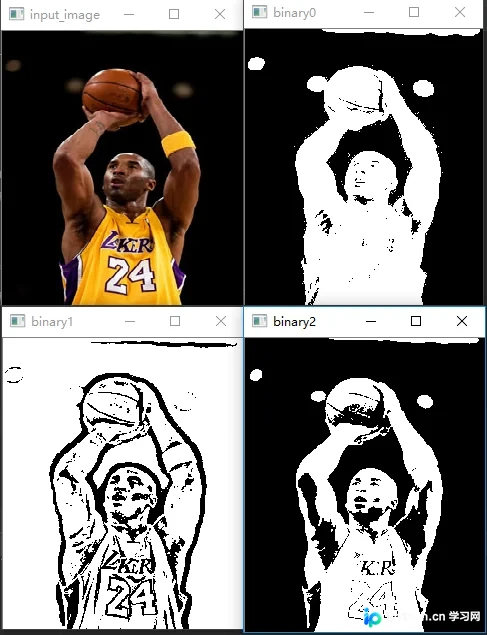
本文详细介绍如何使用Python和OpenCV库实现图像二值化。重点解析cv.threshold函数的全局阈值处理,包括THRESH_OTSU和THRESH_TRIANGLE自适应算法,以及adaptiveThreshold函数的局部阈值应用。通过代码示例展示参数设置与效果差异,帮助开发者掌握黑白图像转换的核心技术。
本文介绍如何使用Python将Word文档批量转换为HTML格式。通过安装python-docx和PyDocX库,利用os模块遍历目录,自动处理文件名空格问题,并循环调用转换函数生成对应的HTML文件。转换后的内容可直接存入数据库进行展示,适用于文档批量处理场景。