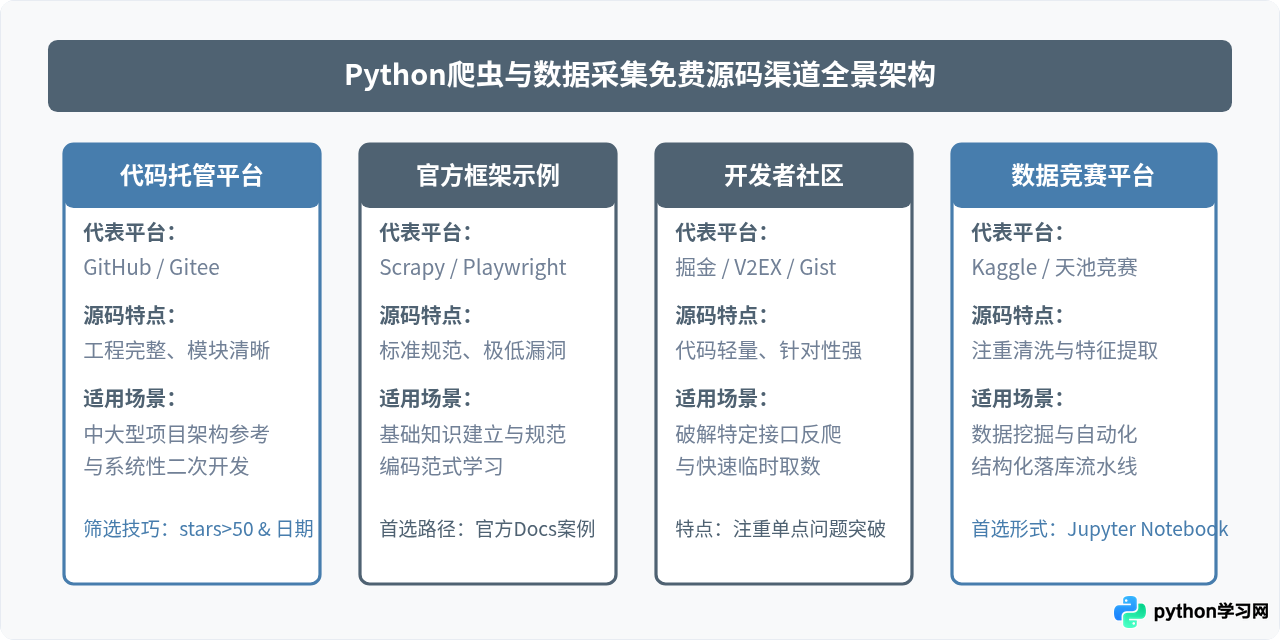
Python爬虫与数据采集免费源码哪里找
详细介绍寻找Python爬虫与数据采集免费源码的四大可靠渠道、高级搜索与筛选技巧、安全与合规审查方法,以及本地隔离试跑的标准流程。
2026-10-22
8

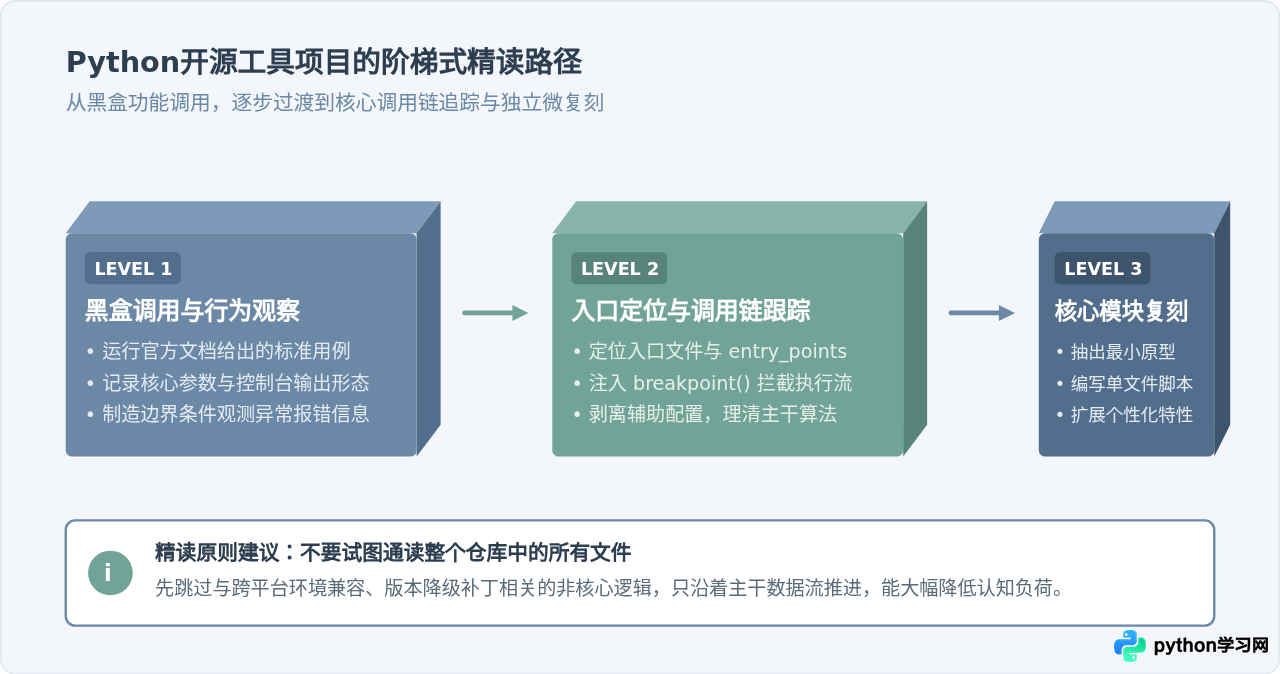
精选适合初学者的GitHub Python入门级开源工具项目,解析其代码组织结构、核心运行原理与本地调试方法,帮助读者掌握从阅读源码到自主开发的实用技巧。
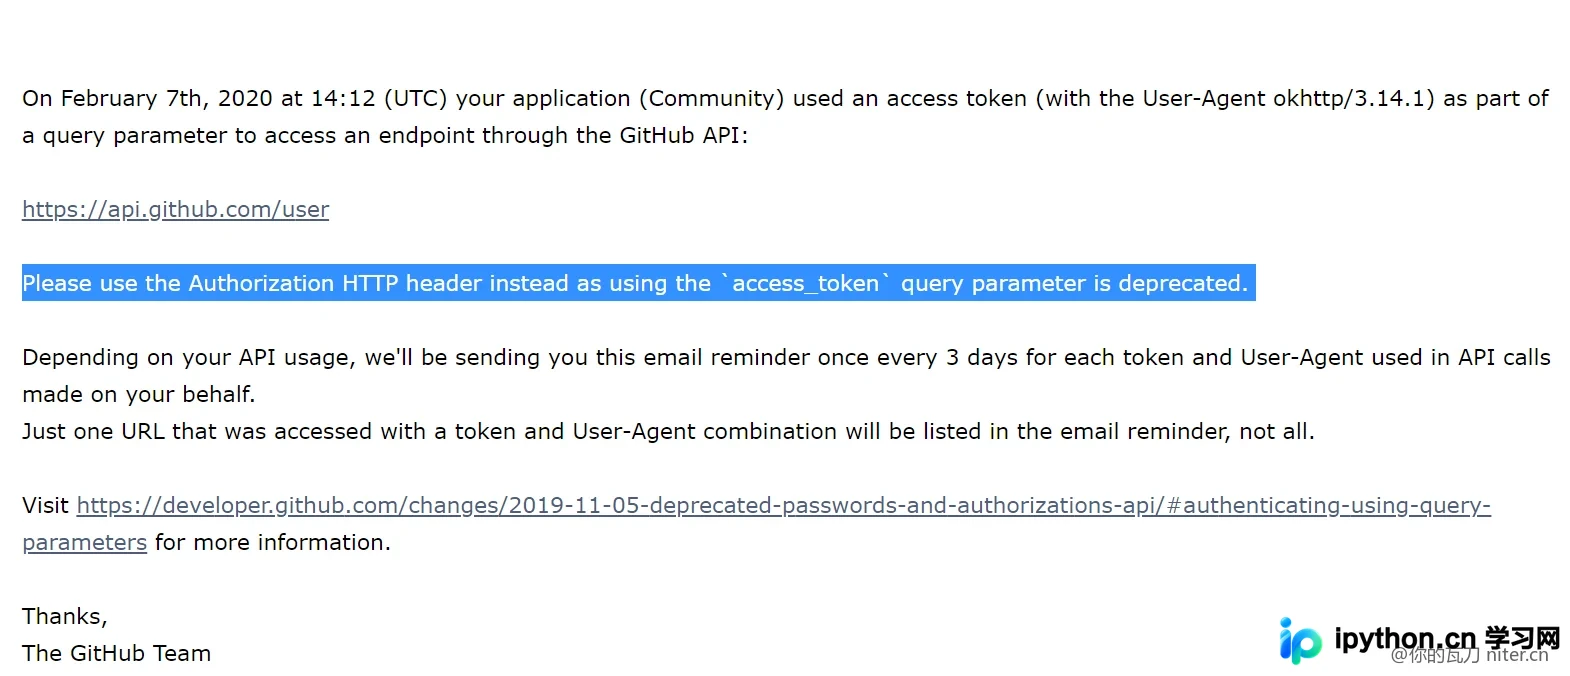
本文针对PyCharm在连接GitHub时偶尔出现的Connection Reset错误提供两种解决方案。首先介绍2020年5月GitHub官方废弃Query Parameter方式,推荐通过Personal Access Token配合Authorization HTTP Header进行安全访问;其次提供通过重新配置凭据(Use Credentials)解决连接重置的快速方法,帮助开发者恢复项目推送功能。
本文详解如何使用Python爬虫实现GitHub网页的模拟登录。通过浏览器开发者工具分析登录请求,提取Form Data中的动态参数authenticity_token、login及password,利用requests.Session保持会话状态,发送POST请求完成登录,并成功提取登录后的页面信息如注册号码。
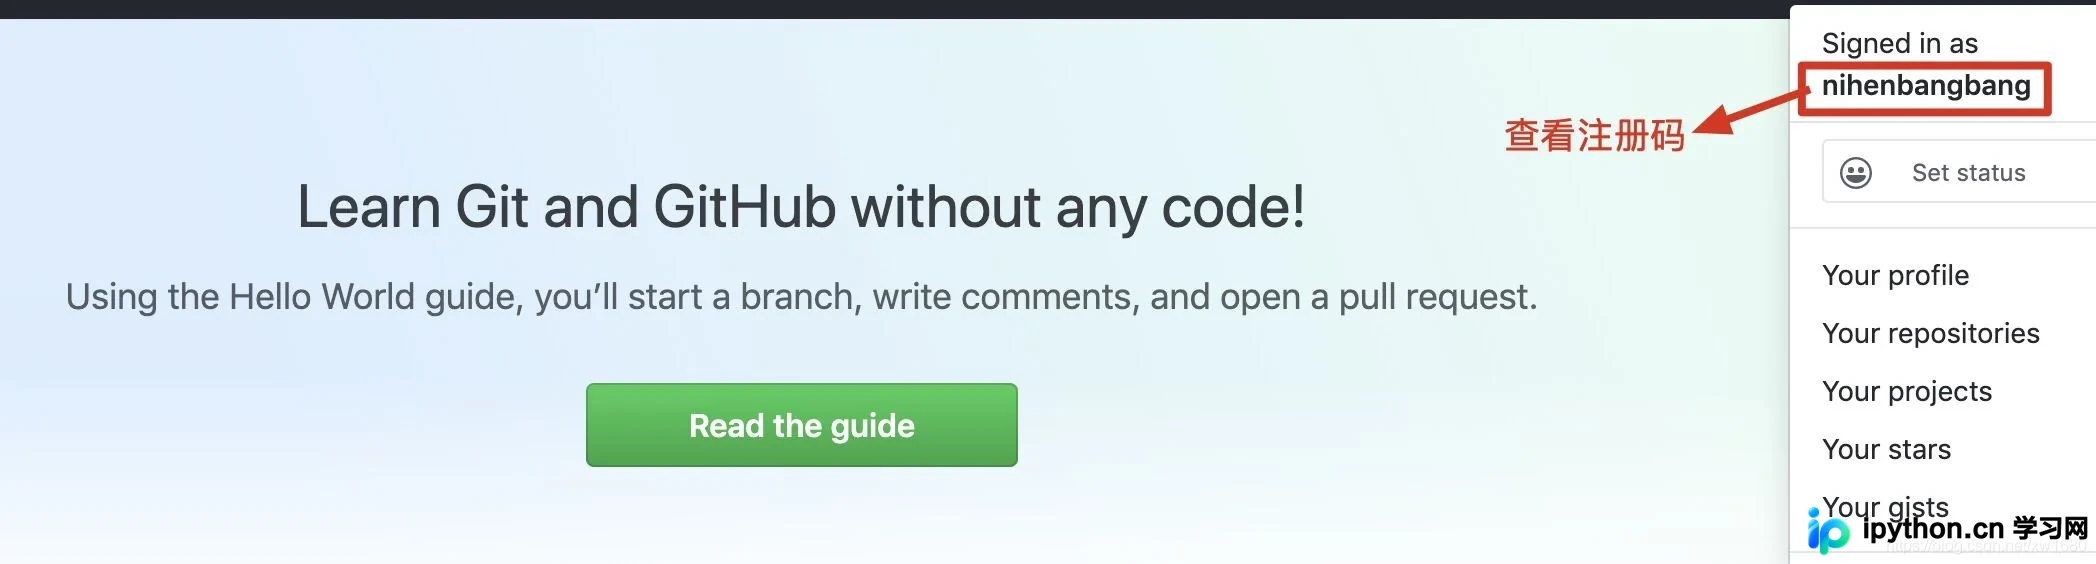
本文详细讲解如何使用Python结合Fiddler抓包工具模拟GitHub登录。通过抓取HTTP请求分析登录流程,提取关键参数authenticity_token,并利用requests库构建Session会话完成POST表单提交。文中包含处理SSL证书警告、正则提取Token及通过页面标题判断登录状态的具体代码实现,适合希望学习网络爬虫基础与接口模拟的开发者参考。
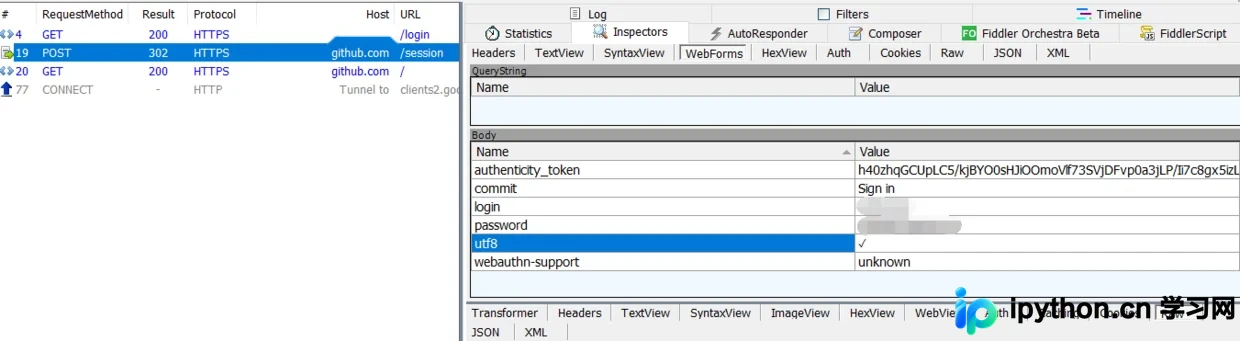
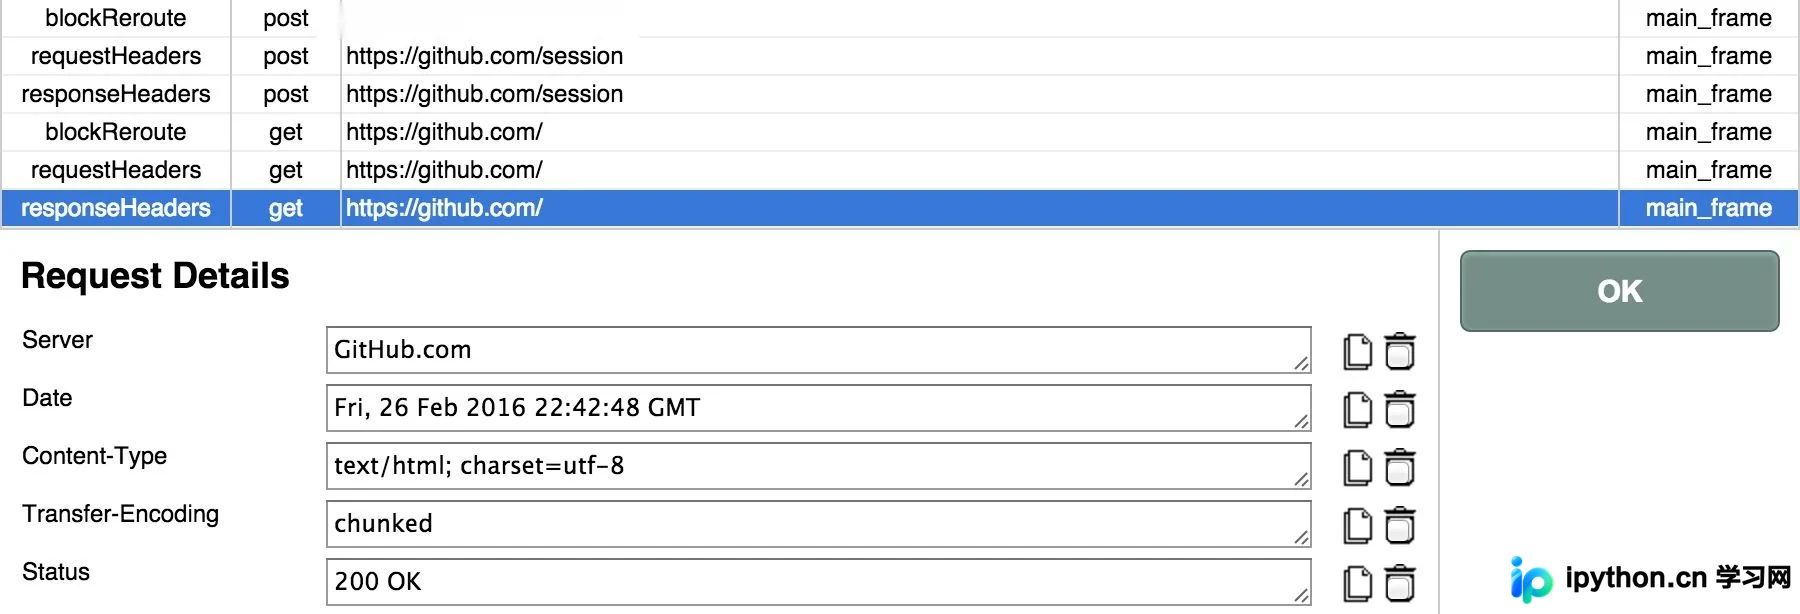
本文详解如何利用Python的requests库模拟GitHub登录流程。通过解析HTTP无状态特性,掌握Cookie与Session的维护机制。重点讲解如何从登录页面提取authenticity_token(CSRF令牌),构造POST表单数据,并发送请求至session接口实现自动登录,最终通过状态码判断登录结果。
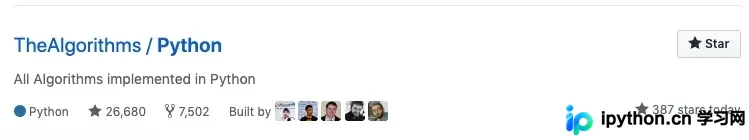
本文介绍 GitHub 上 Star 数超过 2.6 万的 Python 算法库 TheAlgorithms/Python。该库系统整理了排序、查找、加密、机器学习、图论及动态规划等多种算法,并提供原理简介与代码实现。文章重点展示了冒泡排序的 Python 代码示例,旨在为开发者提供全面的学习资源。
本文详细解析使用Python爬虫登录GitHub的技术流程。通过分析登录页面,提取CSRF Token与初始Cookie,利用Requests库发送GET请求获取必要参数,随后构造POST请求提交用户名和密码完成身份验证。最后演示如何携带登录后的Cookie访问个人详情页,实现自动化信息查看。
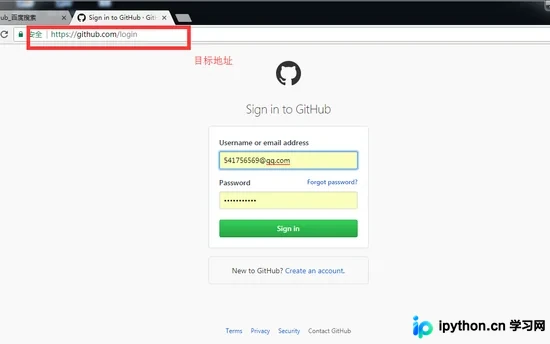
本文介绍如何使用 Python 的 requests 库模拟登录 GitHub。核心步骤包括:初始化 Session 保持状态、获取登录页的 CSRF Token、构造 POST 请求提交表单数据。代码展示了如何提取 authenticity_token 并处理登录响应,适用于学习 Web 自动化与爬虫基础。