

Python正态分布生成、可视化与统计检验实战

本文详解如何使用Python生成正态分布数据,并通过Matplotlib绘制概率分布图与离散图。内容涵盖基于均值和标准差的随机数生成、正态性假设检验(如Scipy的normaltest)、置信区间计算以及基于四分位距(IQR)的异常值识别方法,附带完整代码与图表解析。
生成正态分布数据并绘制概率分布图
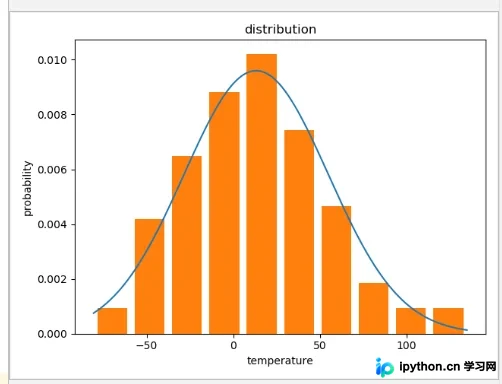
在数据分析中,生成符合特定统计特征的正态分布数据是基础操作。Python的 numpy 库提供了 np.random.normal 函数,允许用户指定均值(loc)和标准差(scale)来生成随机数。同时,为了直观展示数据的分布形态,可以使用 matplotlib 将理论概率密度函数(PDF)与实际生成的数据直方图进行叠加对比。
核心代码实现
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

# 根据均值、标准差,求指定范围的正态分布概率值
def normfun(x, mu, sigma):
  pdf = np.exp(-((x - mu)**2)/(2*sigma**2)) / (sigma * np.sqrt(2*np.pi))
  return pdf

# 生成正态分布数据:均值为15,标准差为44,共100个样本
result = np.random.normal(15, 44, 100)
print(result)

# 设定 x 轴范围,基于生成数据的最小值和最大值
x = np.arange(min(result), max(result), 0.1)
# 计算实际数据的均值和标准差
print(result.mean(), result.std())
# 计算理论正态分布的 y 轴值
y = normfun(x, result.mean(), result.std())

# 绘制理论正态分布概率曲线
plt.plot(x, y)
# 绘制实际数据的直方图(归一化)
plt.hist(result, bins=10, rwidth=0.8, density=True)
plt.title('distribution')
plt.xlabel('temperature')
plt.ylabel('probability')
plt.show()上述代码中,np.random.normal(15, 44, 100) 生成了均值为 15、标准差为 44 的 100 个随机数。绘图时,plt.hist 的 density=True 参数确保直方图的总面积为 1,从而可以与理论概率密度曲线进行有效对比。需要注意的是,由于正态分布理论上覆盖从负无穷到正无穷的区间,而绘图仅截取了数据的最小值到最大值,因此图中概率总和可能不完全等于 1。
判断序列是否符合正态分布
在实际应用中,验证一组数据是否服从正态分布至关重要。Scipy 库中的 stats.normaltest 函数基于 D'Agostino-Pearson 检验,能够综合偏度和峰度来评估数据是否符合正态分布。该检验的原假设(Null Hypothesis)是数据来自正态分布。
假设检验逻辑
import numpy as np
from scipy import stats

pts = 1000
np.random.seed(28041990)
# 生成两个不同的正态分布序列
a = np.random.normal(0, 1, size=pts)
b = np.random.normal(2, 1, size=pts)
# 将两个分布拼接,理论上形成非正态分布序列
x = np.concatenate((a, b))

# 执行正态性检验
k2, p = stats.normaltest(x)
alpha = 1e-3  # 显著性水平
print("p = {:g}".format(p))

# 根据 p 值判断原假设
if p < alpha:
  print("The null hypothesis can be rejected") # 拒绝原假设,即不是正态分布
else:
  print("The null hypothesis cannot be rejected") # 无法拒绝原假设,可能是正态分布
在示例中,我们将两个均值不同(0 和 2)但标准差相同(1)的正态分布序列拼接,理论上这会导致数据呈现双峰分布,从而偏离正态分布。通过 stats.normaltest 得到的 p 值若小于设定的显著性水平(如 1e-3),则拒绝原假设,判定该序列不符合正态分布。
求置信区间与异常值检测
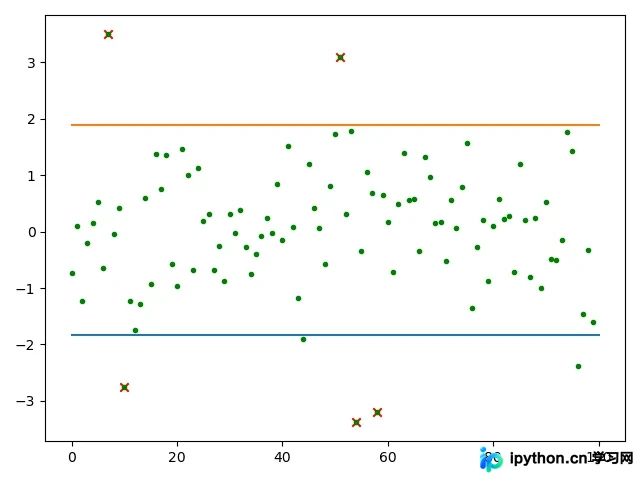
除了分布形态,统计推断中常需计算置信区间以评估数据的波动范围,并识别异常值。置信区间反映了在给定置信水平下,总体参数可能存在的范围。而异常值检测通常基于四分位距(IQR)法则,即超出 [Q1 - 1.5*IQR, Q3 + 1.5*IQR] 范围的数据点被视为异常值。
置信区间与异常值计算
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats
import pandas as pd

# 求列表数据的异常点
def get_outer_data(data_list):
  df = pd.DataFrame(data_list, columns=['value'])
  df = df.iloc[:, 0]
  # 计算下四分位数和上四分位
  Q1 = df.quantile(q=0.25)
  Q3 = df.quantile(q=0.75)
  # 基于1.5倍的四分位差计算上下须对应的值
  low_whisker = Q1 - 1.5 * (Q3 - Q1)
  up_whisker = Q3 + 1.5 * (Q3 - Q1)
  # 寻找异常点
  kk = df[(df > up_whisker) | (df < low_whisker)]
  data1 = pd.DataFrame({'id': kk.index, '异常值': kk})
  return data1

N = 100
result = np.random.normal(0, 1, N)
mean, std = result.mean(), result.std(ddof=1) # 求均值和标准差

# 计算90%置信区间
conf_intveral = stats.norm.interval(0.9, loc=mean, scale=std)
print('置信区间:', conf_intveral)

x = np.arange(0, len(result), 1)
# 求异常值
outer = get_outer_data(result)
print(outer, type(outer))
x1 = outer.iloc[:, 0]
y1 = outer.iloc[:, 1]

# 绘图:离散点、异常点及置信区间线
plt.scatter(x1, y1, marker='x', color='r') # 所有离散点
plt.scatter(x, result, marker='.', color='g') # 异常点
plt.plot([0, len(result)], [conf_intveral[0], conf_intveral[0]])
plt.plot([0, len(result)], [conf_intveral[1], conf_intveral[1]])
plt.show()
在 get_outer_data 函数中,通过计算 Q1 和 Q3 得到四分位距 IQR,进而确定上下界。置信区间则通过 stats.norm.interval 计算,这里设定置信水平为 0.9(即 90%)。绘图时,红色 'x' 标记异常值,绿色 '.' 标记正常离散点,水平线表示置信区间边界。
采样点离散图和概率图综合绘制
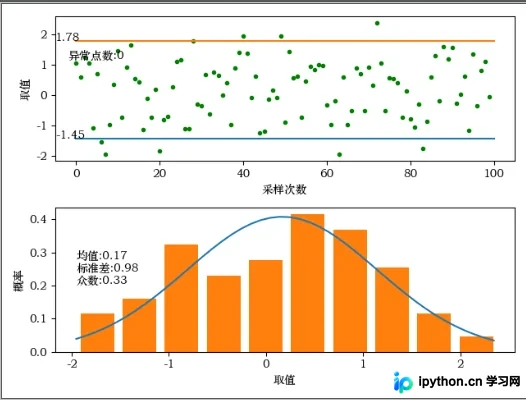
为了更全面地展示数据特征,可以将离散图(显示具体数据点及异常值)与概率图(显示分布形态)组合在同一图表中。此外,代码还处理了标准差为 0 的极端情况(即所有数据点相同),此时无法计算置信区间和概率密度,需进行特殊处理。
综合可视化代码
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats
import pandas as pd
import time

print(time.strftime('%Y-%m-%D %H:%M:%S'))

# 根据均值、标准差,求指定范围的正态分布概率值
def _normfun(x, mu, sigma):
  pdf = np.exp(-((x - mu)**2)/(2*sigma**2)) / (sigma * np.sqrt(2*np.pi))
  return pdf

# 求列表数据的异常点
def get_outer_data(data_list):
  df = pd.DataFrame(data_list, columns=['value'])
  df = df.iloc[:, 0]
  Q1 = df.quantile(q=0.25)
  Q3 = df.quantile(q=0.75)
  low_whisker = Q1 - 1.5 * (Q3 - Q1)
  up_whisker = Q3 + 1.5 * (Q3 - Q1)
  kk = df[(df > up_whisker) | (df < low_whisker)]
  data1 = pd.DataFrame({'id': kk.index, '异常值': kk})
  return data1

N = 100
result = np.random.normal(0, 1, N)
mean, std = result.mean(), result.std(ddof=1)

# 处理标准差为0的情况
if std == 0:
  conf_intveral = [min(result)-1, max(result)+1]
else:
  conf_intveral = stats.norm.interval(0.9, loc=mean, scale=std)

outer = get_outer_data(result)
fig = plt.figure()
fig.add_subplot(2, 1, 1)
plt.subplots_adjust(hspace=0.3)
x = np.arange(0, len(result), 1)
plt.scatter(x, result, marker='.', color='g') # 画所有离散点
plt.scatter(outer.iloc[:, 0], outer.iloc[:, 1], marker='x', color='r') # 画异常离散点
plt.plot([0, len(result)], [conf_intveral[0], conf_intveral[0]]) # 置信区间线条
plt.plot([0, len(result)], [conf_intveral[1], conf_intveral[1]]) # 置信区间线条
plt.text(0, conf_intveral[0], '{:.2f}'.format(conf_intveral[0])) # 置信区间数字显示
plt.text(0, conf_intveral[1], '{:.2f}'.format(conf_intveral[1])) # 置信区间数字显示
info = 'outer count:{}'.format(len(outer.iloc[:, 0]))
plt.text(min(x), max(result)-((max(result)-min(result)) / 2), info) # 异常点数显示
plt.xlabel('sample count')
plt.ylabel('value')

# 绘制概率图
if std != 0:
  fig.add_subplot(2, 1, 2)
  x = np.arange(min(result), max(result), 0.1)
  y = _normfun(x, result.mean(), result.std())
  plt.plot(x, y) # 这里画出理论的正态分布概率曲线
  plt.hist(result, bins=10, rwidth=0.8, density=True) # bins个柱状图,宽度是rwidth(0~1),=1没有缝隙
  info = 'mean:{:.2f}\nstd:{:.2f}\nmode num:{:.2f}'.format(mean, std, np.median(result))
  plt.text(min(x), max(y) / 2, info)
  plt.xlabel('value')
  plt.ylabel('Probability')
else:
  fig.add_subplot(2, 1, 2)
  info = 'non-normal distribution!!\nmean:{:.2f}\nstd:{:.2f}\nmode num:{:.2f}'.format(mean, std, np.median(result))
  plt.text(0.5, 0.5, info)
  plt.xlabel('value')
  plt.ylabel('Probability')
plt.savefig('./distribution.jpg')
plt.show()

print(time.strftime('%Y-%m-%D %H:%M:%S'))
该综合示例首先检查标准差是否为 0。若不为 0,则正常计算置信区间并绘制概率密度曲线与直方图;若为 0(所有数据相同),则提示“非正态分布”并显示均值和标准差信息。图表分为上下两部分:上部展示采样点的离散分布及异常值标记,下部展示数据的概率分布形态。最终结果保存为 distribution.jpg。
总结
通过上述步骤,我们完成了正态分布数据的生成、可视化、正态性检验以及异常值与置信区间的计算。这些工具在数据预处理、统计分析及质量控制中具有广泛应用。掌握 numpy 的随机数生成、scipy 的统计检验以及 matplotlib 的绘图技巧,能够有效提升数据分析的效率与准确性。
以上就是Python生成正态分布数据并绘图与统计检验的详细内容,更多关于Python正态分布、数据可视化、假设检验的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









