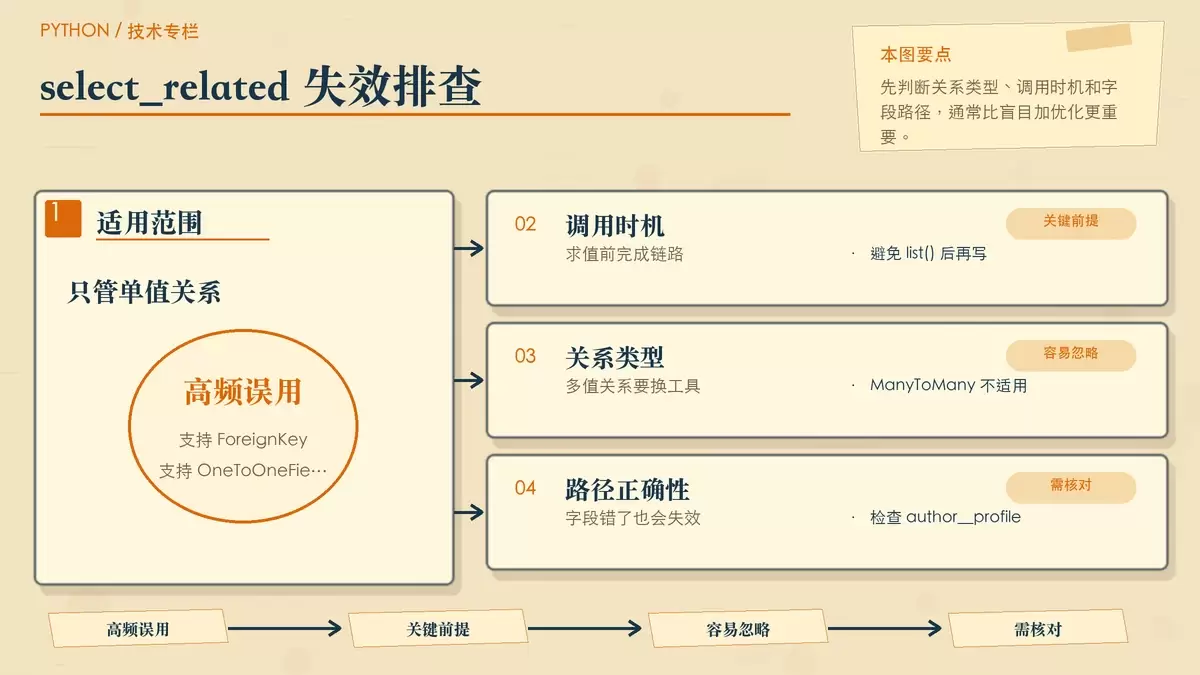
Django 里 `select_related` 为什么没生效?适用范围、顺序与排查方法一次说清
在 Django 里用了 `select_related()` 却还是出现 N+1,问题通常不在“有没有写”,而在是否用对了关系类型、调用时机和查询路径。本文把 `select_related` 的适用范围、常见失效场景、与 `prefetch_related` 的配合顺序,以及验证方法拆开讲清,方便你快速判断该用 JOIN 还是额外查询。
2026-08-25
183

在 Django 里用了 `select_related()` 却还是出现 N+1,问题通常不在“有没有写”,而在是否用对了关系类型、调用时机和查询路径。本文把 `select_related` 的适用范围、常见失效场景、与 `prefetch_related` 的配合顺序,以及验证方法拆开讲清,方便你快速判断该用 JOIN 还是额外查询。
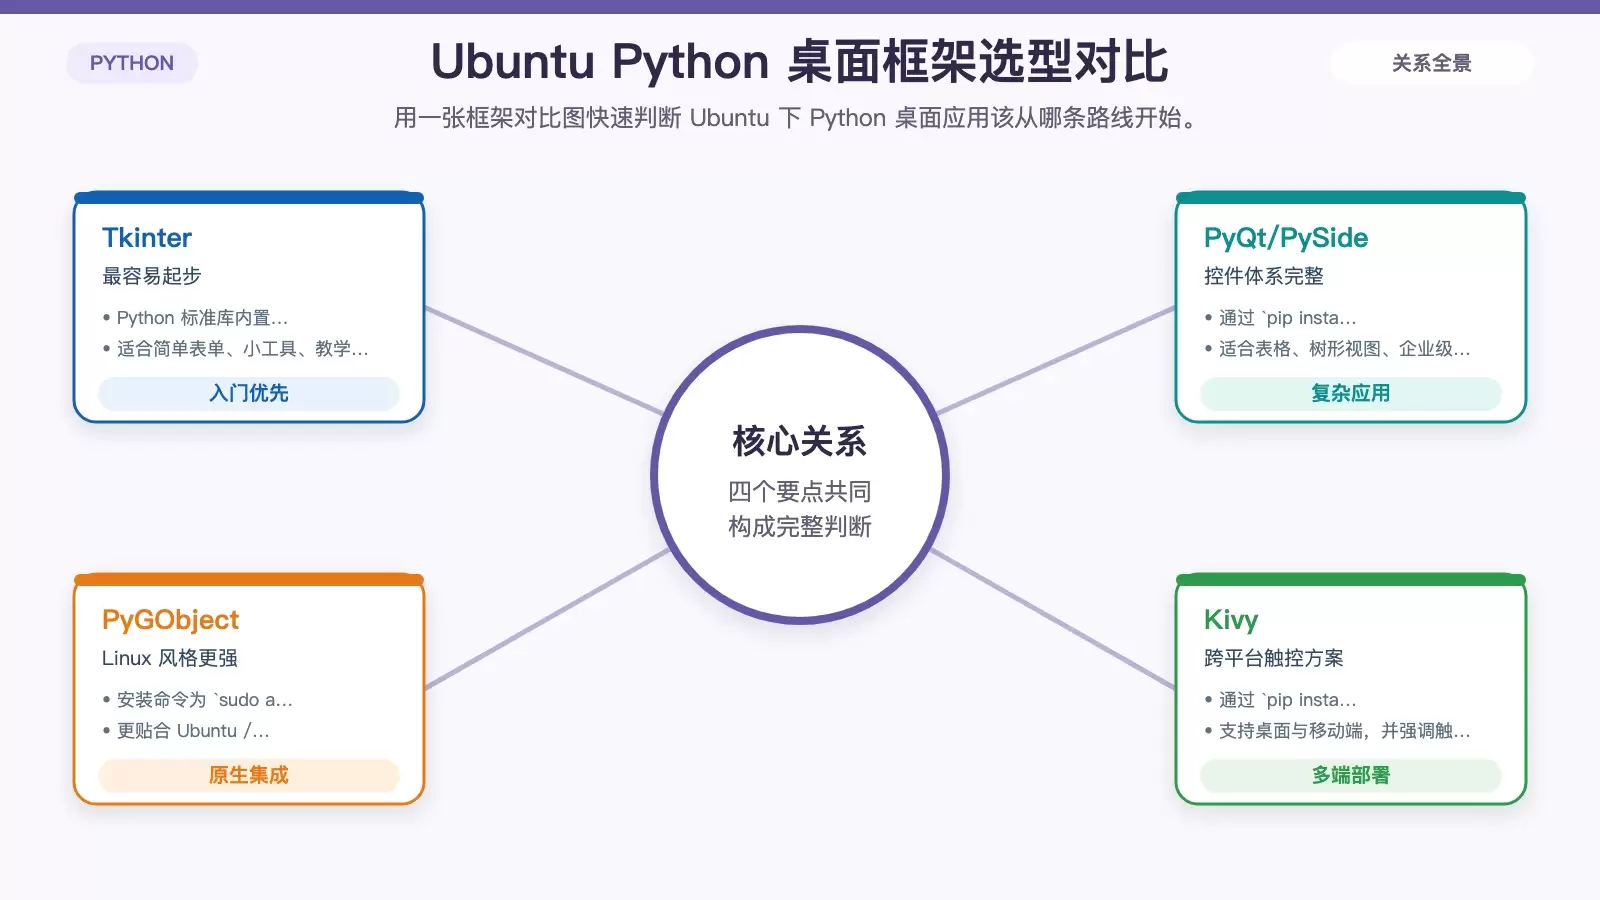
在 Ubuntu 上用 Python 做桌面应用,关键不在“能不能做”,而在于选对 GUI 框架。本文按入门难度、原生集成、跨平台能力和应用场景,梳理 Tkinter、PyQt/PySide、PyGObject、Kivy 四条路线,并保留安装命令与示例代码,方便直接上手。 在 Ubuntu 上开发 Python 桌面应用,真正决定效率的往往不是语法,而是前期框架选型是否贴合项目目标。
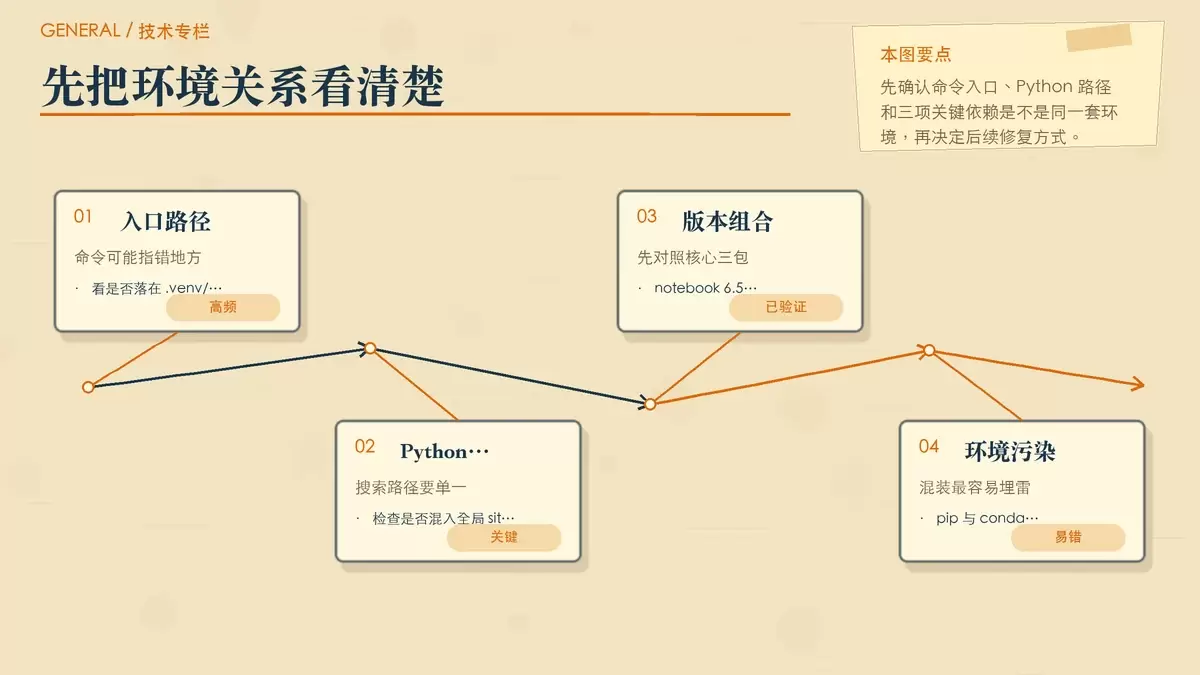
Jupyter Notebook 启动时报出“No module named”时,问题通常不在“少装了一个包”,而在环境路径、依赖版本或命令入口错位。本文围绕最常见的 `jupyter_server.contents` 报错,拆开说明触发原因、检查方法,以及一套更省时间的修复与重建环境思路。
在 CentOS 部署 Python 应用时,安全配置不能只盯着单个环节。本文从环境隔离、权限控制、网络访问、SELinux、更新、HTTPS、输入校验到密钥与日志管理,梳理一套可直接落地的加固清单。 把 Python 应用部署到 CentOS,上线后真正容易出问题的,往往不是业务代码本身,而是运行环境、权限边界和网络暴露面没有先收紧。
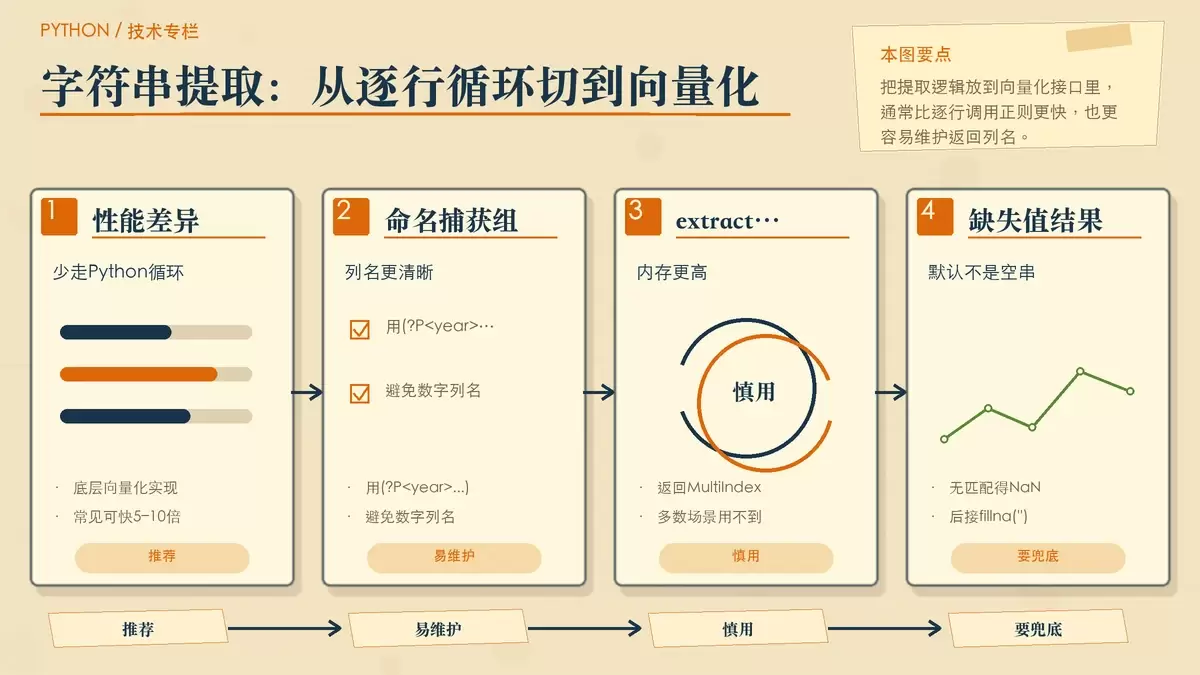
处理百万级字符串列时,性能瓶颈往往不在正则本身,而在 Python 层循环、返回结构和空值处理。本文围绕 pandas 的 `str.extract` 与 `str.replace`,梳理提取、替换、内存控制和超大规模并行处理中的关键写法与常见坑点。
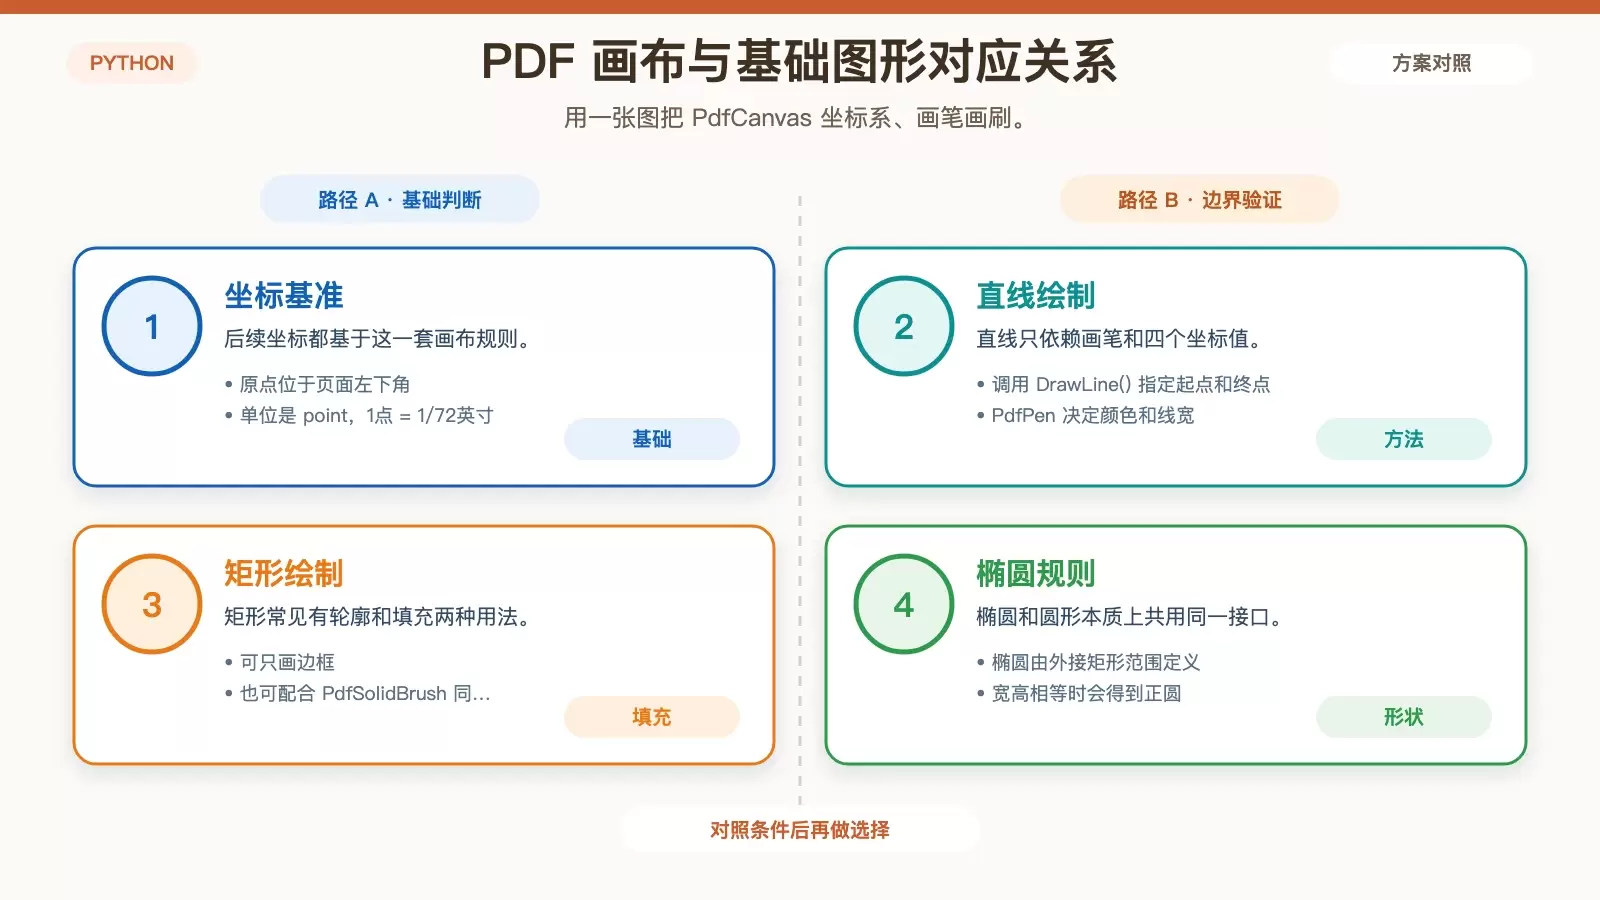
这篇文章围绕 Python 操作 PDF 的常见绘图需求,梳理了 Spire.PDF 中直线、虚线、矩形、椭圆、自定义路径和透明度控制的基本用法。文中保留关键代码与参数说明,并给出适合报表、标注和模板生成场景的判断重点。
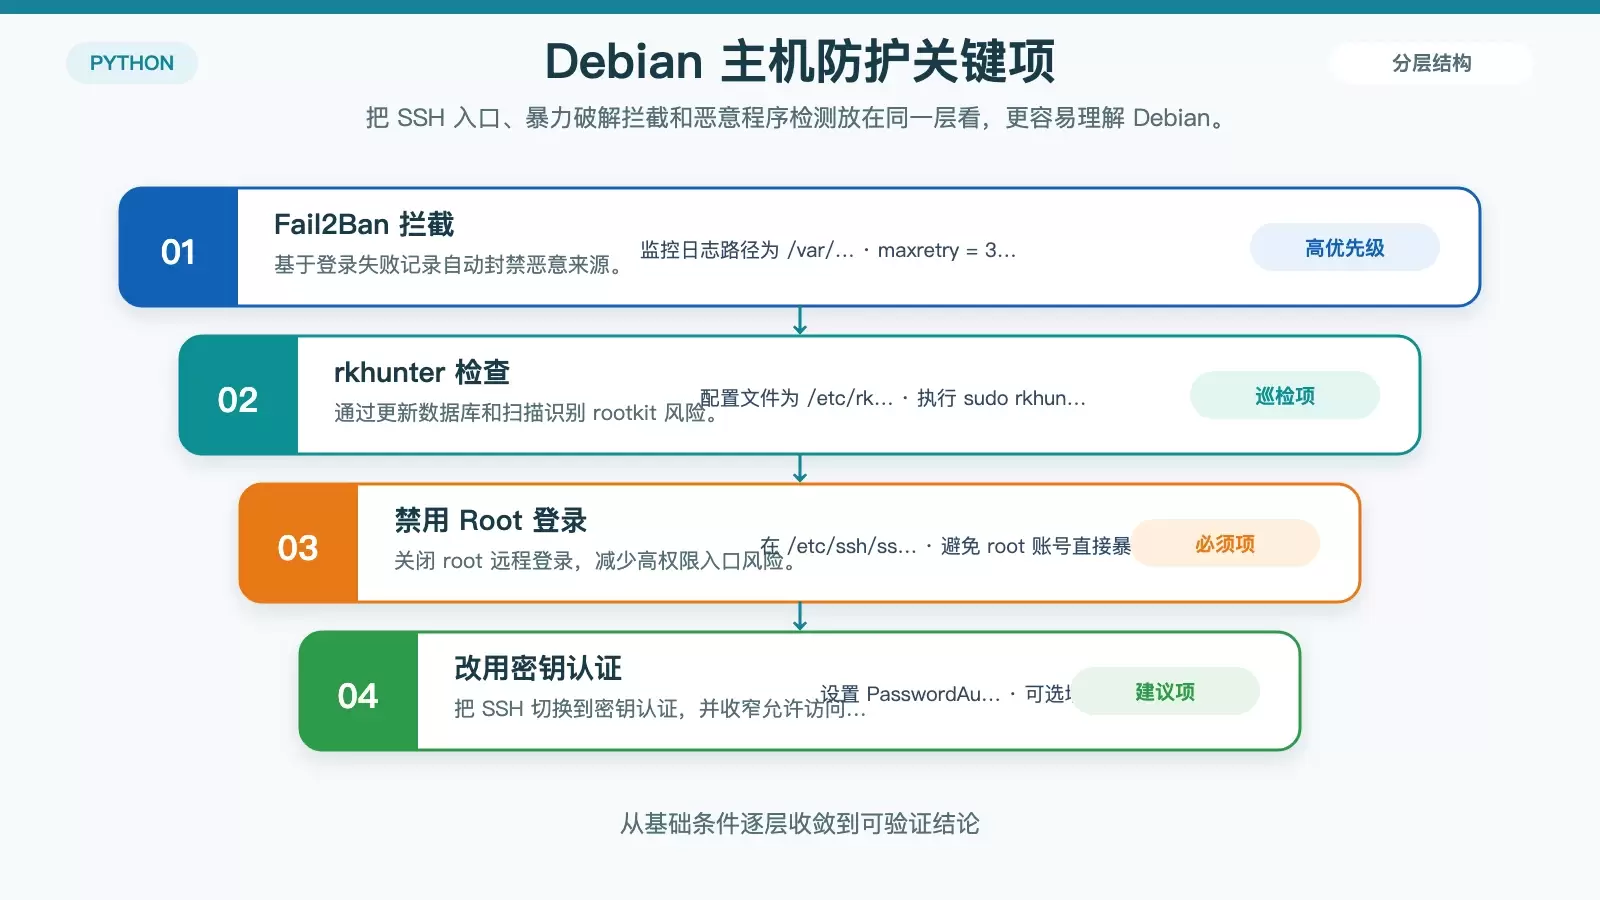
这篇文章把 Debian 上的 Python 安全配置拆成一套可直接执行的清单:先补系统和 Python 基础环境,再做虚拟环境隔离、SSH 与主机防护、依赖审计、代码层加固,以及可选的 SELinux 隔离,最后补上日常巡检重点。
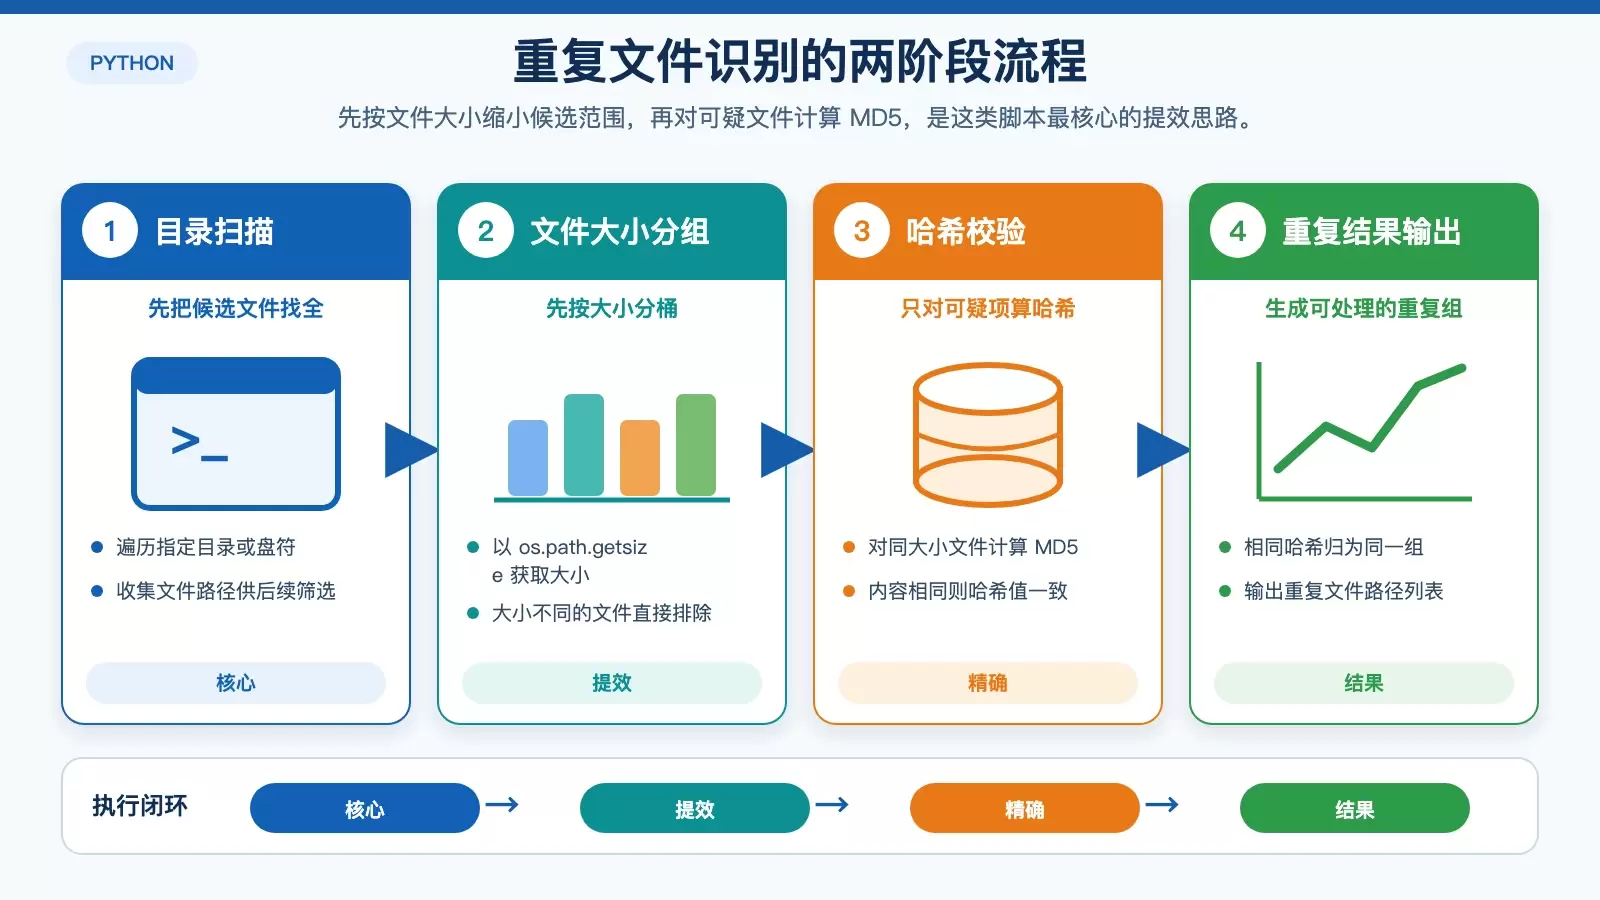
这篇文章用 Python 搭一个重复文件清理工具,核心思路是“先按文件大小筛选,再用 MD5 精确比对”。文中保留关键脚本与优化方法,并补充删除策略、权限处理、性能调优和 GUI 扩展,方便按实际场景落地。
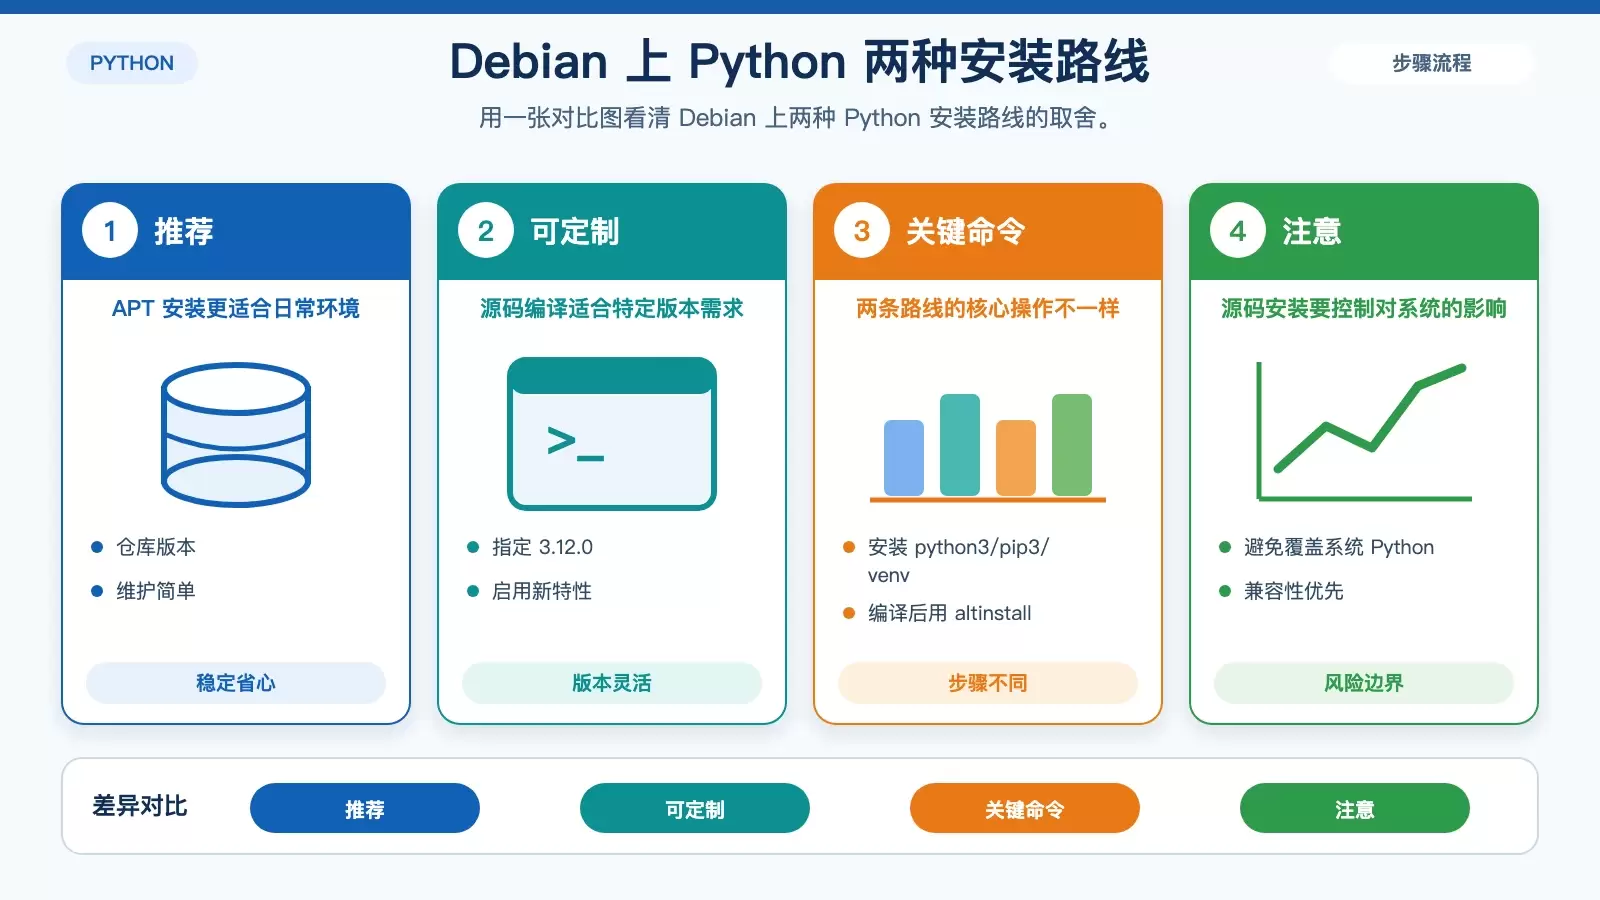
在 Debian 上搭建 Python 环境,关键不在于命令多少,而在于先把系统依赖、安装方式和版本管理的边界理顺。本文按实际使用场景拆解 APT 安装、源码编译、虚拟环境和路径配置,帮助你在稳定性与灵活性之间做出合适选择。
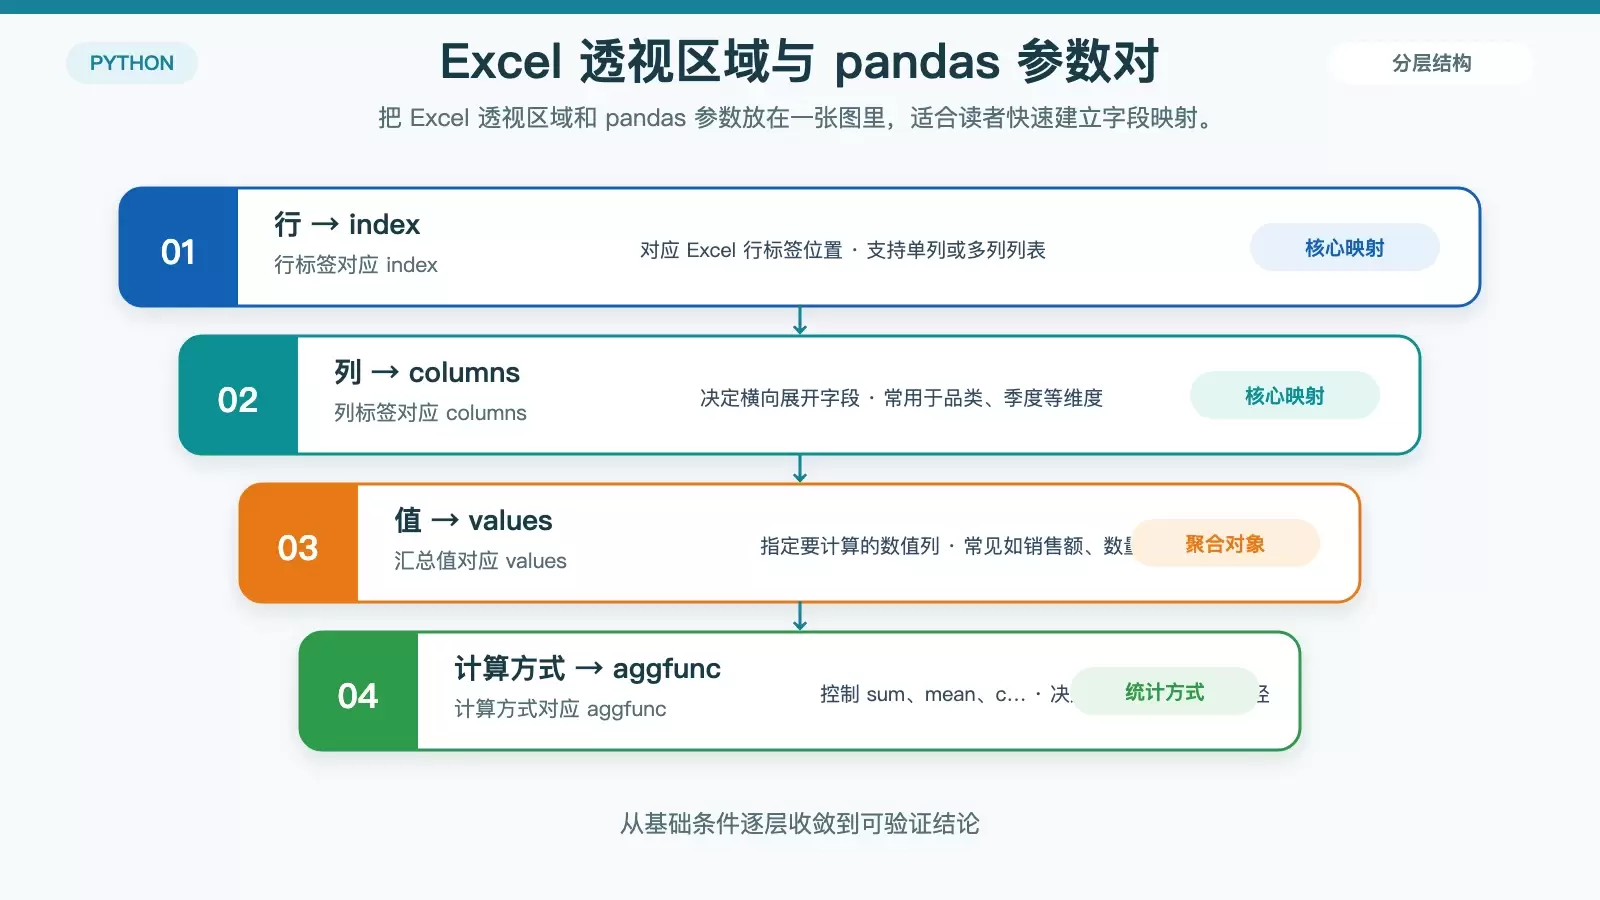
这篇文章从 Excel 用户最熟悉的数据透视表思路切入,拆解 pandas `pivot_table` 的常用参数、层级汇总和多统计值写法,再延伸到批量处理多个文件、多个 Sheet 与多报表导出的实战流程,适合拿来替代重复的手工拖拽。
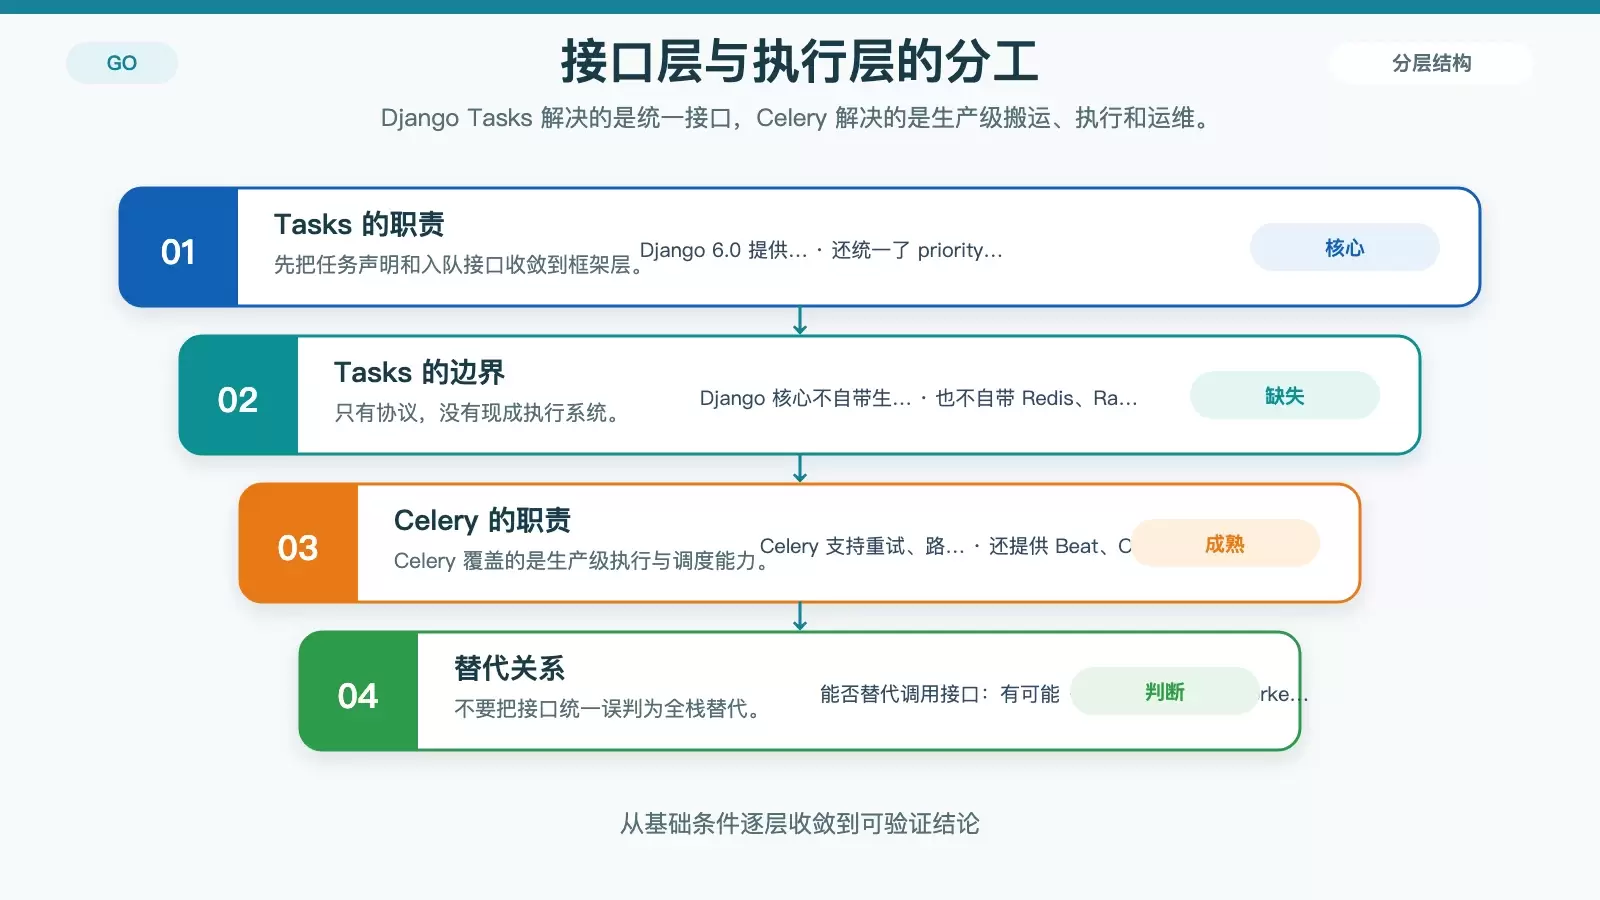
实测 Django 6.0.7 自带 Tasks、Celery 5.6.3 与本机 Redis 后可以确认:Tasks 统一了任务声明和入队接口,但并不自带生产可用的消息队列与 Worker。它能降低业务层对具体任务库的耦合,却不能单独替代 Celery 的执行、重试、路由与运维能力。
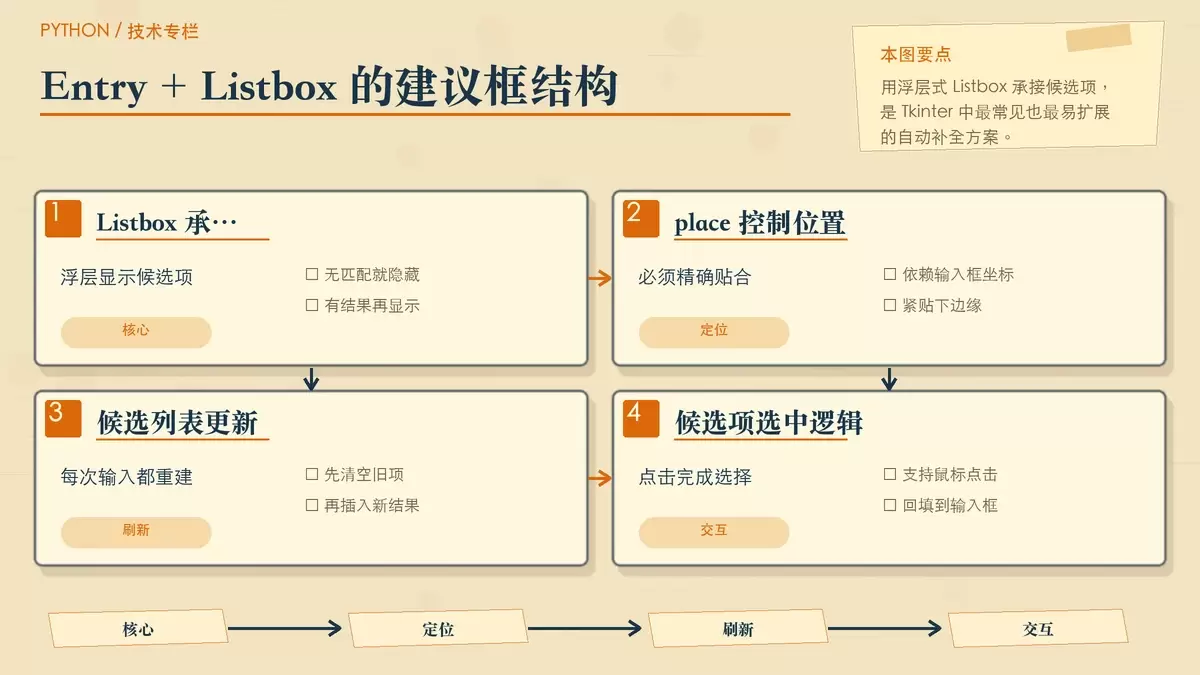
Tkinter 的 Entry 没有原生自动补全能力,常见的搜索建议框其实是 Entry、Listbox 和事件处理拼起来的交互组件。本文从为什么不能直接开箱即用讲起,再拆解轻量实现方式、Combobox 的局限,以及决定可用性的焦点、显隐和防抖细节。