


很多 Django 项目在优化列表页或模板渲染时,第一反应都是补一个 select_related()。但实际排查里更常见的情况是:代码看起来写了优化,Django Debug Toolbar 仍然提示 N+1,或者 SQL 根本没有生成预期的 JOIN。
要把这个问题看明白,关键不只是记住 API 名字,而是确认三件事:它是不是只用于单值关系、是不是在 QuerySet 被求值之前调用、以及后续代码访问的字段路径是否真的被覆盖。把这几处理顺后,select_related 什么时候有效、什么时候该换成 prefetch_related,判断就会清楚很多。
为什么 select_related 看起来写了却没生效?
select_related 的作用是把单值关系直接折叠进主查询,通过 SQL JOIN 一次取回关联对象。它并不是“只要写上就会优化”的开关,几个常见误区都会让它静默失效。
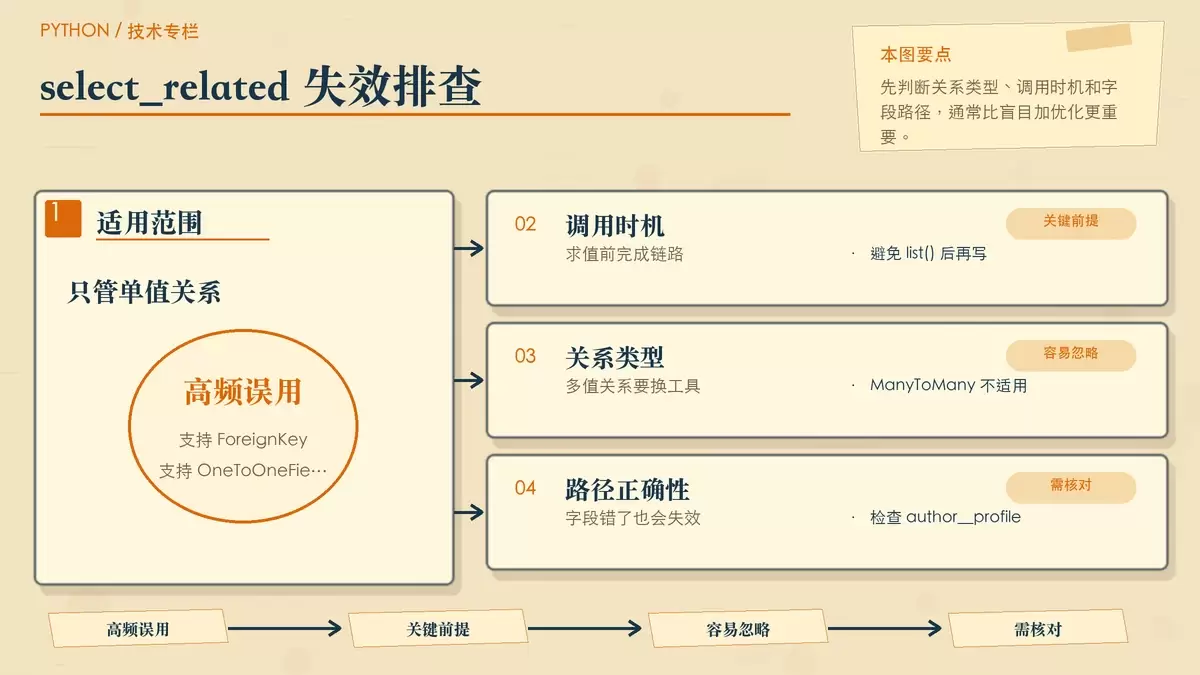
它只支持单值关系
这个方法只对 ForeignKey 和 OneToOneField 这类单值关系有效。原因很直接:每条主记录最多只对应一个关联对象,数据库可以安全地通过 JOIN 把结果拼到一行里。
如果你把它用在 ManyToManyField 或反向 ForeignKey 上,Django 不会按你预期完成预取。像下面这类需求,本质上就不该交给 select_related:
- 一本书对应多个标签
- 一个作者对应多本书
- 反向访问类似
author.book_set.all()的结果集
这类多值关系应该改用 prefetch_related,由 Django 额外发查询,再在内存中完成关联。
调用位置必须在 QuerySet 上游
另一个高频问题是调用时机太晚。QuerySet 一旦被求值,后面再链式调用 select_related,通常已经没有意义了。常见触发求值的操作包括:
list(queryset)len(queryset)- 直接遍历
- 在模板或日志里提前消费了结果
也就是说,优化必须发生在真正执行 SQL 之前,而不是等结果已经取回后再补链路。
字段路径写错,也可能表现为“没报错但没优化”
实际项目里还有一种很隐蔽的情况:路径写了,但字段名不对,结果 SQL 里没有你期待的 JOIN。例如:
select_related('author__profile')如果 Author 模型里并没有 profile 这条关系,那么这段写法就不会起到预期作用。排查时不要只盯着 Python 代码本身,还要去看生成出来的 SQL。
嵌套查询能写多深,边界在哪里?
select_related 支持跨多层关系继续展开,例如:
select_related('author__company__address')Django 会按这条路径生成对应层级的 LEFT OUTER JOIN。这在读取明确、关系稳定的字段时很方便,但深度并不是越大越好。
JOIN 变多后,SQL 成本会明显上升
每多一层关系,主查询就多一张 JOIN 表。关联层级变深以后,数据库需要处理更复杂的执行计划,结果集体积、内存占用和 I/O 压力都会上升。文章里提到的一个典型风险是:某些层级一旦数据分布复杂,结果行数可能接近笛卡尔积式膨胀。
这类代价并不总是马上体现在代码层,而会体现在慢 SQL、数据库负载升高或页面响应时间不稳定上。
不是所有“可能会用到”的字段都值得 JOIN
例如页面最终只显示 author.name,却写成:
select_related('author__company__address')那就属于典型的过度预取。你虽然提前拿到了更多字段,但这些数据并没有被真正消费,反而增加了查询负担。
更稳妥的原则是:只为当前视图、模板或序列化逻辑里确定会访问的外键路径做 select_related,而且优先从访问最频繁、最直接的那一层开始,而不是一口气穿透多个模型。
深层 JOIN 还会受数据库规划策略影响
当 JOIN 层级继续增加时,数据库优化器也会介入权衡。比如 PostgreSQL 提到的 from_collapse_limit,就可能影响复杂 JOIN 的处理方式,超过阈值后执行计划可能退化为子查询或出现更保守的规划。对 Django 开发者来说,这意味着优化不能只看 ORM 写法是否“高级”,还要结合数据库实际执行表现来判断。
和 prefetch_related 混用时,顺序怎么放?
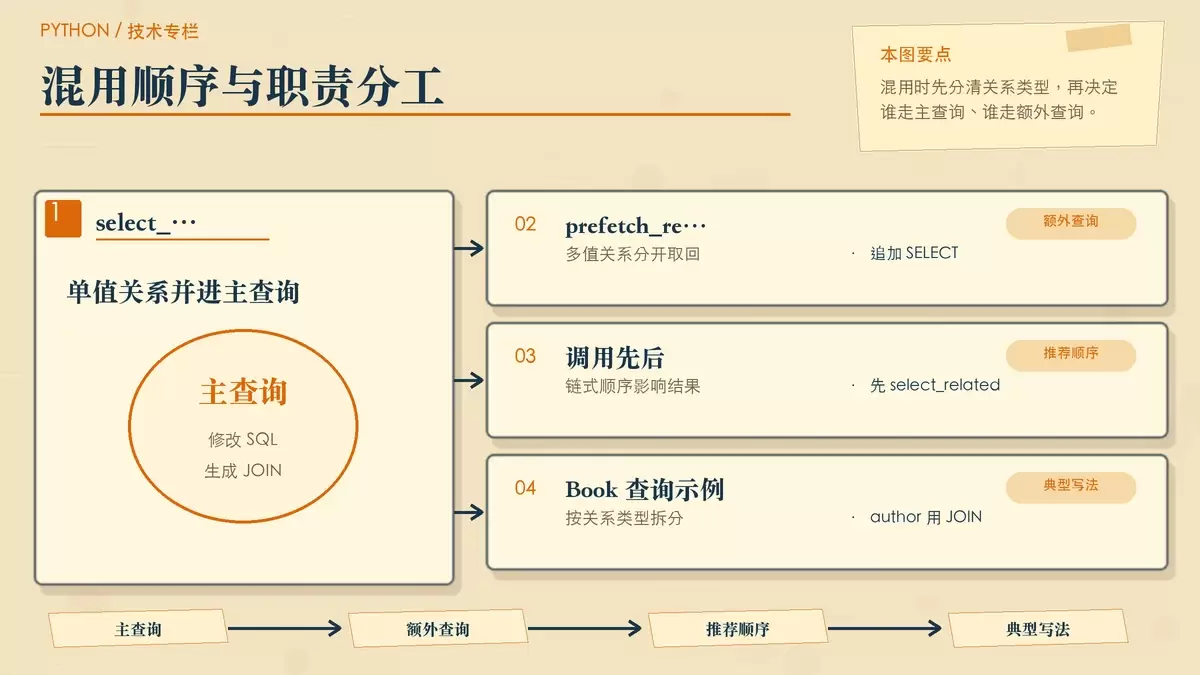
在真实业务里,单值关系和多值关系经常同时存在,因此 select_related 与 prefetch_related 混用很常见。但两者职责不同,顺序也不能随意写。
两者处理机制不同
select_related修改主查询 SQL,通过 JOIN 一次带回单值关系prefetch_related额外发送 SELECT,再在 Python 内存里做拼接
前者是“把关联并进主查询”,后者是“拆成多次查询再组装”。理解这点后,为什么不能乱排顺序就容易解释了。
推荐把 select_related 放在前面
文章给出的结论很明确:select_related 应当放在 prefetch_related 之前。否则,后续链式处理可能导致前面预取的数据失去效果,最终又回到 N+1 查询。
常见、也最稳妥的写法是:
Book.objects.select_related('author').prefetch_related('tags')这段代码表达得很清楚:作者是单值关系,用 JOIN;标签是多值关系,用额外查询。把关系类型和 ORM 工具一一对应,通常比“一个方法处理所有关联”更可靠。
怎么确认它真的起作用了?
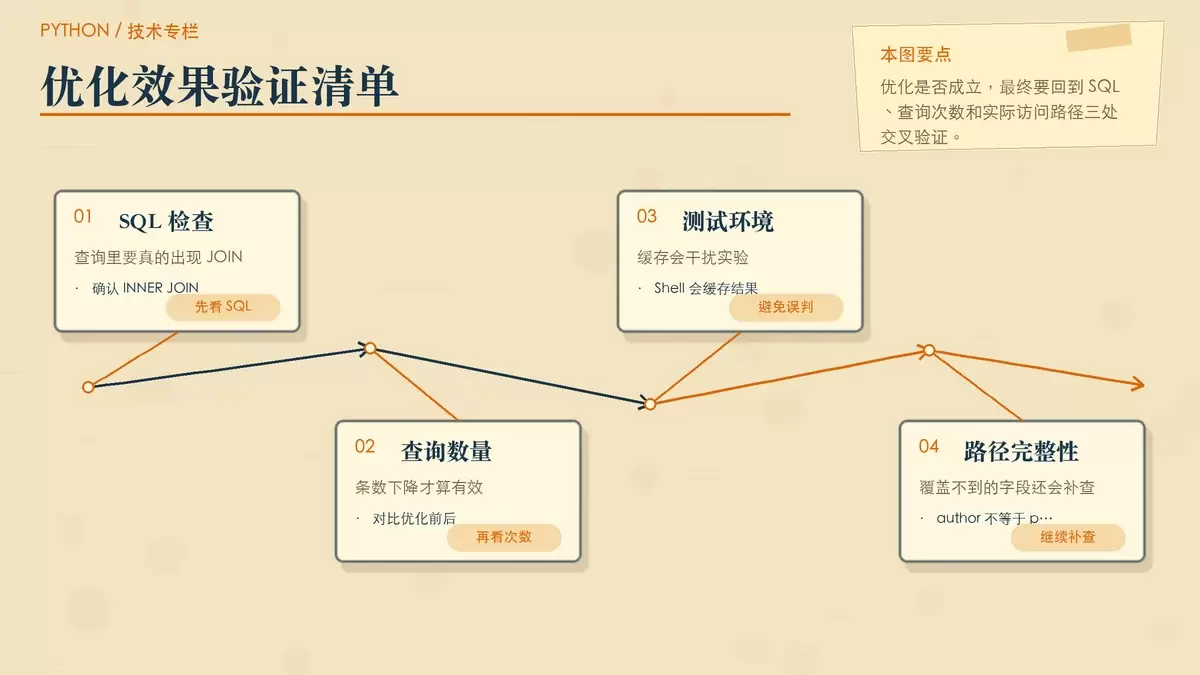
判断 select_related 是否有效,不能只看代码层面“写没写”,必须回到 SQL 和查询次数本身。
先看生成的 SQL
最直接的方法是打印:
str(queryset.query)重点不是把整段 SQL 背下来,而是确认几个信号:
- 有没有出现
INNER JOIN或LEFT OUTER JOIN ON条件是不是你预期的关联路径- JOIN 的表是不是正好对应你声明的字段
如果 SQL 里根本没有 JOIN,那说明优化并没有真正进入主查询。
再看查询次数有没有下降
在 DEBUG=True 的环境下,可以借助 connection.queries 观察请求期间到底执行了多少次 SQL。对比加与不加 select_related 的表现,比单纯看 ORM 代码更能说明问题。
如果主查询确实带上了 JOIN,但查询次数仍偏多,就要继续检查是不是后续逻辑又访问了未覆盖的字段。
注意 QuerySet 缓存带来的误判
在 Django Shell 里反复实验时,QuerySet 结果缓存很容易干扰判断。你以为自己在重复测试同一个查询,实际上第二次开始可能已经直接命中缓存了。更稳妥的方式是每次重新创建 QuerySet,或者补一个 .all() 触发新的查询链路,再去比较差异。
JOIN 出现了,也不代表所有关联都被解决
这是最容易被忽略的一点。即使 SQL 已经出现了 JOIN,如果你的后续代码又访问了没有声明在 select_related 路径里的字段,Django 仍然会继续补查。例如:
book.author.profile.avatar.url如果你只写了 select_related('author'),但没有覆盖 author__profile,那访问 profile 时依旧可能触发新查询。
所以,select_related 不是“打开以后全局免查库”,它只对你明确声明的那条关系路径生效。优化是否完整,最终还是要回到“实际访问了哪些字段”来核对。
实战里可以直接套用的判断规则
如果你只想快速做对,大致可以按下面这套规则判断:
- 单值关系,用
select_related - 多值关系,用
prefetch_related - 优化要写在 QuerySet 被求值之前
- 只声明当前确实会访问的关系路径
- 不要凭感觉判断是否生效,要检查 SQL 和查询次数
归根结底,select_related 的价值不在“语法更短”,而在于它能把本来会分散发生的单值关联查询,收敛成一次可控的 JOIN。只要把适用范围、调用时机和验证方法三件事抓牢,Django 中大多数与它相关的性能问题都能更快定位。









