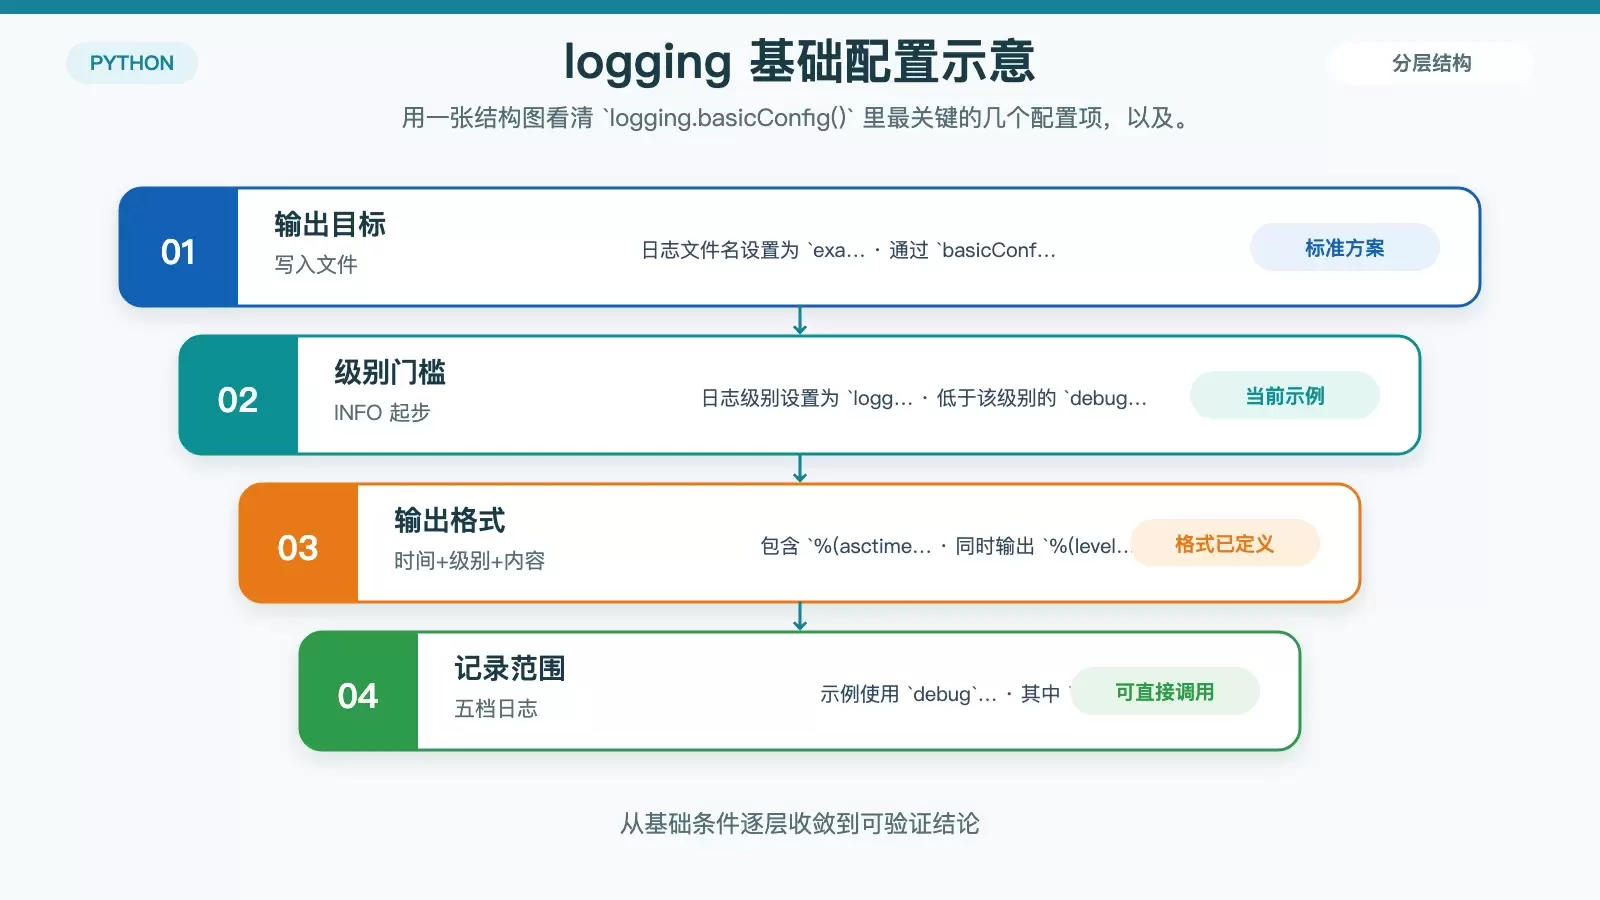
Ubuntu 中 Python 日志怎么记录:`logging` 与 `loguru` 两种常用方法
在 Ubuntu 中给 Python 程序加日志,常见做法主要有两类:标准库 `logging` 和第三方库 `loguru`。前者稳定通用、零额外依赖,后者上手更快,还支持日志轮转。本文按实际使用场景拆解两种写法,并说明各自适合什么需求。
2026-08-23
94

在 Ubuntu 中给 Python 程序加日志,常见做法主要有两类:标准库 `logging` 和第三方库 `loguru`。前者稳定通用、零额外依赖,后者上手更快,还支持日志轮转。本文按实际使用场景拆解两种写法,并说明各自适合什么需求。
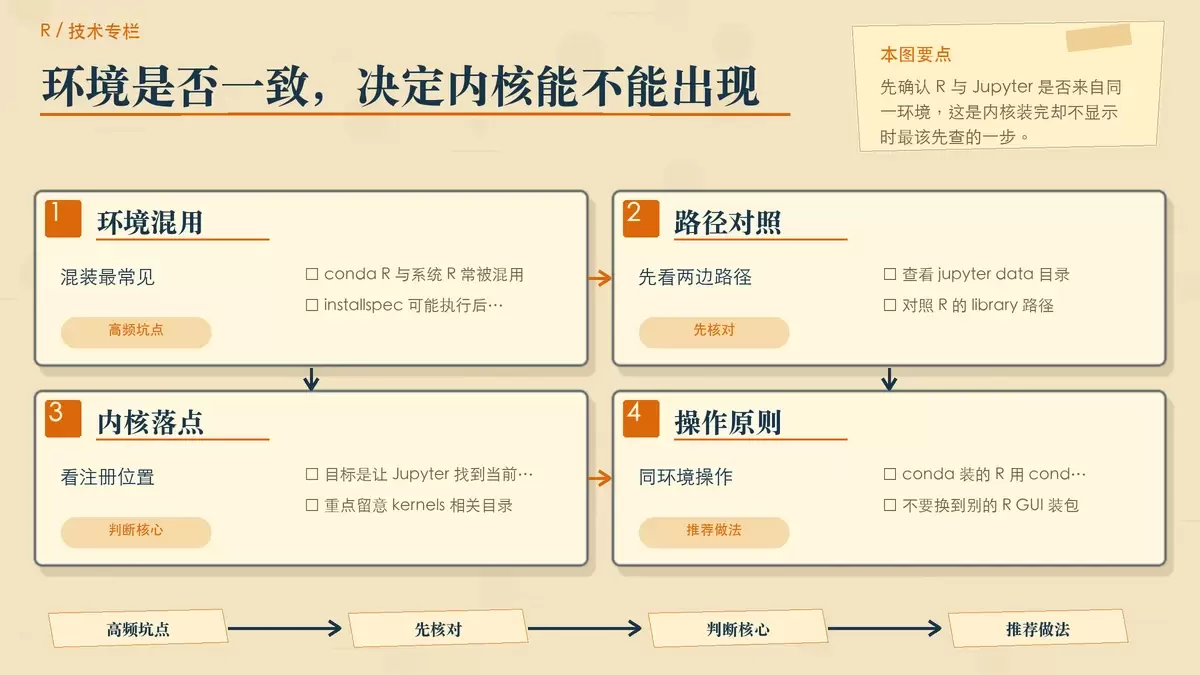
给 Jupyter Notebook 安装 R 语言内核,关键不在于把 IRkernel 装上,而在于让 R 和 Jupyter 处在同一环境里。本文按环境确认、conda 安装、手动注册和故障排查四步整理,帮助你快速判断该走哪条路径,以及为什么“装完没反应”。
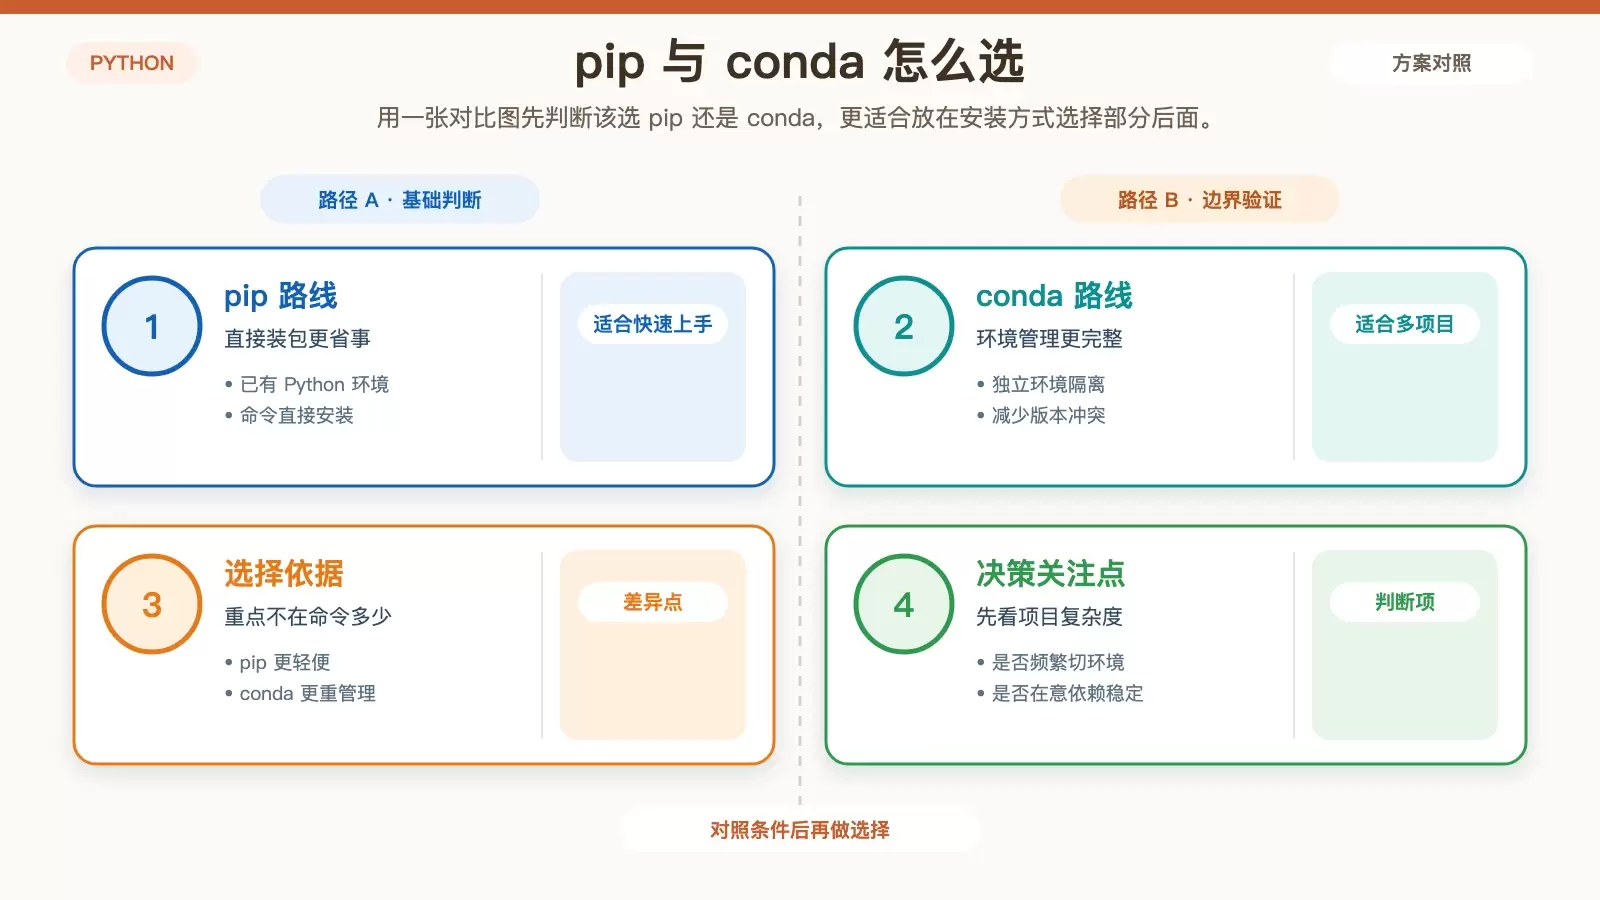
在 Debian 上安装 Python 机器学习库,核心通常就是选 `pip` 还是 `conda`。前者轻便直接,适合已有 Python 环境的用户;后者更强调环境隔离,适合需要控制依赖版本的项目。本文按两条安装路径整理常用命令,并补上 CUDA、权限和基础依赖等关键注意点。
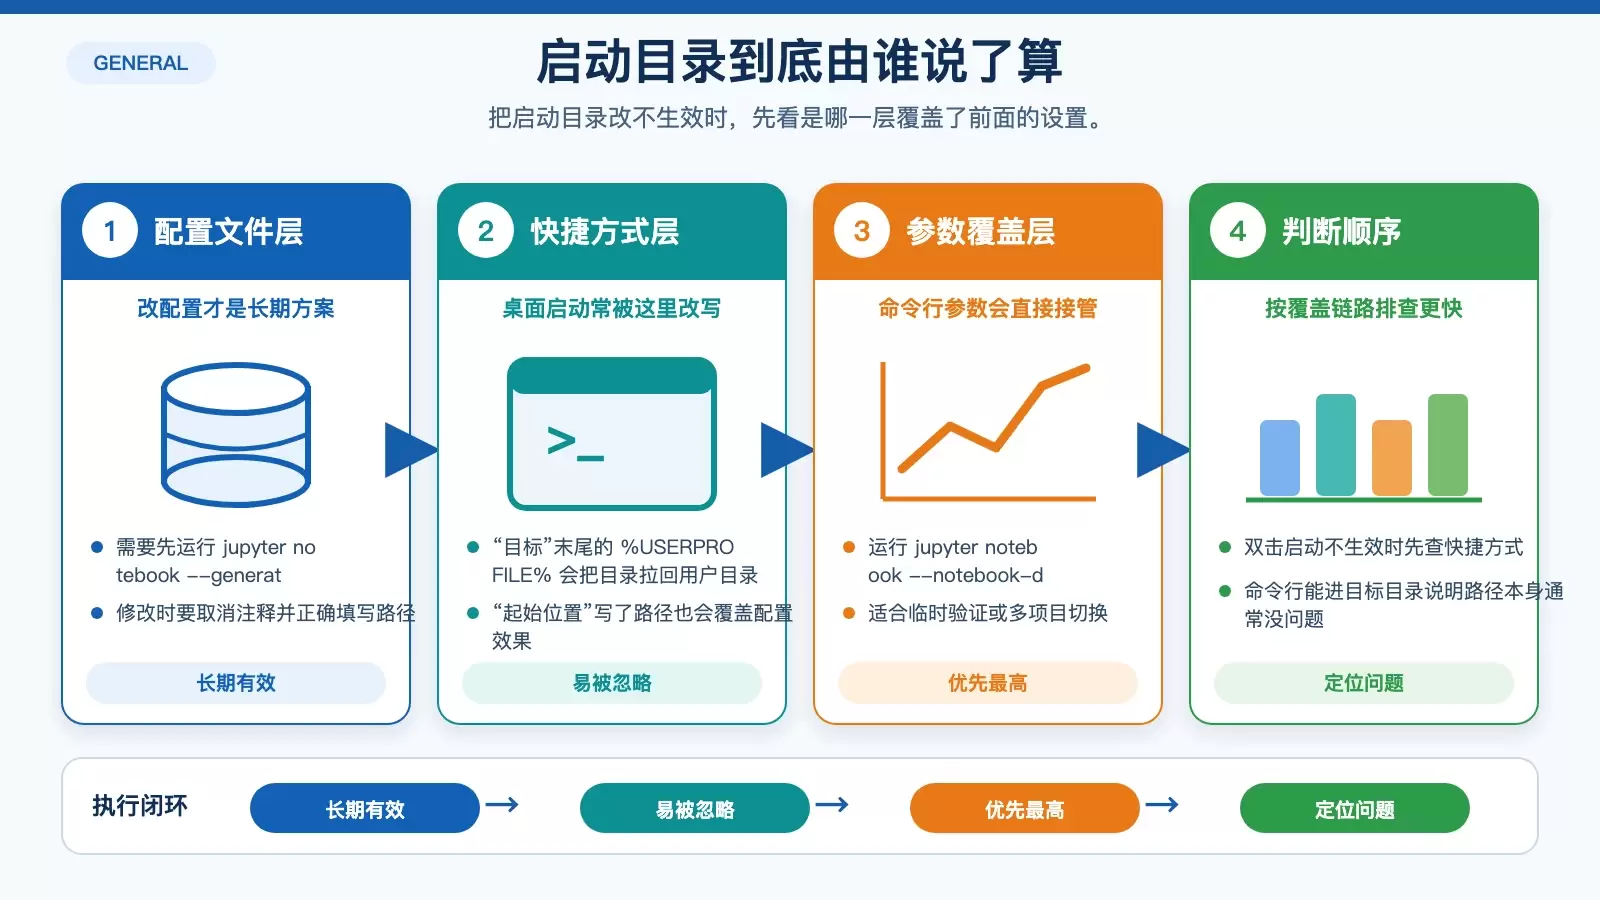
想把 Jupyter Notebook 的默认启动目录固定到指定文件夹,真正长期有效的做法不是改快捷方式,而是修改配置文件里的 `c.NotebookApp.notebook_dir`。本文按“配置生效、快捷方式覆盖、临时验证、故障排查”四步拆开,帮你快速判断哪一层在接管启动路径。
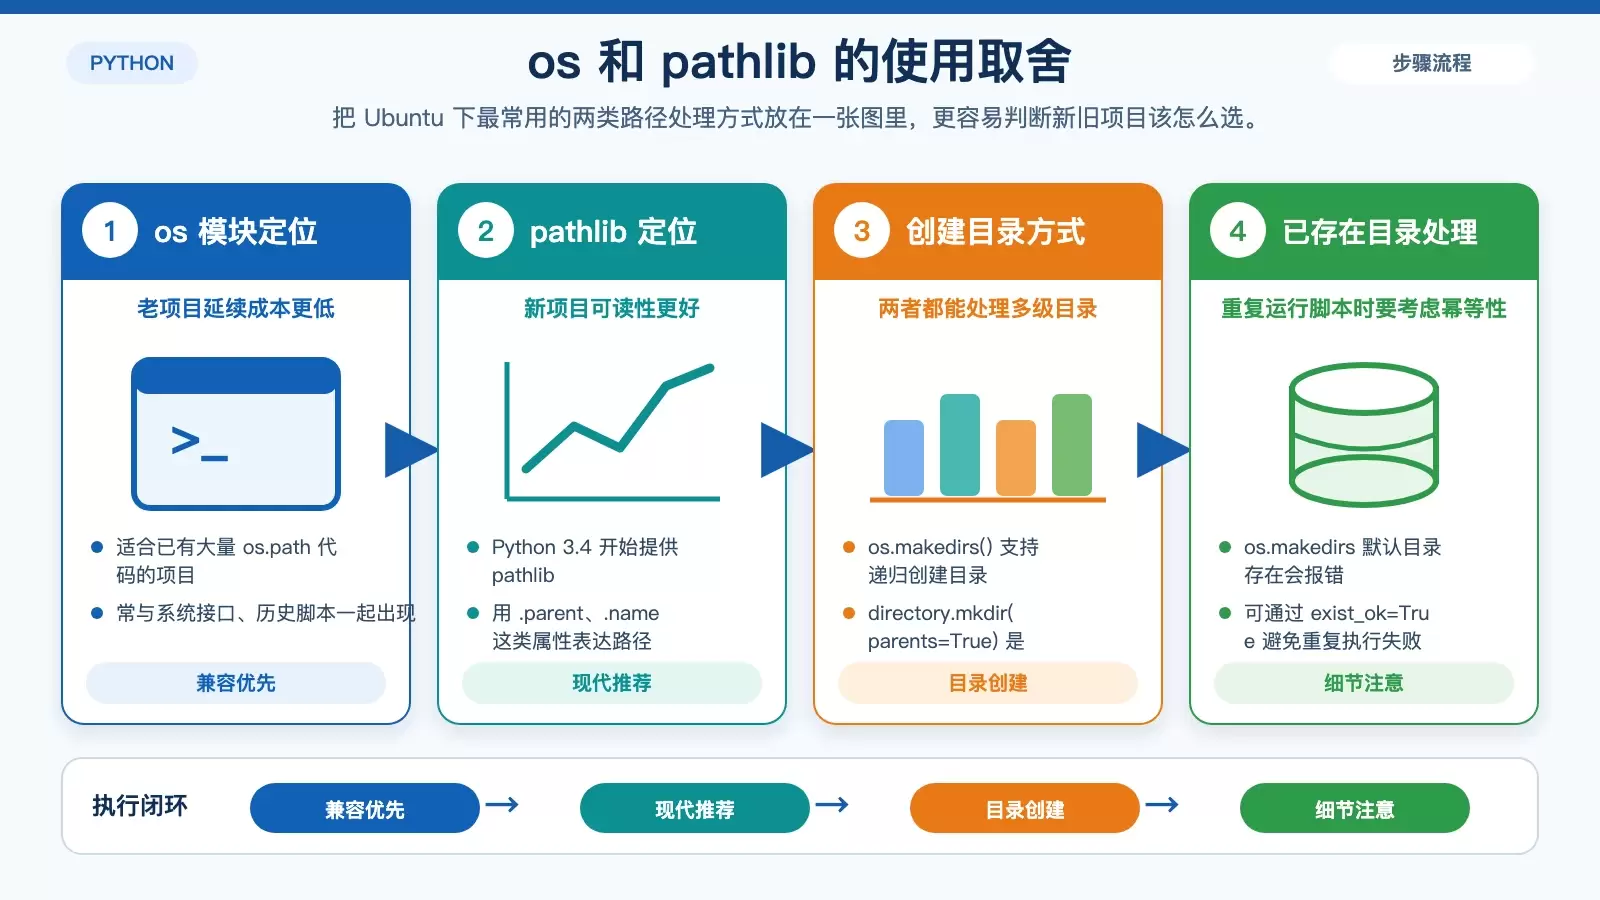
在 Ubuntu 环境里写 Python 文件操作,真正拉开差距的往往不是语法本身,而是资源管理、异常兜底、路径处理和大文件性能这些细节。本文按实际开发场景梳理 `with`、`try-except`、`os`、`pathlib`、缓冲写入与 `shutil` 的用法,方便你快速选出更稳妥的实现方式。
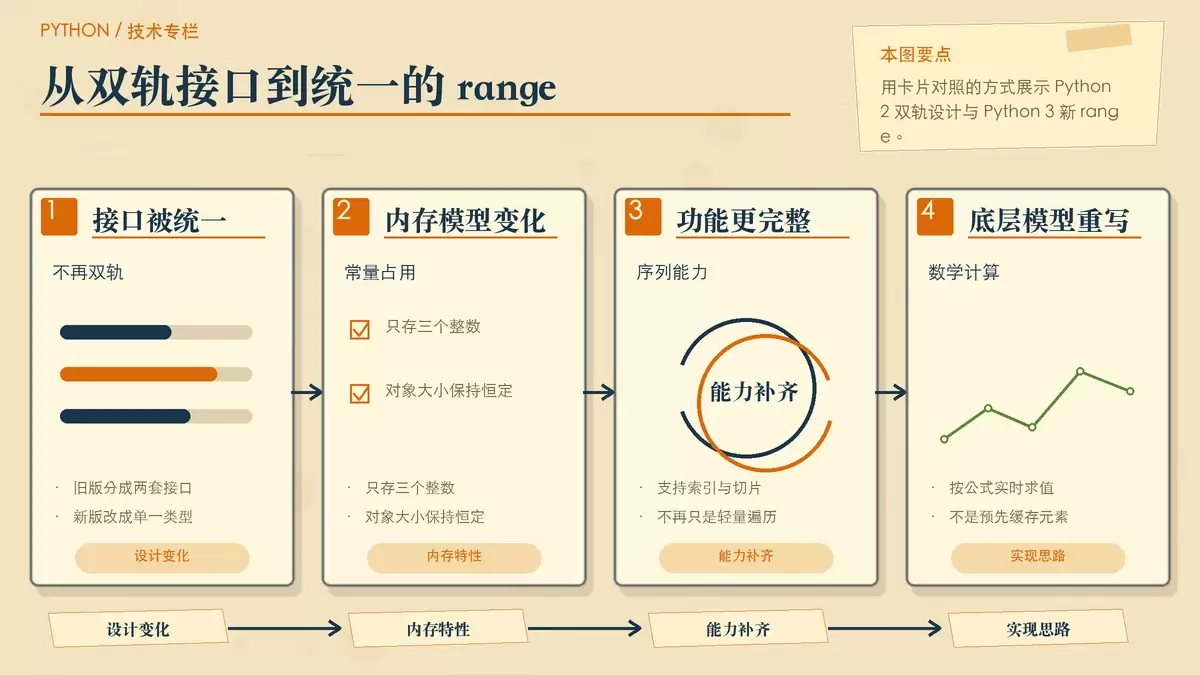
很多人把 Python 3 的 `range` 理解成“把 Python 2 的 `xrange` 改了个名字”,这其实不准确。它真正的变化是:`range` 被重写成不可变序列类型,既保留了惰性、省内存的特性,又补上了索引、切片和高效成员判断等能力。 很多人把 Python 3 里的 range 直接等同于 Python 2 的 xrange ,这能帮助记忆,却不足以指导迁移。
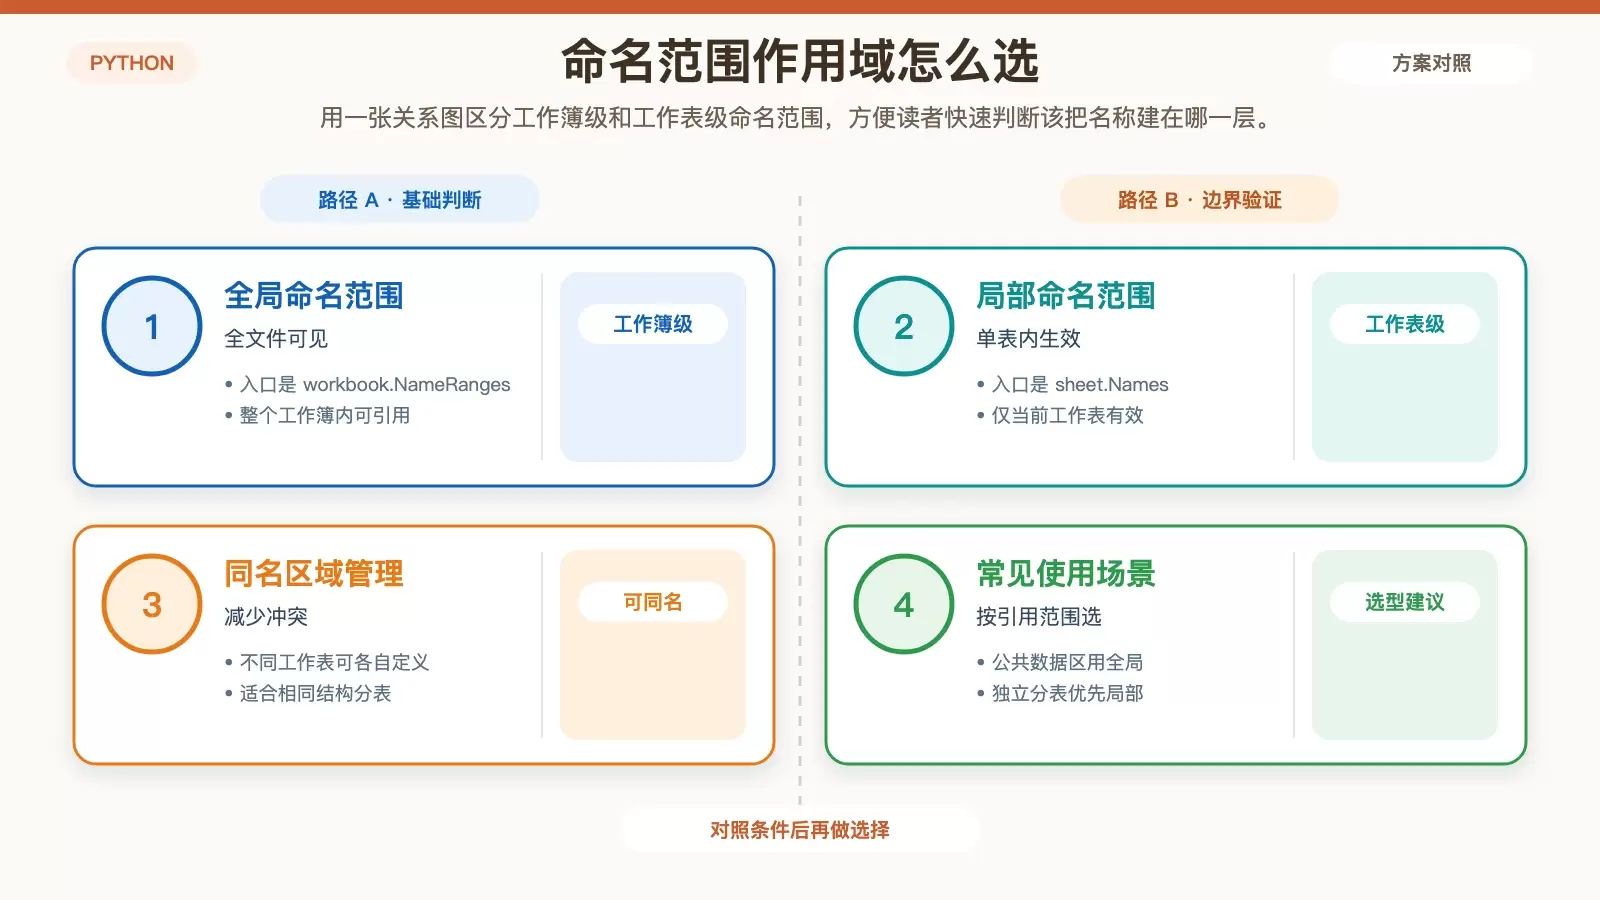
命名范围能把 Excel 里难记的 A1:D10 变成可读的业务名称,适合公式复用和自动化脚本维护。本文用 Spire.XLS for Python 梳理创建、查询、重命名、样式处理、公式引用与删除等常见操作,并说明工作簿级与工作表级作用域该怎么选。
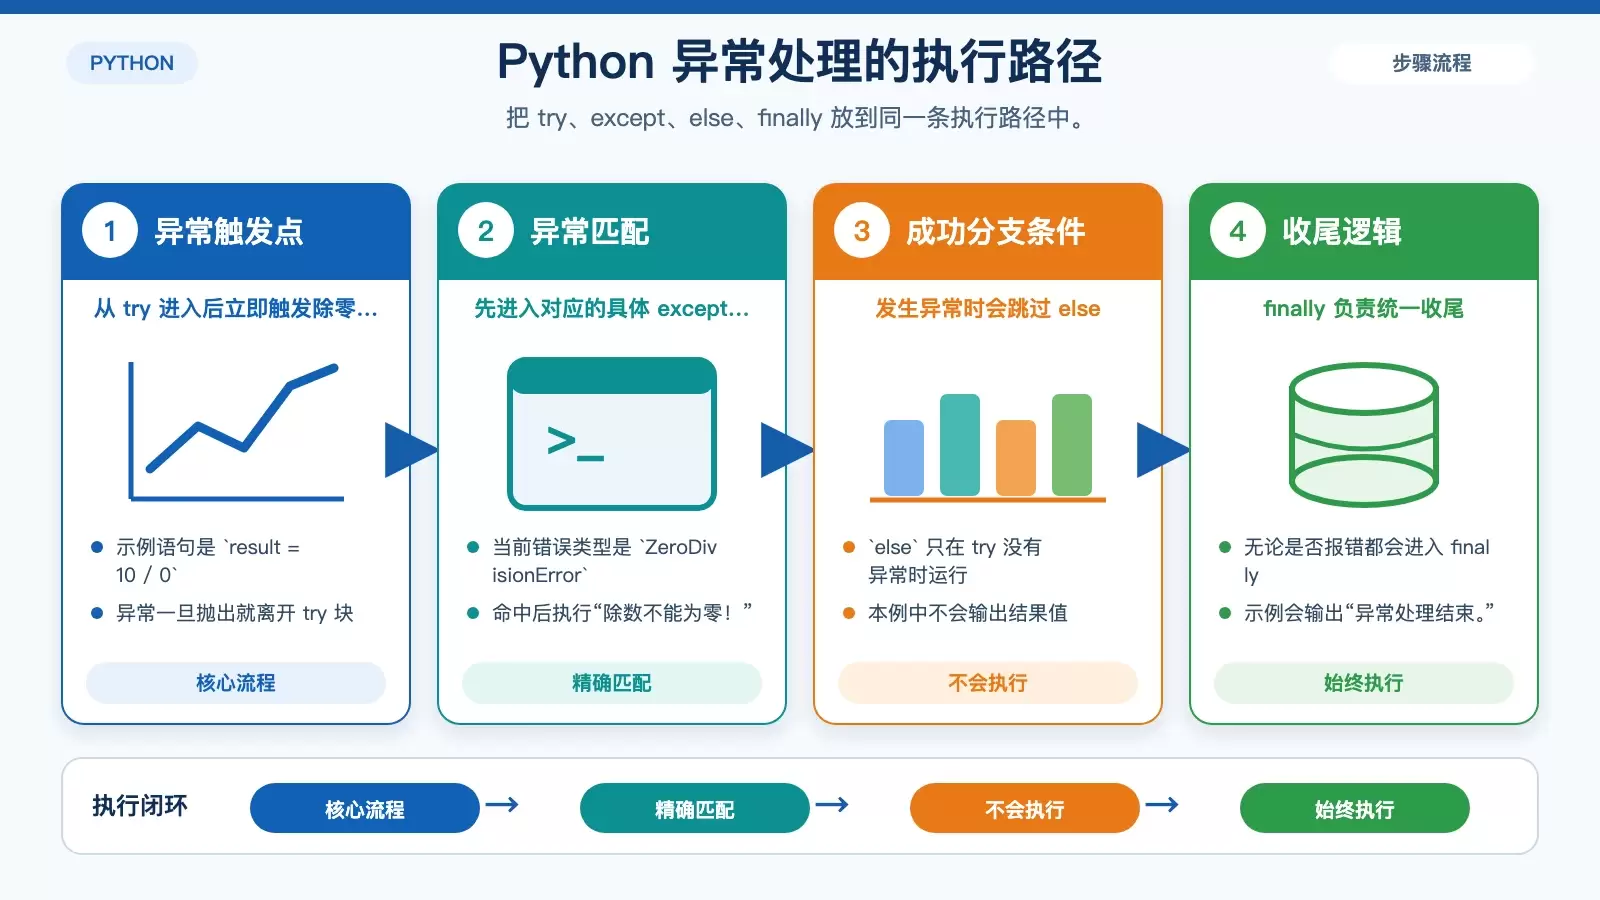
Python 异常处理的核心是用 `try` 捕获可能出错的代码,再用 `except`、`else`、`finally` 分别处理错误、成功分支和收尾动作。本文结合一个除零示例,拆开说明各个代码块的执行顺序和适用场景。 写 Python 脚本时,最怕的不是代码报错,而是程序一遇到异常就直接中断,既不知道问题在哪,也没有留下收尾动作。
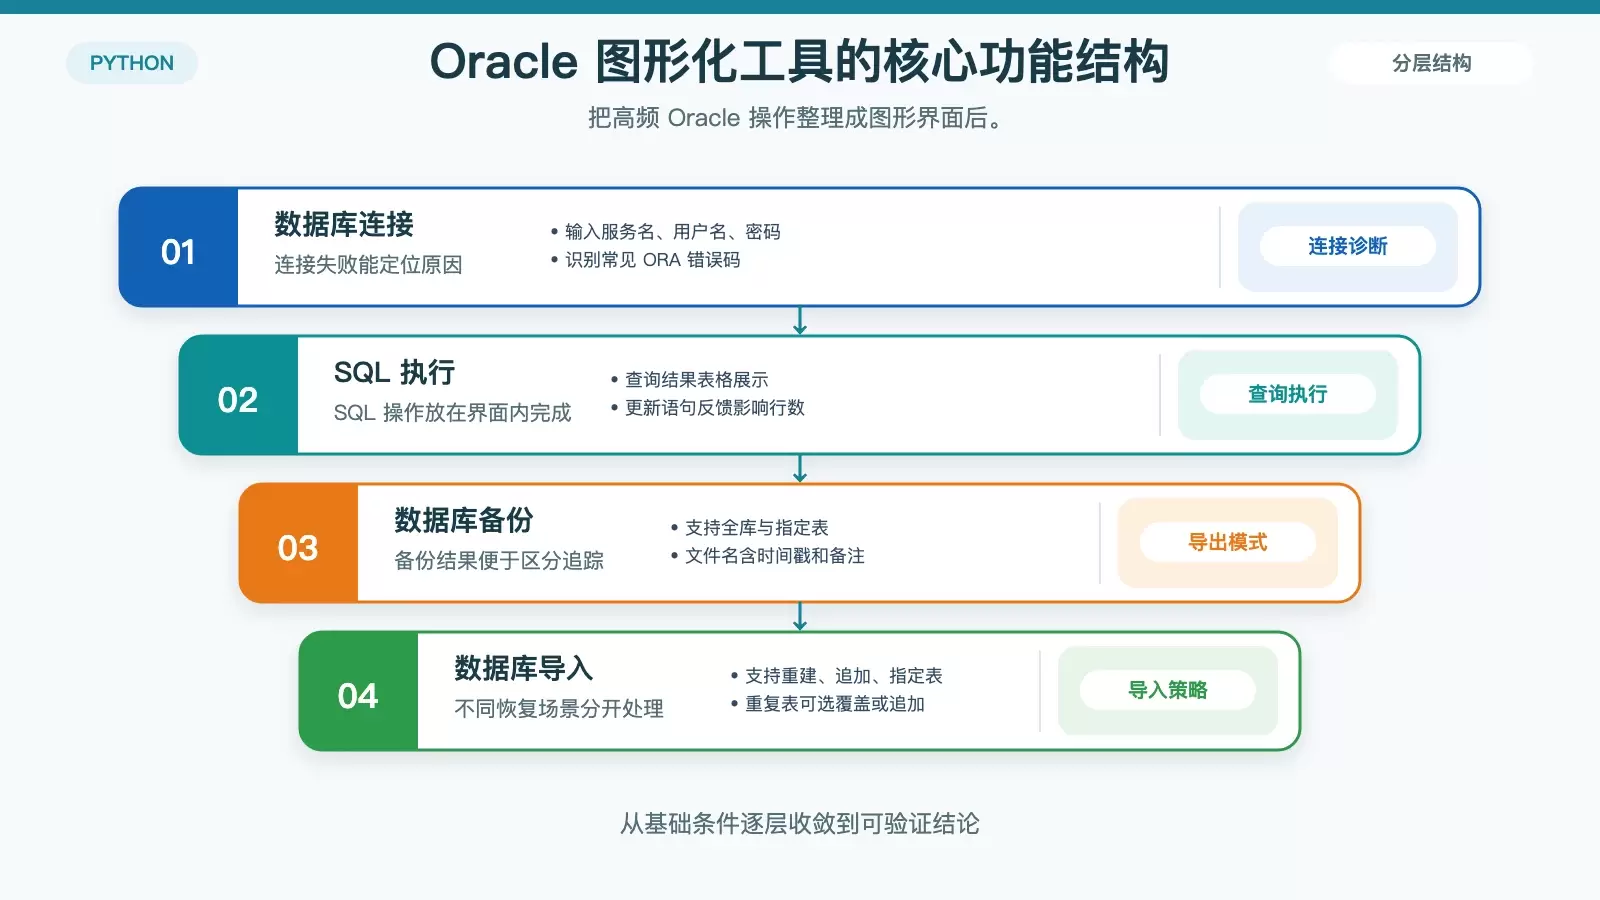
这款用 Python + Tkinter 编写的 Oracle 图形化工具,核心目标是把常见的备份、导入、SQL 执行和用户管理操作,从难记的命令行改成可视化流程。文章按实际使用场景梳理实现思路、关键代码和部署方式,便于判断它是否适合团队日常运维。
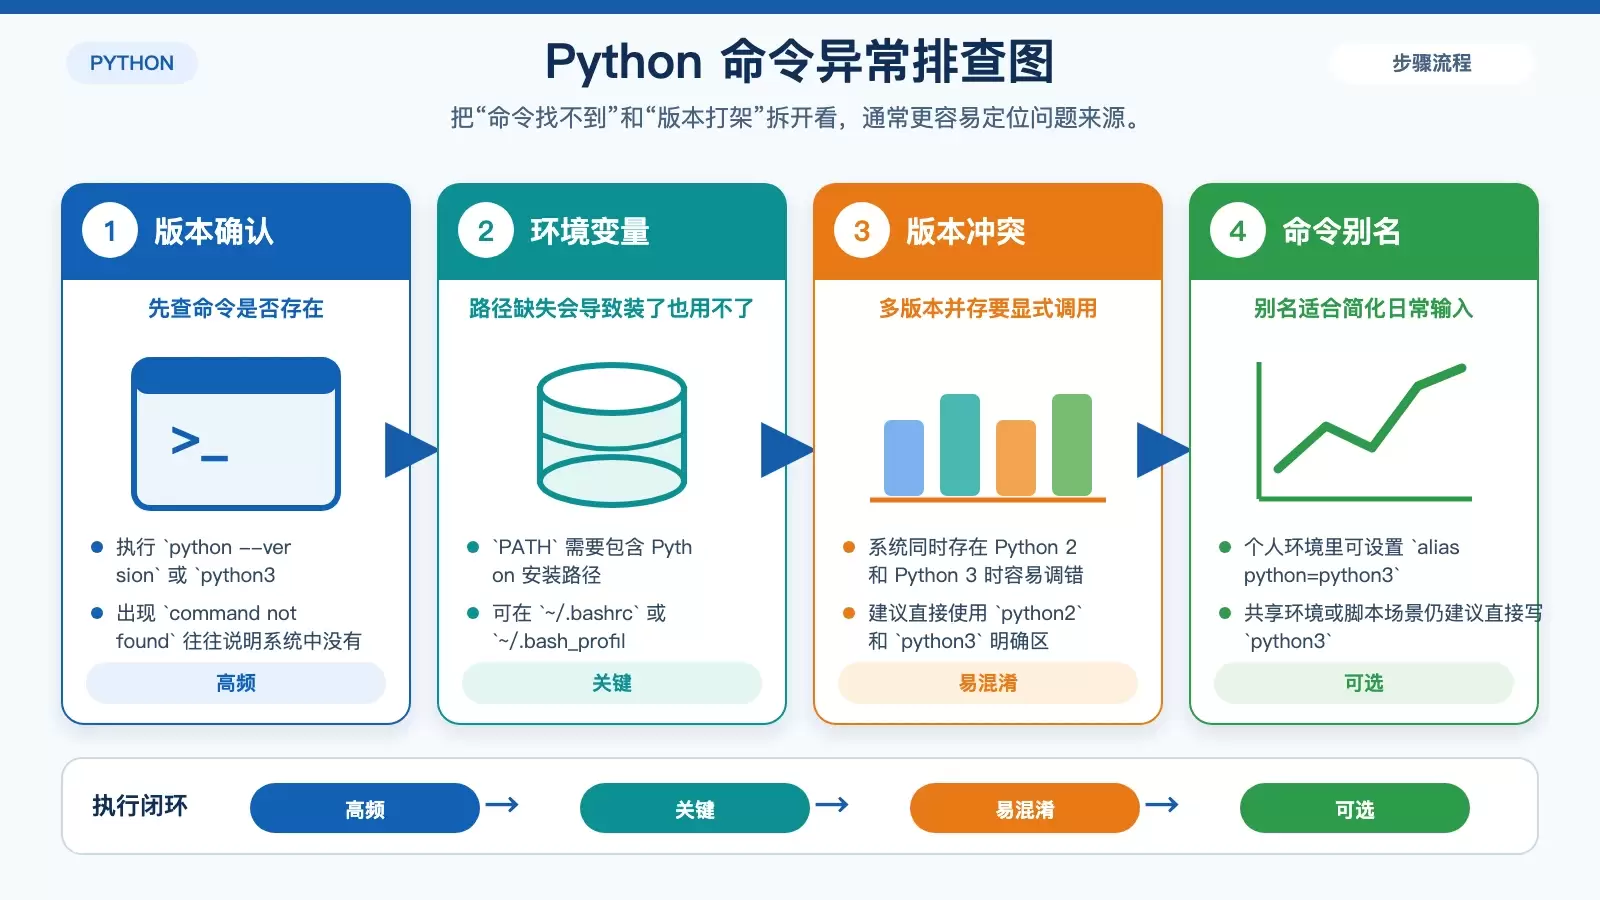
Linux 上配置 Python 时,最常见的问题通常集中在安装、PATH、权限、依赖、证书、编码、多版本冲突和虚拟环境几类。本文按排查顺序整理对应现象与处理方法,方便你快速判断故障点并选用更稳妥的修复方案。
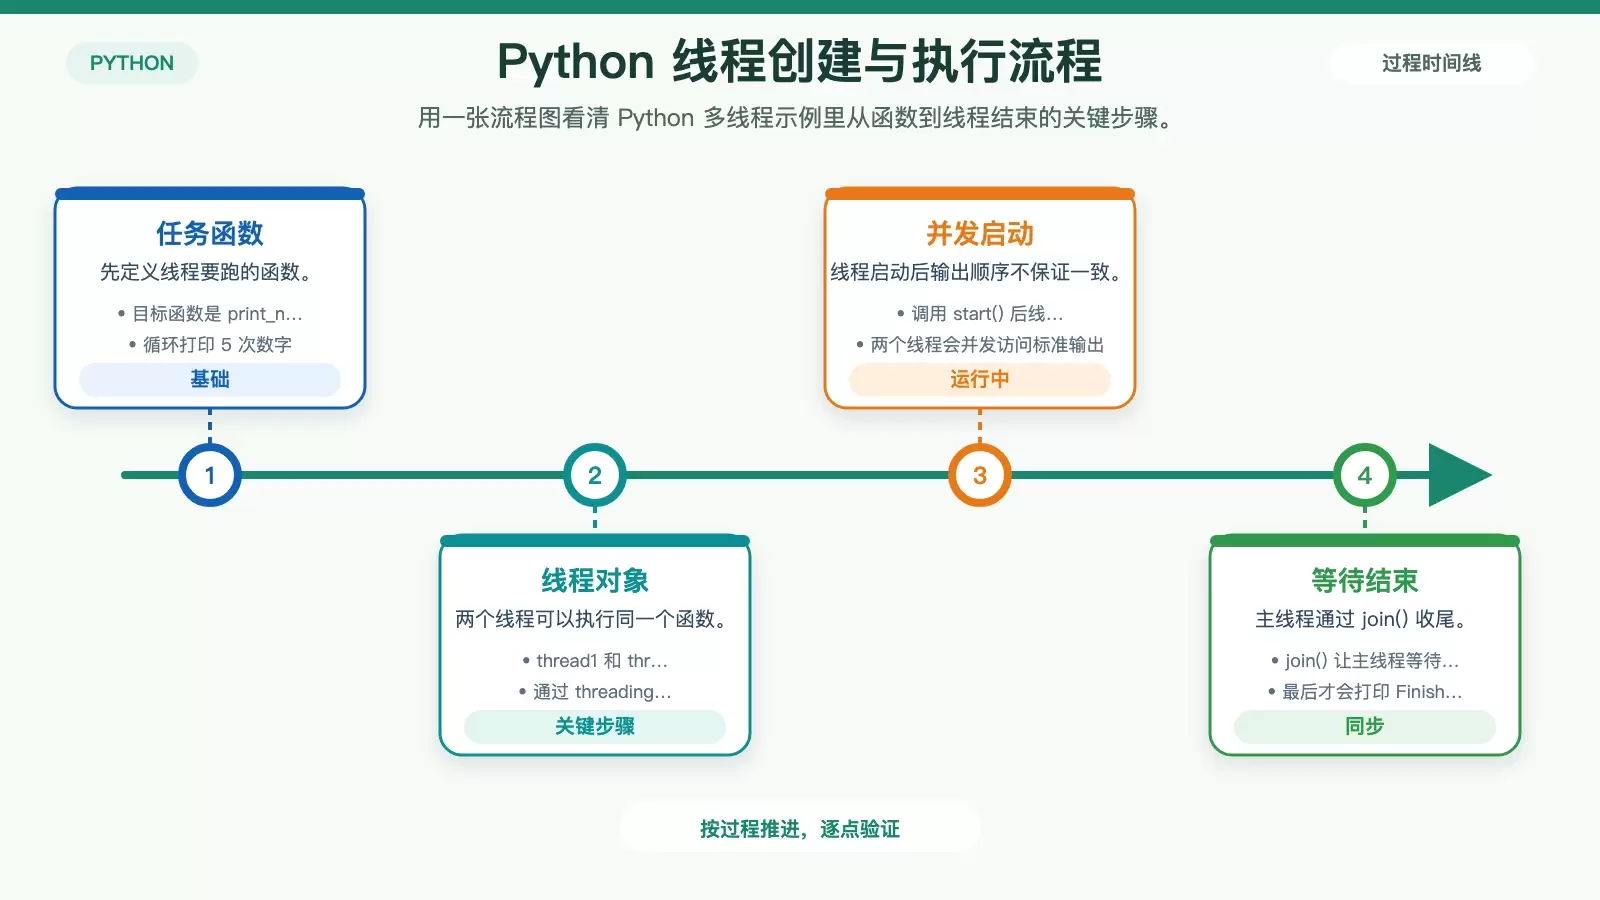
在 Ubuntu 上写 Python 多线程,最常用的是标准库 `threading`。本文从线程创建、`start()` 与 `join()` 的基本用法讲起,再解释共享数据为什么要配合 `Lock`,最后说明 GIL 对性能的实际影响,帮助你判断多线程适合 I/O 场景还是该改用 `multiprocessing`。
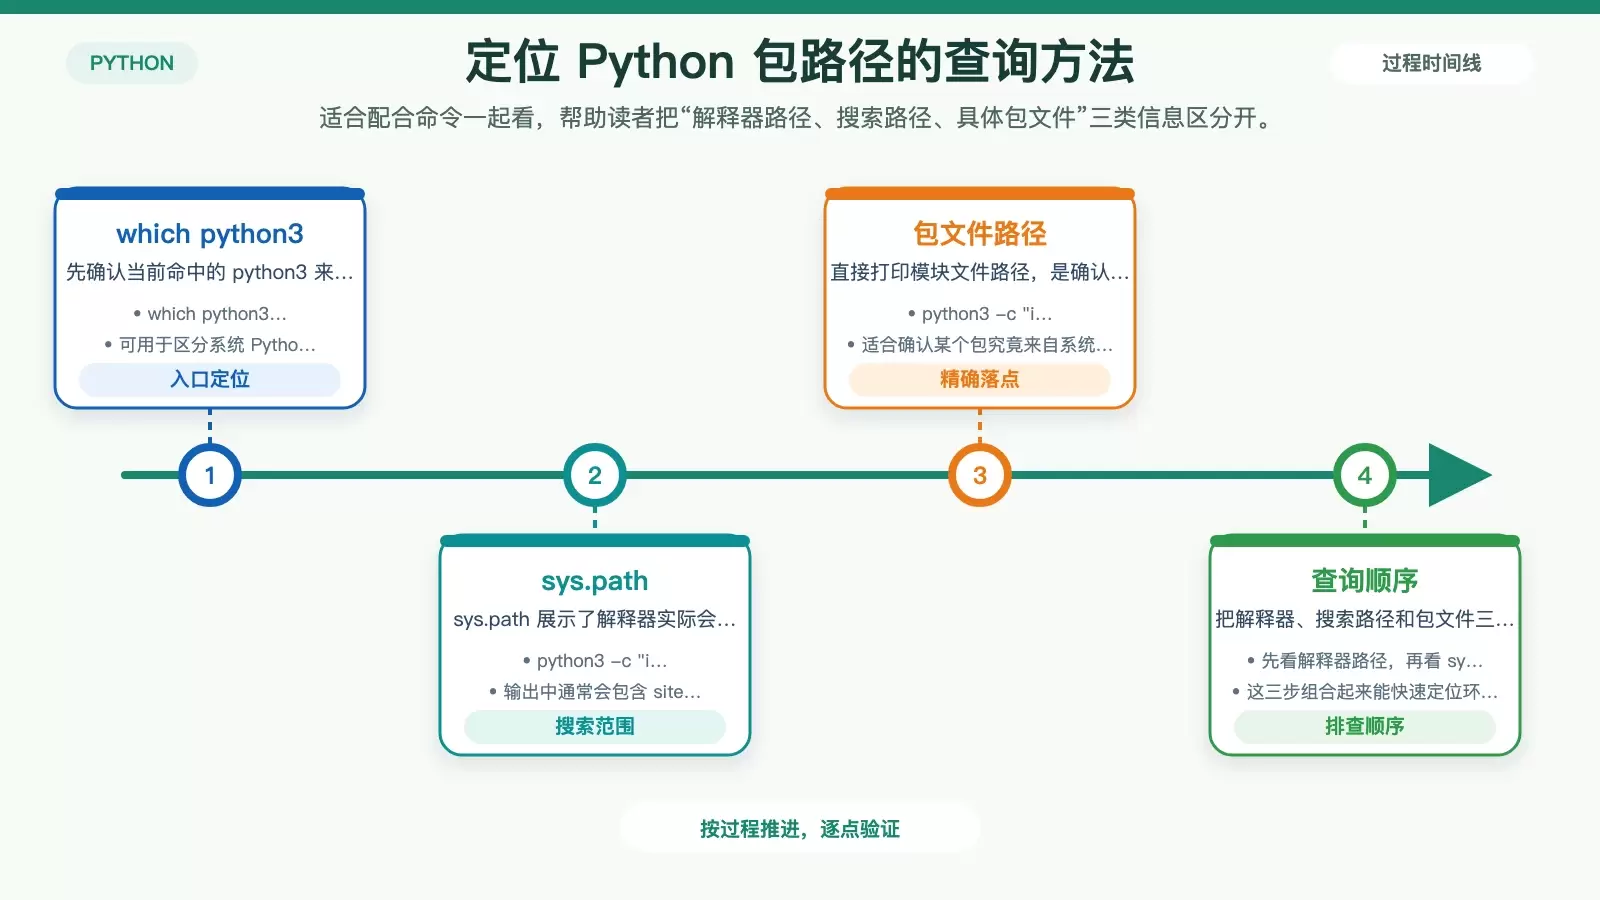
Ubuntu 里的 Python 包并不都在同一个目录。系统自带、APT、pip、源码编译和虚拟环境各有一套常见路径,判断错误时也最容易把问题归到“环境乱了”。这篇文章按安装方式拆开说明,并附上可直接执行的定位命令。