

NumPy ndarray 核心属性详解与实战调用
NumPy 作为 Python 数据分析的基石,其核心数据结构 ndarray 封装了大量元数据属性,便于快速掌握数组的维度、内存布局与类型特征。本文将系统演示 ndarray.ndim、shape、size、dtype、itemsize、flags 等核心属性的实际调用方式,结合完整代码与运行结果输出,帮助开发者在数据处理与模型调试中高效进行结构分析与内存评估。
2026-10-12
22

NumPy 作为 Python 数据分析的基石,其核心数据结构 ndarray 封装了大量元数据属性,便于快速掌握数组的维度、内存布局与类型特征。本文将系统演示 ndarray.ndim、shape、size、dtype、itemsize、flags 等核心属性的实际调用方式,结合完整代码与运行结果输出,帮助开发者在数据处理与模型调试中高效进行结构分析与内存评估。
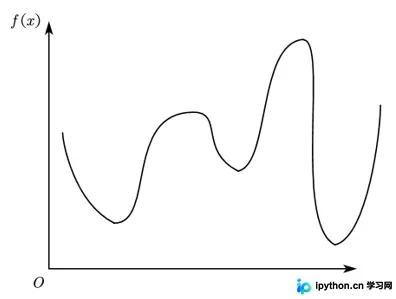
本文深入解析梯度下降算法原理,对比传统数值解法的局限性,如局部最优和收敛效率问题。通过泰勒展开推导学习率公式,并展示Python代码在Logistic回归中的应用,帮助读者掌握算法核心逻辑与工程实现细节。
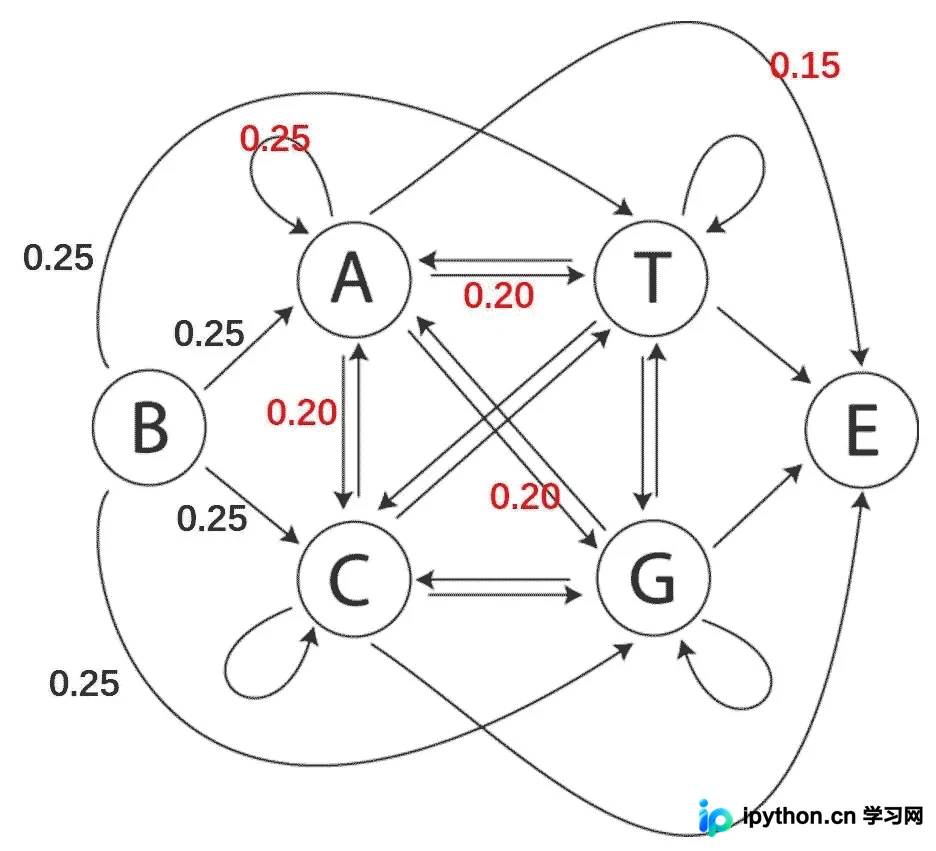
本文介绍如何在Python中利用一阶马尔科夫链生成随机DNA序列。通过设定碱基转移概率矩阵,结合numpy和random模块模拟序列演化过程,并统计长度分布。代码可直接运行于Jupyter Notebook,支持自定义序列数量和概率参数,适合生物信息学中的序列建模需求。
在读写文件前验证路径有效性是避免程序异常的关键。本文系统梳理Python中判断文件或文件夹是否存在的三种标准方案:基于os模块的路径与权限校验、利用try-except捕获异常直接尝试访问,以及现代标准的pathlib路径对象检测。结合完整代码示例说明适用场景与操作细节。
本文详细介绍在Mac系统中为Python2.7和Python3安装pip包管理工具的方法。针对Python2.7,可通过系统自带的easy_install手动安装;针对Python3,推荐使用get-pip.py脚本进行安装。文章还涵盖了版本查看、包列表查询及pip升级等常用操作,帮助开发者快速配置Python开发环境。

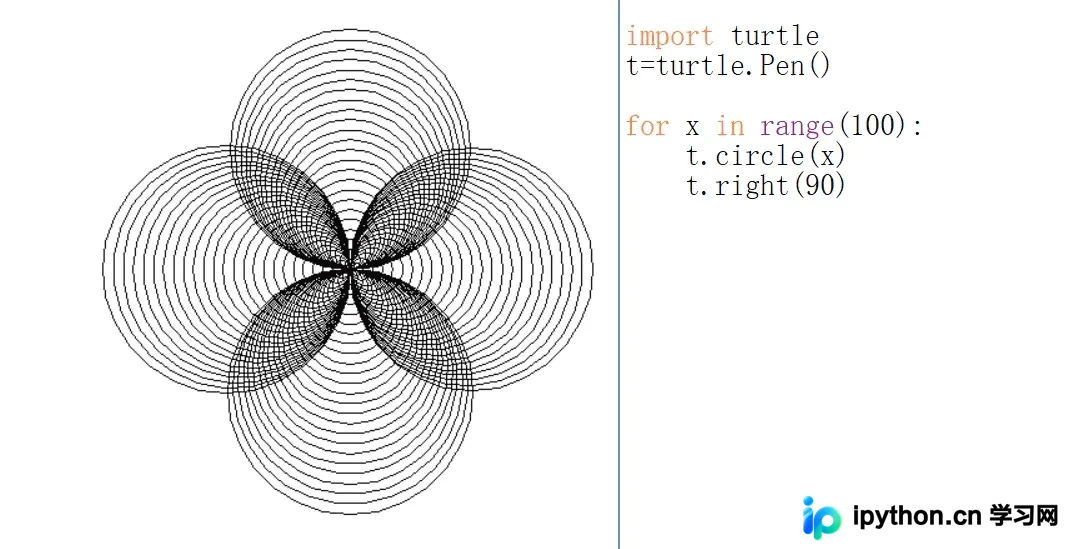
本文详解如何使用Python的turtle模块,结合for循环与列表(list)绘制彩色同心圆环。通过t.circle()控制半径递增,利用range生成序列,并借助取余运算在colors列表中循环切换颜色,实现红、黄、蓝、绿四色交替的视觉效果。文章涵盖import导入、画笔颜色设置及circle参数详解,适合Python初学者掌握图形绘制与基础数据结构应用。
本文深入解析Python threading模块中的线程通信机制。通过互斥锁(Lock)解决多线程共享全局变量时的数据竞争问题,对比两种加锁实现方式。同时介绍Queue队列的基本操作及task_done与join的配合使用,并结合协程(yield)与线程的区别,详细演示生产者/消费者模式的代码实现与执行逻辑。
本文深入解析Python中format方法的多种用法,涵盖按顺序匹配、索引引用、关键字参数及混合使用规则。详细讲解数值精度控制、进制转换、字符串对齐与填充,以及利用*和**对列表、字典进行拆包的高级技巧,助您掌握高效字符串处理方案。
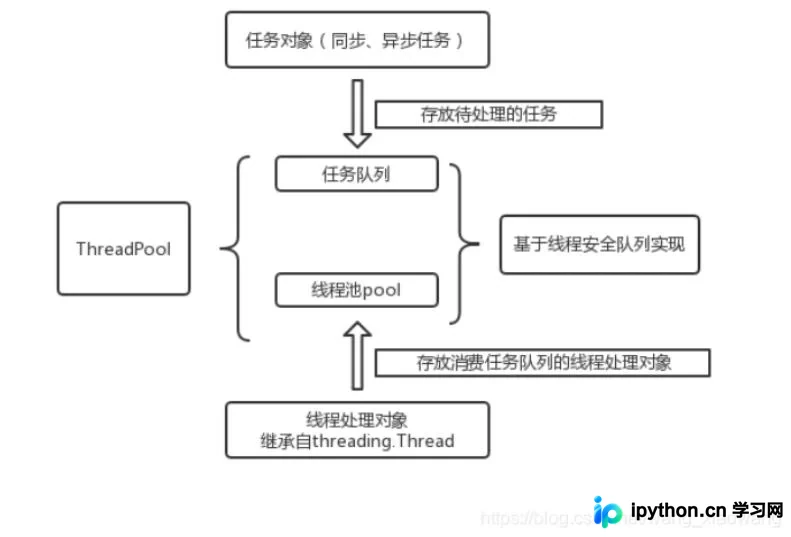
本文详细讲解了如何利用Python标准库中的 threading.Lock 与 threading.Condition 构建具备容量限制、读写锁定及超时阻塞能力的自定义线程安全队列。通过完整的生产者消费者测试代码,直观验证了互斥锁防冲突与条件变量唤醒机制的实际效果,为理解线程池底层数据交换提供了清晰参考。
本文详细介绍Python中h5py库的基础用法,涵盖HDF5文件的创建、数据集(dataset)与组(group)的管理。通过具体代码示例,演示如何创建文件句柄、定义数据类型与形状、直接赋值以及嵌套组的结构操作,帮助开发者快速掌握HDF5文件的基本读写流程。
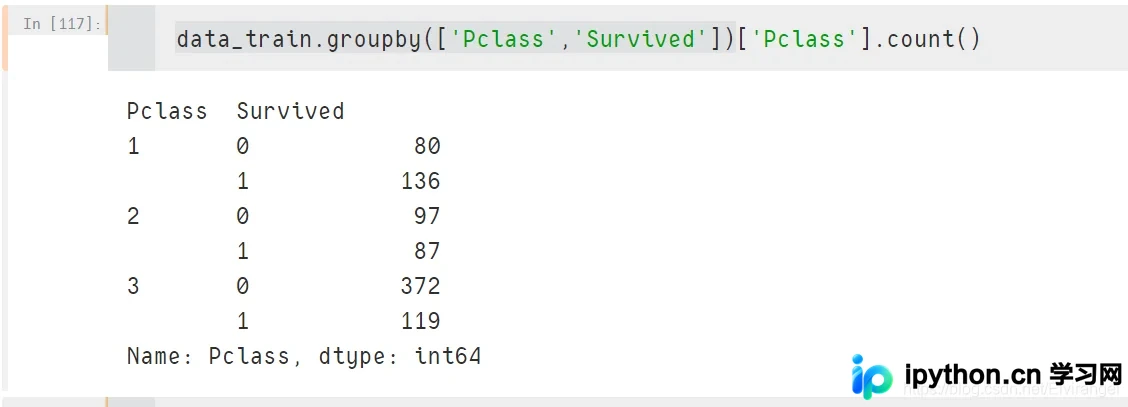
Pandas中count()与value_counts()常用于数据统计,但前者返回非空值总数,后者返回各唯一值的出现频次并默认降序排列。本文详解两者的参数配置、代码示例及核心区别,帮助开发者快速匹配数据清洗与分析场景。
在NumPy数据处理中,经常需要生成或提取矩阵对角线上的数值。许多开发者容易将生成函数与提取函数混淆。本文将直接演示 numpy.diag() 的双向用法:传入一维数组自动构建对角矩阵,传入二维矩阵精准提取指定偏移的对角线元素,附带核心参数解析与标准代码示例。