

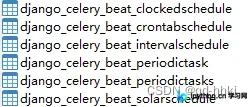
Django 集成 django-celery-beat 实现动态定时任务
本文详细介绍如何在 Django 项目中利用 django-celery-beat 库创建和管理动态定时任务。内容包括环境搭建、Celery 配置、调度器类型选择、任务定义及系统启动流程,并提供常见问题的排查方法,帮助用户快速实现可靠的后台任务自动化。
2026-10-12
22

本文详细介绍如何在 Django 项目中利用 django-celery-beat 库创建和管理动态定时任务。内容包括环境搭建、Celery 配置、调度器类型选择、任务定义及系统启动流程,并提供常见问题的排查方法,帮助用户快速实现可靠的后台任务自动化。
本文详解在Python中使用内置time模块将自定义格式时间字符串转换为时间戳的标准流程。通过time.strptime精准解析日期文本,结合time.mktime完成数值转换,附带完整函数代码、格式控制符对照及运行示例,直接解决多源数据对齐时的时序处理难题。
本文详解Python中使用readline()和readlines()函数按行读取文件的核心语法与参数控制。通过文本与二进制模式的对比代码,演示如何获取单行数据、处理末尾换行符及限制读取长度,并分析两者在返回值类型与内存占用上的差异,帮助开发者高效完成文件内容解析。
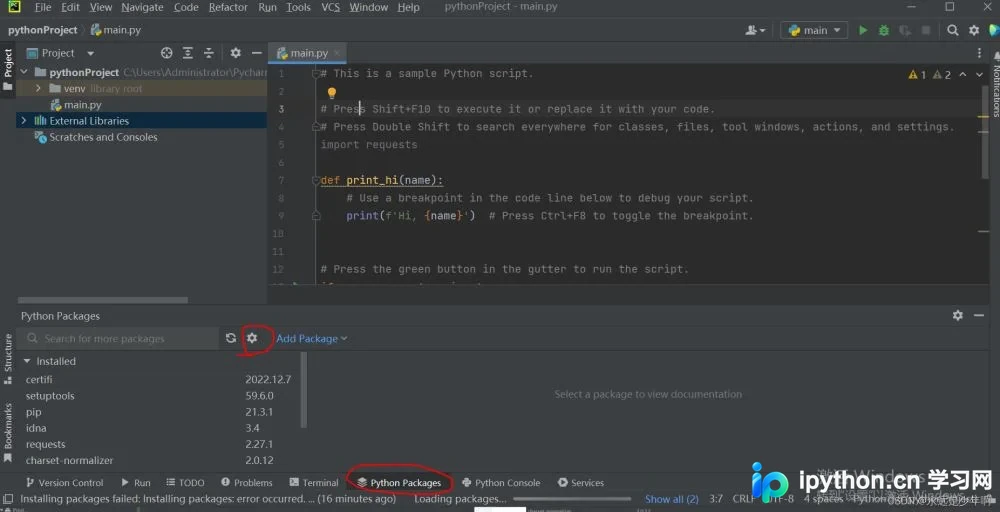
本文详细介绍在 PyCharm 中更换国内安装源以提升下载速度的方法,以及添加和管理第三方库的具体操作步骤。针对更换源后可能出现的验证失败错误,提供了通过命令行添加 trusted-host 参数的解决方案,确保库安装顺利完成。
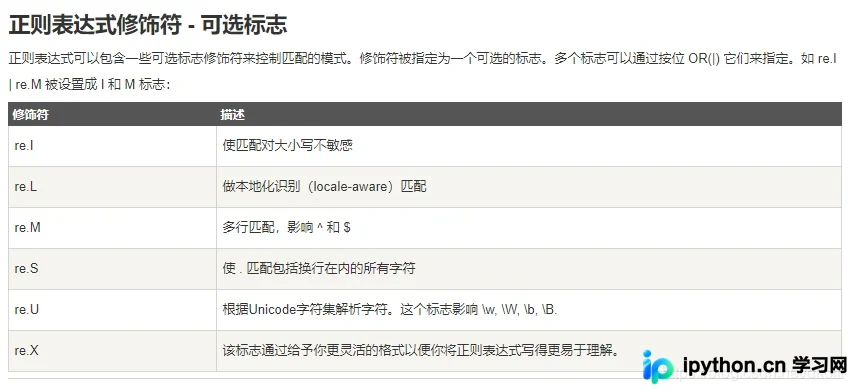
在Python文本处理中,手动逐个替换空格、制表符和换行符效率较低且易遗漏。本文对比了内置方法与正则表达式的实现差异,重点演示如何使用 re.sub 结合 \s 模式一次性清除字符串内所有类型的空白字符,并附带爬虫数据清洗的实际应用步骤与避坑指南。
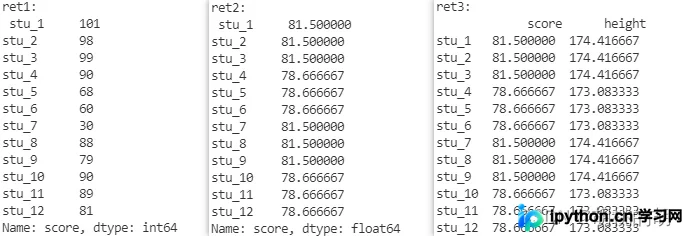
本文详细解析Pandas中transform与apply方法在分组聚合中的区别与应用。通过示例展示如何利用自定义函数处理Series和DataFrame,包括数值计算、字符串操作及多列聚合。重点阐述transform保持原索引长度与apply返回聚合结果的特性,帮助开发者根据需求选择合适方法,提升数据处理效率。
本文系统梳理Pandas在数据分析中的核心应用,涵盖数据导入导出、重复值与缺失值处理、字符串清洗、数据筛选与抽样、多表合并、时间序列解析及标准化等关键步骤。通过具体代码示例,帮助开发者快速掌握高效处理表格型数据的方法,提升数据预处理效率。
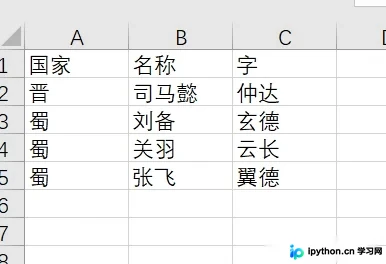
本文详解如何利用Python的Pandas库在Excel和CSV文件中实现类似VLOOKUP的数据关联功能。内容涵盖删除指定行、获取最大行数、上下拼接表格以及使用merge函数进行左连接合并。通过具体代码示例,展示如何高效处理三国人物数据,解决大数据量下的性能问题,并提供从数据清洗到最终合并的完整操作流程。
在Python中处理文本数据时,经常需要按特定规则拆分字符串。本文详细介绍split()与rsplit()函数的核心机制,重点解析sep分隔符与maxsplit切分次数的参数逻辑,通过对比示例展示从左向右与从右向左分割的差异,帮助开发者高效掌握字符串分割技巧。
本文深入解析Python中OpenCV库的Sobel与Laplacian算子,详细讲解图像锐化与边缘检测原理。通过Sobel()和Laplacian()函数原型说明、参数解析及完整代码示例,展示如何结合高斯滤波与阈值处理进行边缘提取,并对比Roberts、Prewitt等算法效果,为图像识别提供基础技术支持。
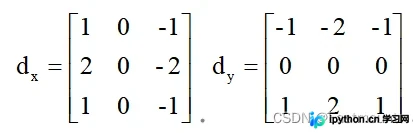
本文详细介绍Python中random.shuffle()函数的用法,重点说明其原地打乱列表顺序且不生成新列表的特性。通过代码示例展示具体操作,并深入解析源码实现逻辑,包括随机数生成器的可选参数及Fisher-Yates洗牌算法的核心步骤,帮助开发者正确使用该函数。
在使用Python处理网络请求时,直接缓存全量响应会迅速耗尽系统内存。本文针对该痛点,利用requests的流式传输机制与分块读取技术,详细演示如何通过拦截服务端返回的Content-Length头信息,实时计算已下载占比。结合终端控制符循环刷新界面,最终输出平滑的动态进度条与实际运行耗时,兼顾稳定性与可视化效果。