

Python random.shuffle() 原地打乱列表详解与源码解析
本文详细介绍Python中random.shuffle()函数的用法,重点说明其原地打乱列表顺序且不生成新列表的特性。通过代码示例展示具体操作,并深入解析源码实现逻辑,包括随机数生成器的可选参数及Fisher-Yates洗牌算法的核心步骤,帮助开发者正确使用该函数。
2026-10-12
22

本文详细介绍Python中random.shuffle()函数的用法,重点说明其原地打乱列表顺序且不生成新列表的特性。通过代码示例展示具体操作,并深入解析源码实现逻辑,包括随机数生成器的可选参数及Fisher-Yates洗牌算法的核心步骤,帮助开发者正确使用该函数。
在使用Python处理网络请求时,直接缓存全量响应会迅速耗尽系统内存。本文针对该痛点,利用requests的流式传输机制与分块读取技术,详细演示如何通过拦截服务端返回的Content-Length头信息,实时计算已下载占比。结合终端控制符循环刷新界面,最终输出平滑的动态进度条与实际运行耗时,兼顾稳定性与可视化效果。
本文详解Python字符编码底层原理与实操方法。涵盖ASCII、UTF-8等主流格式特性,说明源文件编码声明机制,演示跨编码安全读取转换流程,并解决图形界面渲染乱码问题,助力开发者高效处理多语言文本数据。
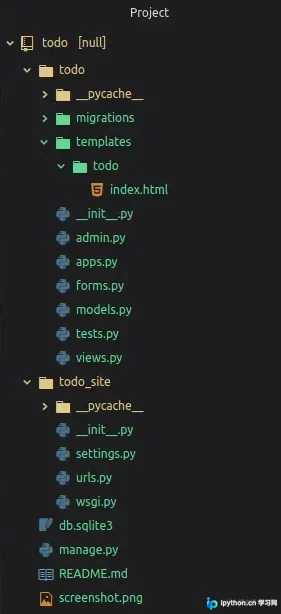
本教程详细介绍如何使用Python Django框架快速构建一个待办事项Web应用。内容涵盖Django环境配置、项目与应用的创建、数据库模型定义、视图逻辑处理、表单生成及管理员后台注册。通过具体代码示例,指导开发者完成从项目初始化到功能实现的完整流程,适合希望掌握Django基础开发的初学者参考。
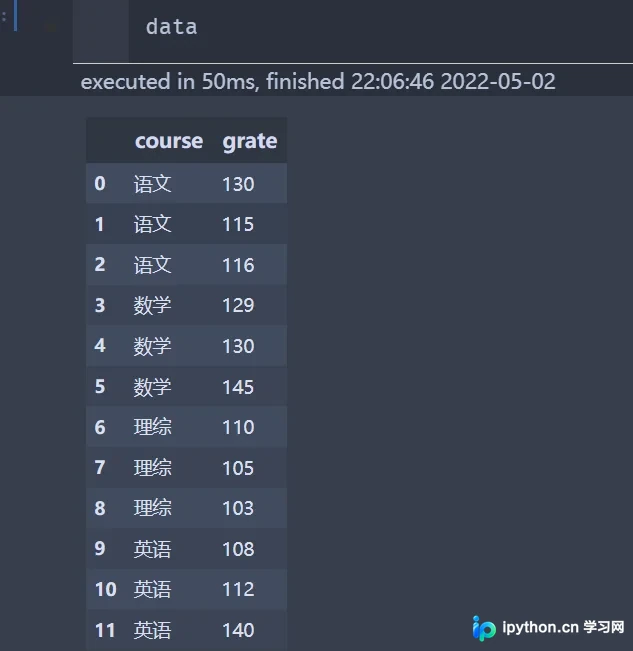
本文详解Python中pandas库的pivot_table函数,通过index、values、columns及aggfunc四大核心参数,演示如何对Excel数据进行动态分组、汇总与计算。涵盖均值、求和等多种统计方式,帮助开发者高效完成数据清洗与分析任务。
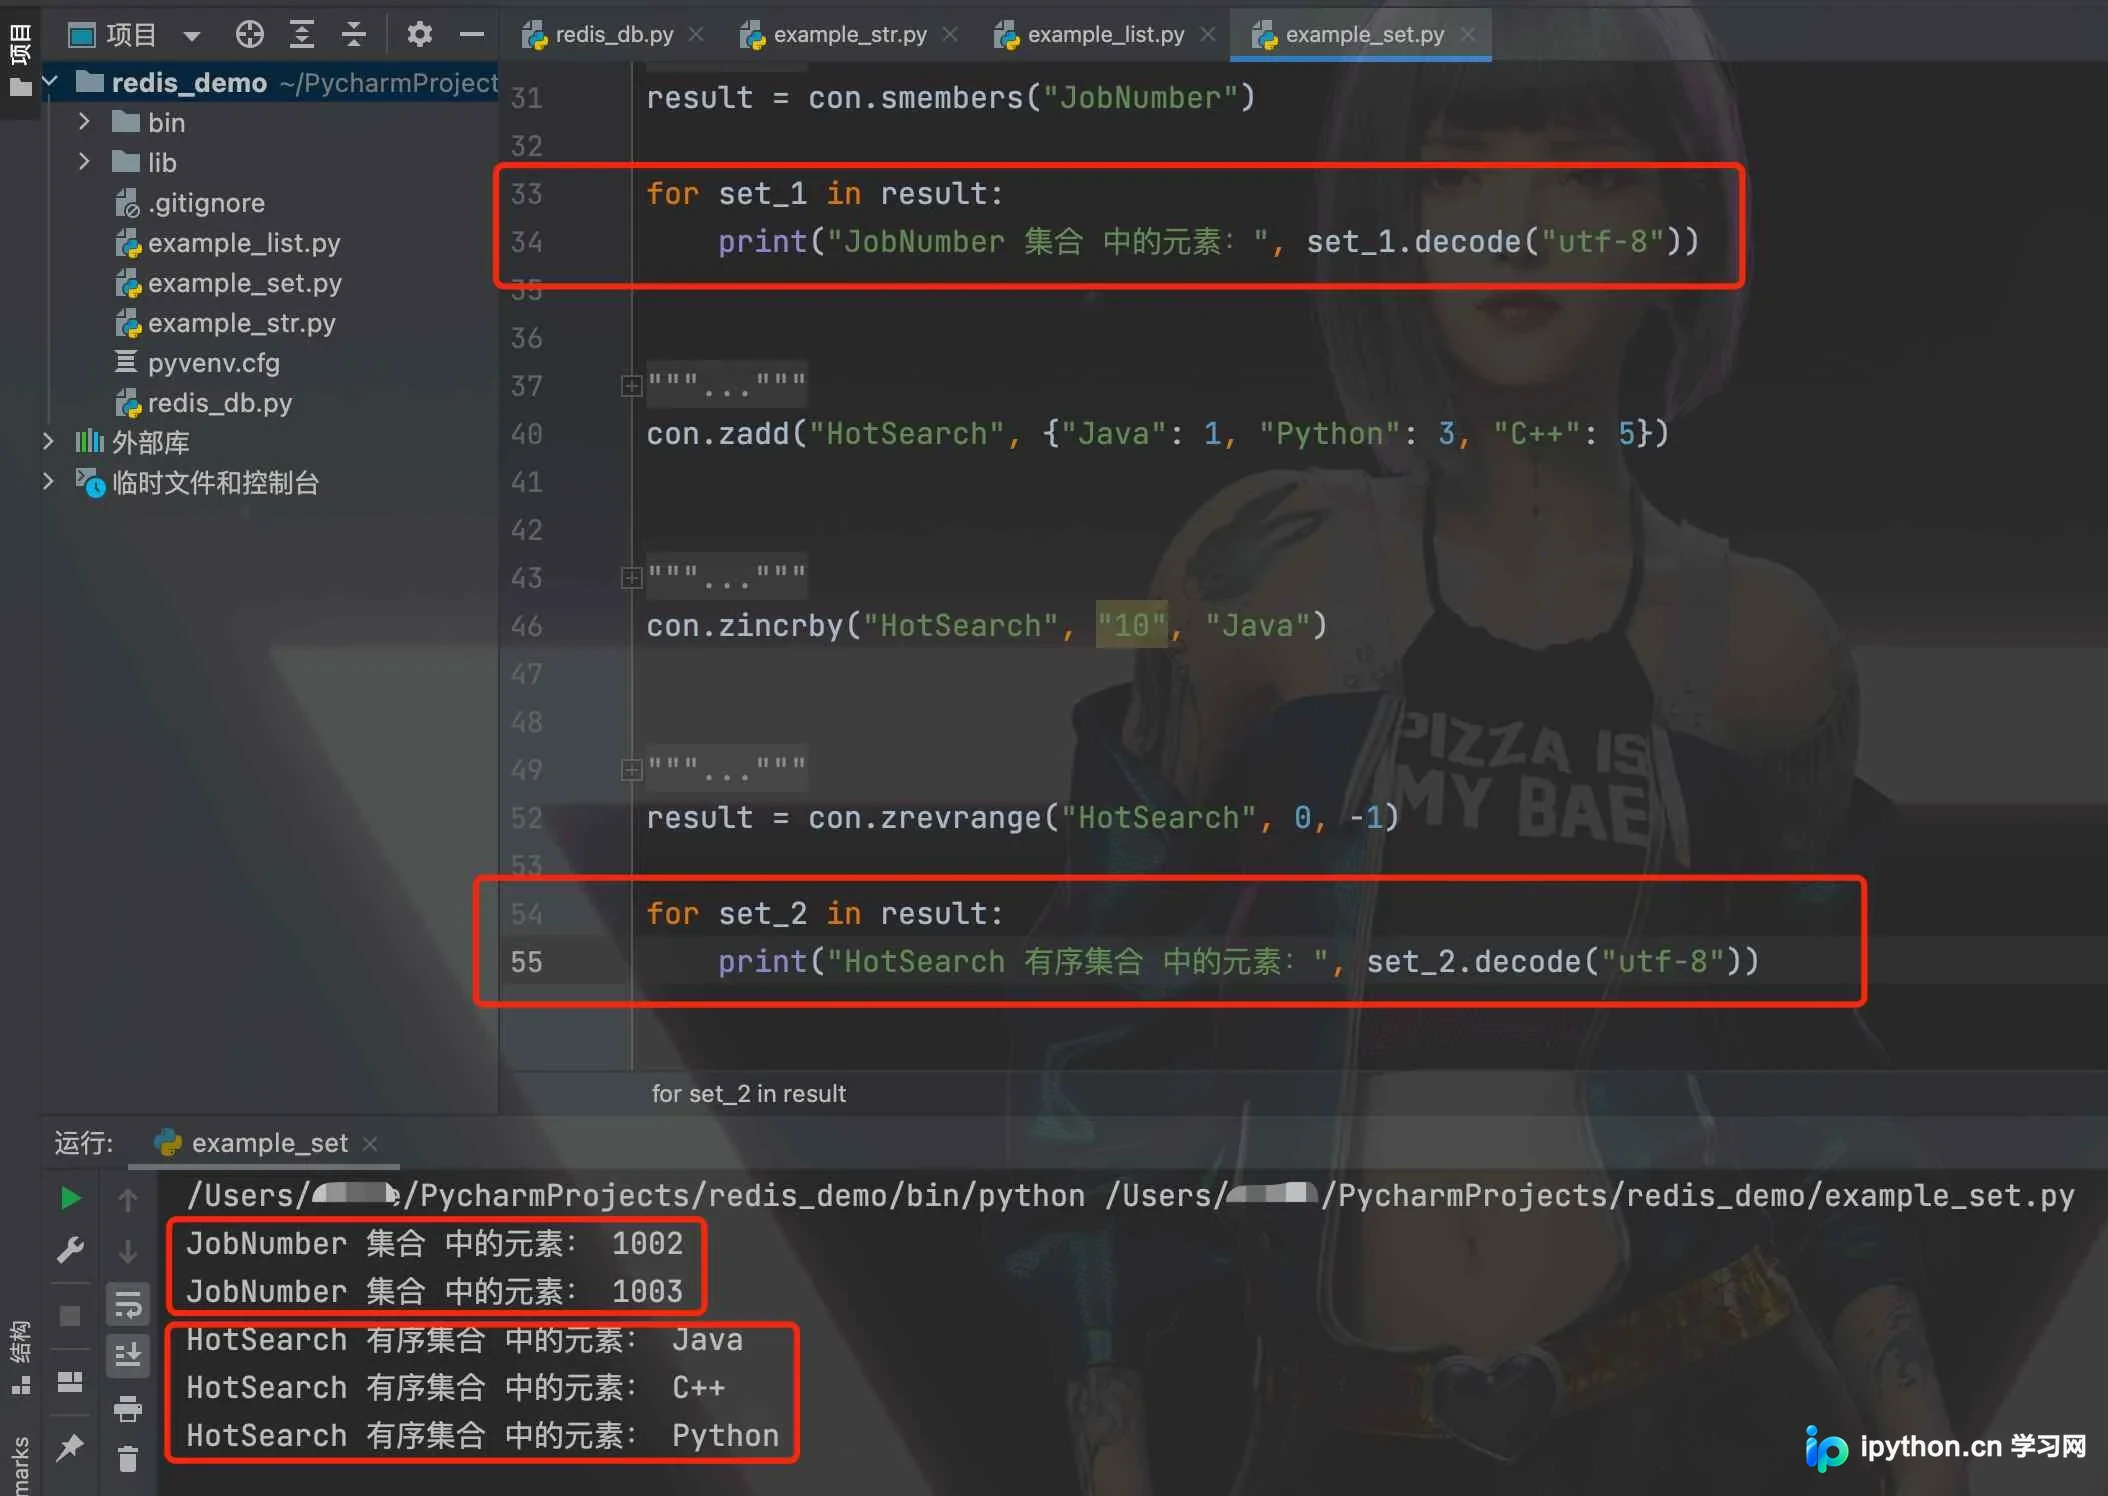
基于 redis-py 客户端对 Redis 集合(Set)与有序集合(ZSet)进行创建、增删、排序与读取的实操指南。通过 sadd、srem、smembers 及 zadd、zincrby、zrevrange 等核心指令,结合完整 Python 示例代码,快速掌握内存数据结构的高效操作方法。
fileinput 模块专为迭代处理一个或多个文本文件设计,采用逐行生成的惰性读取方式,在批量处理大文件时可显著降低内存占用。相比传统的 open() 结合循环,它原生支持原地修改、自动备份、跨文件序号追踪及自定义读取钩子。通过合理配置参数与方法,可快速实现日志清洗、代码批量检索与格式标准化等任务。
面对频繁的列表处理与轻量级计算需求,手动编写循环与独立函数易导致代码冗余。本文逐一讲解Python3中六个核心内置函数的标准用法:lambda匿名运算、map批量映射、filter条件筛选、reduce序列累积、enumerate索引遍历与zip多维合并,附带可直接运行的代码片段与预期输出,帮助开发者快速掌握数据转换与清洗的最佳实践。
本文介绍如何利用Python pandas库的groupby函数,结合apply和lambda表达式,从分组数据中筛选出每组最大值与最小值所在的行。通过具体代码示例,演示如何处理多级索引并导出结果至Excel,解决直接使用groupby无法直接获取极值行的问题。
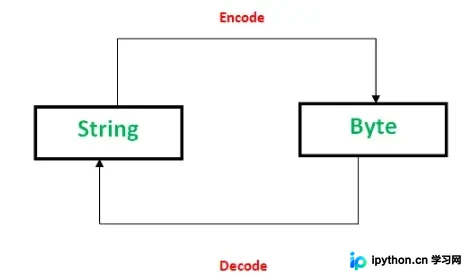
本文详解 Python 中字节对象与字符串的区别,重点讲解 encode() 和 decode() 方法的使用。通过 ASCII 编码示例,展示字符串如何转换为字节序列以及逆向解码过程,帮助开发者掌握数据存储与处理的底层机制。
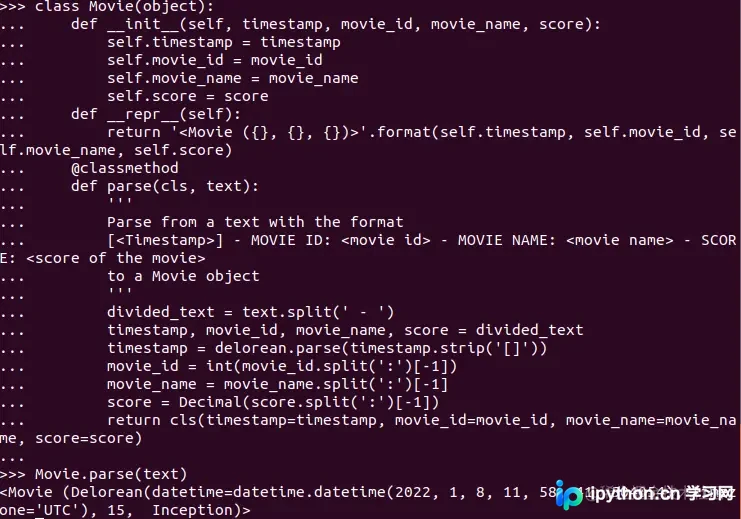
本文演示如何使用 Python 将固定格式的结构化文本逐段拆分,并将其中的时间戳、ID 及评分等字段自动转换为对应的数据类型。通过封装自定义类与 parse 方法,实现一键解析与对象化存储,为后续的数据分析与批量处理提供标准化输入。
本文介绍使用 Python socket 模块构建轻量级 Syslog 服务器的完整过程。通过 UDP 协议接收交换机及 Linux 系统的 syslog 日志,按 IP 和时间分文件存储。文章详细解析了处理接收数据中 \x00 空字符的问题,并提供了交换机和 Linux rsyslog 的配置示例,为后续 Web 展示与异常告警奠定基础。
