

详解8个Python自动化脚本,告别重复劳动

本文详细讲解8个基于Python的日常自动化脚本,涵盖网络请求容错、按内容重命名、清理历史文件、监控僵尸进程、修改前自动备份、长耗时任务桌面通知、轻量级网页采集与按后缀归档。通过标准化代码结构与参数说明,帮助开发者将繁琐的重复劳动交由脚本稳定执行。
环境准备与依赖安装
编写并运行上述脚本前,需确保目标机器已安装对应版本的Python解释器,并根据脚本需求安装第三方库(如 requests、beautifulsoup4、psutil)。推荐使用统一的环境管理工具来隔离依赖,避免手动配置环境变量或污染系统默认运行时。
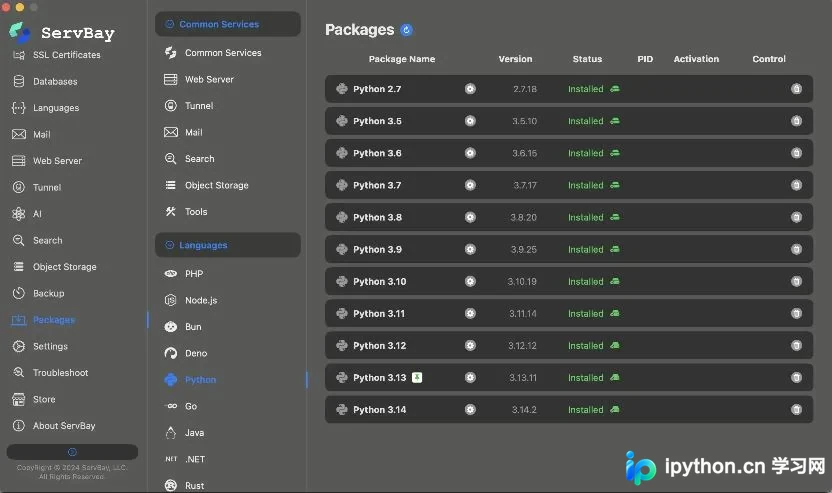
各脚本均遵循标准库优先原则,仅对明确需要网络交互或进程查杀的场景引入外部包。以下为具体工作流实现。
核心场景与脚本实现
第1步:封装网络请求自动重试逻辑
目的:应对爬虫或API调用时的网络抖动,防止单次超时引发全局崩溃。
入口:脚本顶部定义请求函数
动作:循环发起GET请求,捕获异常后按指定间隔重试,达到阈值则抛出最终错误。
import time
import requests
from requests.exceptions import RequestException

def fetch_with_retry(url, max_retries=3, pause=2):
    """带有自动重试机制的GET请求"""
    for attempt in range(max_retries):
        try:
            response = requests.get(url, timeout=10)
            response.raise_for_status()
            return response
        except RequestException as e:
            print(f"请求失败 (尝试 {attempt + 1}/{max_retries}): {e}")
            if attempt == max_retries - 1:
                raise
            time.sleep(pause)

# 使用示例
try:
    data = fetch_with_retry("https://api.github.com")
    print(f"请求成功,状态码: {data.status_code}")
except RequestException:
    print("重试多次后依然失败,请检查网络或目标服务。")
该模式通过 timeout 限制挂起时间,利用 raise_for_status() 过滤非 2xx 响应,将不稳定因素收敛在代码层,适合夜间批处理或无人值守调度。
第2步:依据文件首行内容重命名
目的:解决批量导入文件或日志文件名无意义的问题,提升检索效率。
入口:指定目标扫描目录 TARGET_DIR
动作:逐行读取文件首段内容,清洗非法字符后拼接为新文件名并完成原地更名。
import os

TARGET_DIR = "./reports"

def clean_filename(text):
    return "".join(c if c.isalnum() else "_" for c in text)[:50]

for filename in os.listdir(TARGET_DIR):
    full_path = os.path.join(TARGET_DIR, filename)
    if os.path.isfile(full_path):
        try:
            with open(full_path, "r", encoding='utf-8') as f:
                first_line = f.readline().strip()
            if first_line:
                new_name = clean_filename(first_line) + ".txt"
                new_path = os.path.join(TARGET_DIR, new_name)
                if not os.path.exists(new_path):
                    os.rename(full_path, new_path)
                    print(f"重命名: {filename} -> {new_name}")
        except Exception as e:
            print(f"无法处理文件 {filename}: {e}")
通过 os.path.exists 预判碰撞风险,直接以文件核心元数据驱动命名,避免人工逐个核对。
第3步:清理长期未访问的过期文件
风险提示:此操作会永久删除符合时效条件的文件,执行前请务必备份重要数据或更换 WATCH_DIR 进行沙盒测试。
入口:设置待清理根路径与最大闲置天数 EXPIRY_DAYS
动作:遍历目录比对文件的最后访问时间 atime,超出阈值则调用删除命令。
import os
import time

WATCH_DIR = "/path/to/cleanup"
EXPIRY_DAYS = 180
current_time = time.time()

for filename in os.listdir(WATCH_DIR):
    filepath = os.path.join(WATCH_DIR, filename)
    if os.path.isfile(filepath):
        last_access_time = os.path.getatime(filepath)
        if current_time - last_access_time > (EXPIRY_DAYS * 86400):
            try:
                os.remove(filepath)
                print(f"已删除陈旧文件: {filename}")
            except OSError as e:
                print(f"删除失败: {e}")
基于最后访问时间而非创建时间判定,能更精准定位真正被遗弃的临时缓存,有效抑制磁盘隐性膨胀。
第4步:监控并终止高负载僵尸进程
风险提示:强制杀死进程可能导致正在写入的数据丢失,建议在测试环境中确认 PID 归属后再投入生产。
入口:设定 CPU 占用阈值 CPU_THRESHOLD 与目标进程名 PROCESS_NAME
动作:轮询系统进程列表,匹配名称且瞬时负载超标时触发 kill 指令。
import psutil

CPU_THRESHOLD = 80.0
PROCESS_NAME = "python"

for proc in psutil.process_iter(['pid', 'name', 'cpu_percent']):
    try:
        name = proc.info['name']
        if name and PROCESS_NAME in name.lower():
            cpu = proc.info['cpu_percent'] or 0.0
            if cpu > CPU_THRESHOLD:
                print(f"检测到高负载僵尸进程 PID: {proc.info['pid']} (CPU: {cpu}%)")
                proc.kill()
                print("已终止进程。")
    except (psutil.NoSuchProcess, psutil.AccessDenied):
        pass
该逻辑可直接嵌入守护脚本或 Cron 任务中,作为主动防御手段切断因死循环或内存泄漏导致的资源黑洞。
第5步:关键操作前的自动备份
目的:在执行覆盖、清空或结构变更前预留回滚点。
入口:传入目标配置文件路径 filepath
动作:检测文件存在性后生成带 YYYYMMDD_HHMMSS 时间戳的副本,拷贝失败则中断后续写操作。
import shutil
import time
import os

def safe_backup(filepath):
    if not os.path.exists(filepath):
        print(f"文件不存在: {filepath}")
        return
    timestamp = time.strftime("%Y%m%d_%H%M%S")
    backup_path = f"{filepath}.{timestamp}.bak"
    try:
        shutil.copy2(filepath, backup_path)
        print(f"备份已创建: {backup_path}")
    except IOError as e:
        print(f"备份失败: {e}")
        raise

config_file = "app_config.yaml"
safe_backup(config_file)
# 此处安全执行修改或覆写逻辑...
采用 copy2 可保留原始文件的权限与元数据,配合显式抛错机制,确保破坏性指令仅在留底成功后下达。
第6步:长耗时任务的系统通知
目的:免盯守运行结束后主动推送结果状态,释放开发者等待时间。
入口:调用 send_notification(title, text)
动作:识别操作系统类型,分别路由至 osascript(macOS)或 notify-send(Linux),兼容环境仅输出控制台日志。
import platform
import os

def send_notification(title, text):
    system_type = platform.system()
    if system_type == "Darwin":
        cmd = f"""osascript -e 'display notification "{text}" with title "{title}"'"""
        os.system(cmd)
    elif system_type == "Linux":
        cmd = f"""notify-send "{title}" "{text}" """
        os.system(cmd)
    else:
        print(f"通知: [{title}] {text}")

import time
time.sleep(2)
send_notification("任务完成", "数据处理脚本已执行完毕。")
该模块可与异步队列或定时调度器结合,实现真正的后台无人值守闭环。
第7步:轻量级网页数据采集
目的:将碎片化网页信息转化为结构化表格,替代高频复制粘贴。
入口:输入目标页面 URL 与输出 CSV 路径 output_file
动作:伪装基础请求头,解析 DOM 节点提取字段,写入标准 CSV 格式。
import requests
from bs4 import BeautifulSoup
import csv

def scrape_data(url, output_file):
    headers = {'User-Agent': 'Mozilla/5.0'}
    try:
        response = requests.get(url, headers=headers)
        soup = BeautifulSoup(response.content, 'html.parser')
        articles = soup.find_all('article')
        data_rows = []
        for article in articles:
            title_tag = article.find('h2')
            if title_tag and title_tag.a:
                title = title_tag.a.text.strip()
                link = title_tag.a['href']
                data_rows.append([title, link])
        with open(output_file, 'w', newline='', encoding='utf-8') as f:
            writer = csv.writer(f)
            writer.writerow(['标题', '链接'])
            writer.writerows(data_rows)
        print(f"成功抓取 {len(data_rows)} 条数据并保存至 {output_file}")
    except Exception as e:
        print(f"抓取过程中出错: {e}")

# scrape_data("http://example-blog.com", "results.csv")
利用正则外置的标签树解析器降低反爬误伤概率,输出结果可直接对接 Excel 或数据库导入流程。
第8步:按扩展名自动分类归档
风险提示:移动操作会导致源目录文件消失,若目标文件夹同名冲突将抛出异常,请先在非关键目录演练。
入口:配置源目录 SOURCE_DIR 与目标基址 DEST_DIR
动作:遍历源文件,按小写后缀创建分类子文件夹并执行跨路径迁移。
import os
import shutil
from pathlib import Path

SOURCE_DIR = Path("/Users/username/Downloads/MixedData")
DEST_DIR = Path("/Users/username/Documents/Sorted")

def organize_files():
    if not SOURCE_DIR.exists():
        return
    for file_path in SOURCE_DIR.iterdir():
        if file_path.is_file():
            ext = file_path.suffix.lower()
            if ext:
                folder_name = ext[1:].upper() + "_Files"
                target_folder = DEST_DIR / folder_name
                target_folder.mkdir(parents=True, exist_ok=True)
                try:
                    shutil.move(str(file_path), str(target_folder / file_path.name))
                    print(f"移动: {file_path.name} -> {folder_name}")
                except shutil.Error as e:
                    print(f"移动文件出错: {e}")

if __name__ == "__main__":
    organize_files()
依靠文件系统的扩展名元数据瞬间完成归类,大幅降低杂乱下载目录带来的认知负荷。
完成判断与排错建议
完成状态判断:各脚本运行正常时,终端应按预期打印 print 日志,且对应文件发生重命名/归档/删除,CSV 文件体积增长,或后台弹出系统通知窗口。
常见排查:若脚本报 PermissionError,请检查当前用户是否具备目标目录的读写权限;网络脚本频繁触发连接拒绝时,确认目标 API 是否限流或是否需要代理中转;psutil 相关报错通常源于权限不足或版本不匹配,可通过 pip install --upgrade psutil 更新。
性能优化:批量文件操作建议先使用 os.walk 或 glob 提前构建文件清单,避免在循环内重复调用底层 stat 调用。
总结
这组脚本聚焦于日常开发中最易重复的八类痛点,从网络容错到磁盘清理,从进程守卫到数据导出,均以最小依赖实现高可用逻辑。结合定时任务调度或 CI/CD 管道,可进一步将其升维为完整的运维自动化体系。掌握这些基础模式,能让代码真正承担琐碎劳动,使工程师专注于架构设计与核心业务。
以上就是8个常用Python自动化脚本实操指南的详细内容,更多关于Python自动化脚本批量处理文件与定时任务自动化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









