

Python爬取搜狗图片实战:从静态解析到动态接口抓取

本文详解使用Python爬取搜狗图片壁纸的全过程。针对网页动态加载特性,通过F12开发者工具分析Network中的XHR请求,定位获取图片列表的真实API接口。利用requests库发送请求并解析JSON数据,结合urllib实现图片的批量下载,提供完整代码示例与调试技巧。
前言
近期深入研究了备受关注的爬虫技术,并整理了一些实践心得。接下来将展开具体内容的讲解。
执行本教程所需的环境配置如下:
需从Python 3.6官方网站下载对应版本。
也可通过本地渠道进行下载。
本次演示以搜狗图片网站作为爬取目标。
首先访问搜狗图片首页 http://pic.sogou.com/,选择“壁纸”分类(此处仅作为示例)。在尝试爬取特定网站资料前,初步了解其页面结构是必要的步骤。
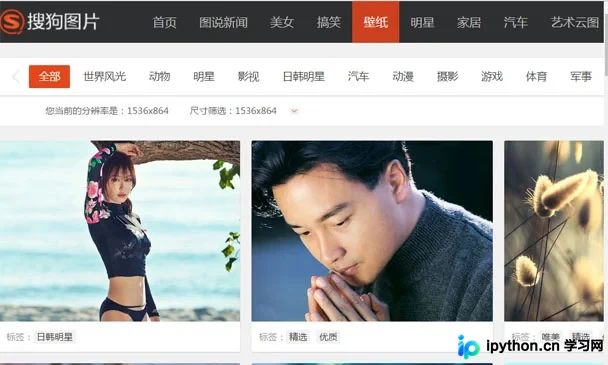
进入页面后,按下F12键打开浏览器开发人员工具,本文示例使用的是Chrome浏览器。
在图片上点击右键,选择“检查”元素。
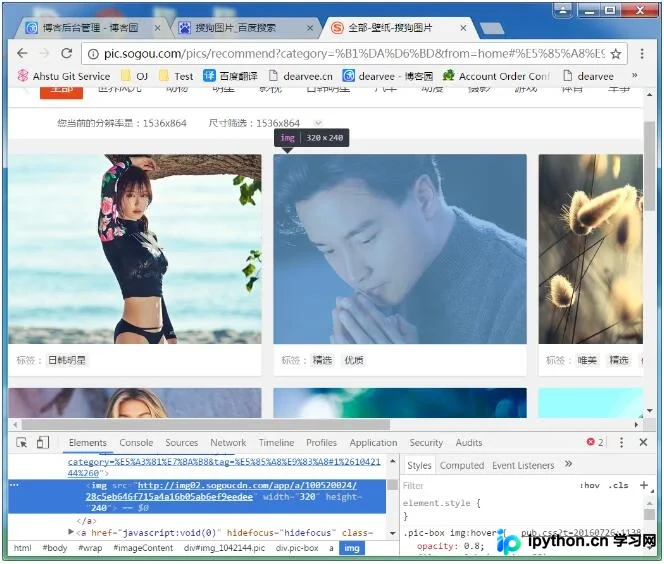
通过检查发现,目标图片的链接地址存储在img标签的src属性中。初步思路是使用Python的requests库提取该HTML组件,获取img的src属性值,随后利用urllib.request.urlretrieve函数逐个下载图片,从而实现批量获取资料的目的。思路明确后,确定要爬取的URL为 http://pic.sogou.com/pics/recommend?category=%B1%DA%D6%BD,该地址来源于进入分类后的浏览器地址栏。明确了URL地址,接下来开始编写代码。
在编写爬虫程序时,建议逐步调试,确保每一步操作准确无误,这是开发者应养成的良好习惯。接下来,我们将剖析该URL指向的网页内容。
import requests
import urllib
from bs4 import BeautifulSoup
res = requests.get('http://pic.sogou.com/pics/recommend?category=%B1%DA%D6%BD')
soup = BeautifulSoup(res.text,'html.parser')
print(soup.select('img'))
程序输出结果如下:
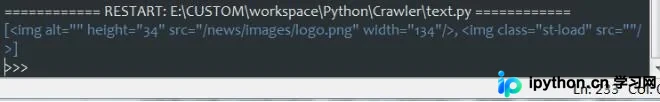
观察输出内容发现,其中并未包含我们所需的图片元素,仅解析到了logo相关的img标签。这表明目标图片数据并不直接存在于当前URL(即 http://pic.sogou.com/pics/recommend?category=%B1%DA%D6%BD)的静态HTML中。因此推测该元素可能是动态生成的。细心的用户可能会注意到,在网页内向下滚动鼠标滚轮时,图片会动态刷新加载。这意味着该网页并非一次性加载所有资源,而是采用动态加载机制,以避免页面过于庞大影响加载速度。接下来的探索过程较为繁琐,我们需要找到所有图片真正的数据来源URL。作为初学者,寻找这一过程颇具挑战。最终,通过F12开发者工具,依次点击Network(网络)> XHR(XMLHttpRequest),并点击XHR列表中的文件,查看Preview(预览)选项卡。
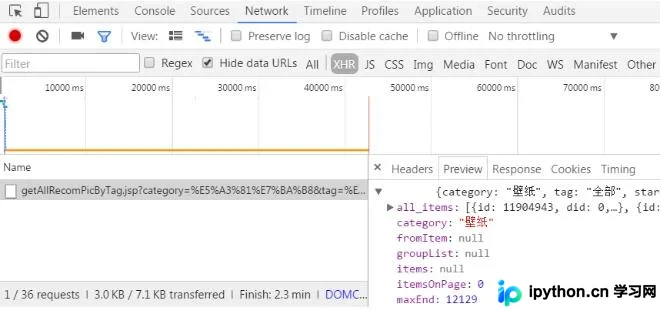
此时发现结果已接近目标元素。展开all_items节点,可以看到0、1、2、3等索引,这些似乎对应着图片元素。尝试打开其中一个URL,确认确实是图片地址。找到目标后,点击XHR列表下的Headers(标头)选项卡。
获取到的关键信息如下:
Request URL(请求URL):
http://pic.sogou.com/pics/channel/getAllRecomPicByTag.jsp?category=%E5%A3%81%E7%BA%B8&tag=%E5%85%A8%E9%83%A8&start=0&len=15&width=1536&height=864。尝试简化该URL,技巧在于删除可能不必要的参数后,访问仍能正常进行。经过筛选,最终得到的简化URL为:http://pic.sogou.com/pics/channel/getAllRecomPicByTag.jsp?category=%E5%A3%81%E7%BA%B8&tag=%E5%85%A8%E9%83%A8&start=0&len=15。从字面理解,category参数后接分类名称,start参数表示起始索引,len参数表示长度,即图片的数量。明确参数含义后,开始编写代码。
开发环境为Win7系统下的Python 3.6,运行程序前需安装requests库。
在Python 3.6环境中安装requests库,需在CMD命令行中输入:
pip install requests
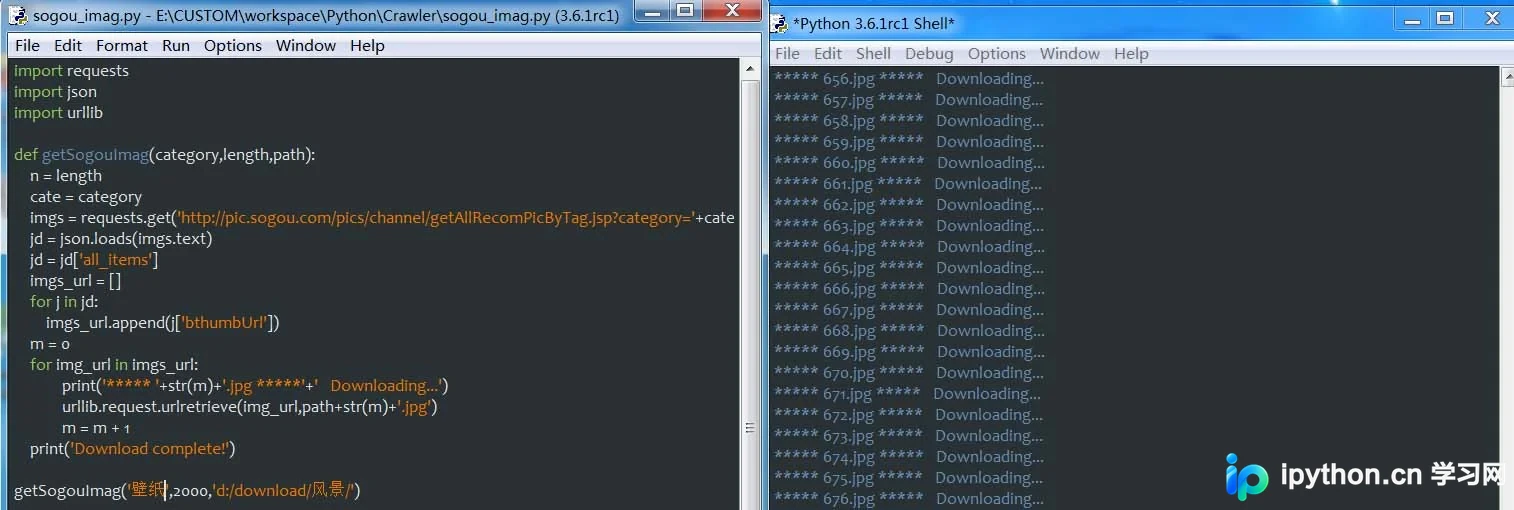
笔者在编写过程中边调试边完善,现将最终代码展示如下:
import requests
import json
import urllib

def getSogouImag(category,length,path):
 n = length
 cate = category
 imgs = requests.get('http://pic.sogou.com/pics/channel/getAllRecomPicByTag.jsp?category='+cate+'&tag=%E5%85%A8%E9%83%A8&start=0&len='+str(n))
 jd = json.loads(imgs.text)
 jd = jd['all_items']
 imgs_url = []
 for j in jd:
  imgs_url.append(j['bthumbUrl'])
 m = 0
 for img_url in imgs_url:
   print('***** '+str(m)+'.jpg *****'+' Downloading...')
   urllib.request.urlretrieve(img_url,path+str(m)+'.jpg')
   m = m + 1
 print('Download complete!')

getSogouImag('壁纸',2000,'d:/download/壁纸/')
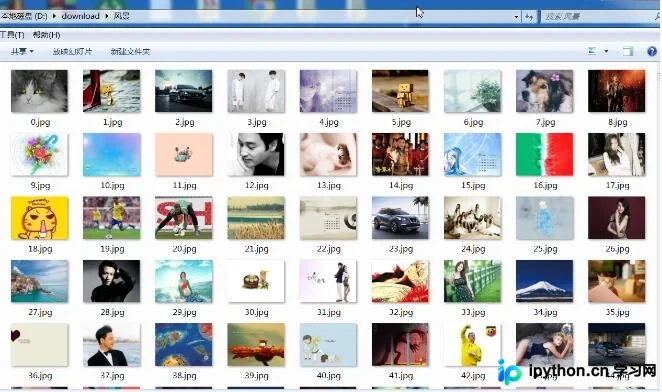
当程序运行起来时,笔者感到颇为兴奋。效果如下:
至此,关于该爬虫程序的编程过程叙述完毕。整体来看,找到需要爬取元素所在的URL,是爬虫开发中的关键环节。
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作能带来一定的帮助,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









