

Python正则表达式抓取网易新闻评论实战

本文介绍使用Python正则表达式抓取网易新闻评论的方法。通过抓包工具定位隐藏评论接口,利用urllib2发起请求并获取HTML数据,再经正则处理提取JSON中的评论字段。代码包含分页处理、异常捕获及文件写入逻辑,适合Python初学者参考正则在爬虫中的应用。
本文通过一个具体实例,详细讲解如何使用Python结合正则表达式来抓取网易新闻的评论数据,供读者学习参考。
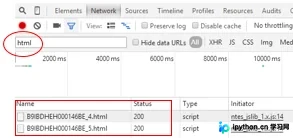
在尝试编写网易新闻爬虫时,发现直接解析网页源代码无法获取与页面显示的评论一致的内容。因此,作者借助抓包工具分析了网络请求,成功定位到承载评论数据的隐藏接口地址。需要注意的是,不同浏览器均自带或可安装抓包工具,可用于此类网站结构分析。
在抓包分析的结果中,若仔细观察网络请求列表,会发现一个具有特殊特征的请求,该请求即为获取评论数据的关键目标。
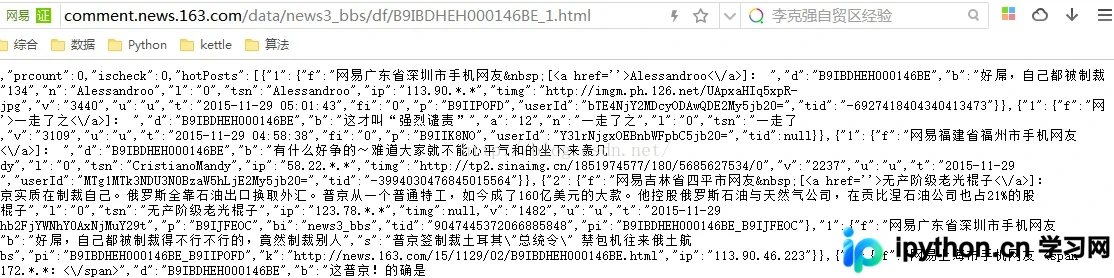
通过浏览器直接打开上述定位到的链接,即可查看到对应的评论内容数据,如下图所示展示了第一页的抓取结果。
以下是基于上述分析编写的Python实现代码,部分逻辑参考了相关技术文章进行了调整。
#coding=utf-8
import urllib2
import re
import json
import time
class WY():
  def __init__(self):
    self.headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 5.1) AppleWebKit/534.24 (KHTML, like '}
    self.url='http://comment.news.163.com/data/news3_bbs/df/B9IBDHEH000146BE_1.html'
  def getpage(self,page):
    full_url='http://comment.news.163.com/cache/newlist/news3_bbs/B9IBDHEH000146BE_'+str(page)+'.html'
    return full_url
  def gethtml(self,page):
    try:
      req=urllib2.Request(page,None,self.headers)
      response = urllib2.urlopen(req)
      html = response.read()
      return html
    except urllib2.URLError,e:
      if hasattr(e,'reason'):
        print u"连接失败",e.reason
        return None
  #处理字符串
  def Process(self,data,page):
    if page == 1:
      data=data.replace('var replyData=','')
    else:
      data=data.replace('var newPostList=','')
    reg1=re.compile(" \[<a href=''>")
    data=reg1.sub(' ',data)
    reg2=re.compile('<\\\/a>\]')
    data=reg2.sub('',data)
    reg3=re.compile('<br>')
    data=reg3.sub('',data)
    return data
  #解析json
  def dealJSON(self):
    with open("WY.txt","a") as file:
      file.write('ID'+'|'+'评论'+'|'+'踩'+'|'+'顶'+'\n')
    for i in range(1,12):
      if i == 1:
        data=self.gethtml(self.url)
        data=self.Process(data,i)[:-1]
        value=json.loads(data)
        file=open('WY.txt','a')
        for item in value['hotPosts']:
          try:
            file.write(item['1']['f'].encode('utf-8')+'|')
            file.write(item['1']['b'].encode('utf-8')+'|')
            file.write(item['1']['a'].encode('utf-8')+'|')
            file.write(item['1']['v'].encode('utf-8')+'\n')
          except:
            continue
        file.close()
        print '--正在采集%d/12--'%i
        time.sleep(5)
      else:
        page=self.getpage(i)
        data = self.gethtml(page)
        data = self.Process(data,i)[:-2]
        # print data
        value=json.loads(data)
        # print value
        file=open('WY.txt','a')
        for item in value['newPosts']:
          try:
            file.write(item['1']['f'].encode('utf-8')+'|')
            file.write(item['1']['b'].encode('utf-8')+'|')
            file.write(item['1']['a'].encode('utf-8')+'|')
            file.write(item['1']['v'].encode('utf-8')+'\n')
          except:
            continue
        file.close()
        print '--正在采集%d/12--'%i
        time.sleep(5)
if __name__ == '__main__':
  WY().dealJSON()
以上即为完整的网易新闻评论抓取代码实现。
此外,为了方便读者进行正则表达式的调试与生成,推荐以下两款实用的在线工具:
JavaScript正则表达式在线测试工具: http://tools.jb51.net/regex/javascript
正则表达式在线生成工具: http://tools.jb51.net/regex/create_reg
如需深入了解Python相关知识,可进一步查阅本站系列教程,包括《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python Socket编程技巧总结》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》以及《Python文件与目录操作技巧汇总》。
希望本文提供的代码与思路能对从事Python程序设计的朋友有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









