

Python爬取拉勾网职位数据实战:从请求分析到MySQL存储

本文详解使用Python爬取拉勾网职位数据的全过程。通过分析Network请求定位positionAjax接口,解决反爬拦截问题,利用requests库构造Header与参数获取JSON数据,并使用pymysql将结果存入MySQL数据库。文章提供了完整的代码逻辑与配置示例,适用于求职数据分析与职业规划参考。
本文介绍一个基于Python的简单爬虫案例,目标对象为知名招聘平台拉勾网。鉴于职业发展与求职信息的重要性,抓取并分析拉勾网的数据对职业规划及求职决策具有显著辅助价值。
最终实现效果展示
数据抓取仅是基础,后续的数据处理与分析同样关键。不过,本文作为入门级爬虫教程,核心目标仅在于成功抓取拉勾网的职位信息并将其持久化存储至MySQL数据库。具体效果如下图所示:
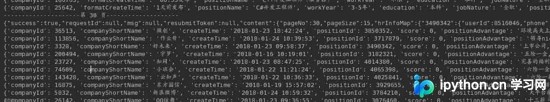
控制台运行输出示例
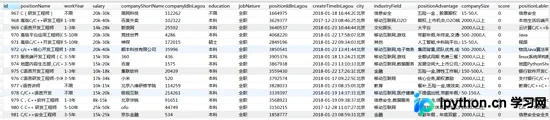
数据库存储结果展示
环境准备与依赖安装
首先需确保Python环境已就绪,网络上相关教程众多,此处假设读者已完成Python安装。博主所用环境为Python 3.6,并安装了requests用于网络请求、pymysql用于数据库连接,以及本地MySQL数据库服务。
拉勾网请求机制分析
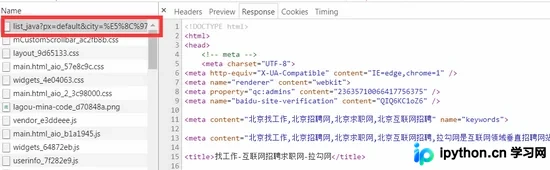
打开拉勾网首页,在控制台搜索“Java”职位并筛选北京地区。观察Network面板中的第一个请求,看似为目标接口,但实际访问该HTML页面会触发拉勾网的反爬机制,返回“操作过于频繁”的提示。值得注意的是,该页面使用了模板加载技术,这种数据加载方式能显著提升渲染速度,值得借鉴。
继续排查Network请求,发现以“positionAjax”开头的接口,这正是我们需要的真实数据接口。其URL格式如下:https://www.lagou.com/jobs/positionAjax.json?px=default&city=%E5%8C%97%E4%BA%AC&needAddtionalResult=false&isSchoolJob=0。具体请求细节可参考下图:
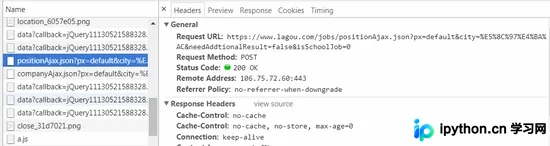
确定请求地址后,即可开始编写爬虫代码。
首先导入requests和pymysql库。尝试直接POST访问上述URL会被拦截,因为缺少必要的传输数据和请求头(Headers),服务器会将其识别为非人类请求。因此,必须构造完整的请求头和数据载荷。
 headers = {'Referer':'https://www.lagou.com/jobs/list_'+position+'?city=%E5%8C%97%E4%BA%AC&cl=false&fromSearch=true&labelWords=&suginput=',    'Origin':'https://www.lagou.com',    'User-Agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/62.0.3202.94 Safari/537.36',
    'Accept':'application/json, text/javascript, */*; q=0.01',
    'Cookie':'JSESSIONID=ABAAABAAAGFABEFE8A2337F3BAF09DBCC0A8594ED74C6C0; user_trace_token=20180122215242-849e2a04-ff7b-11e7-a5c6-5254005c3644; LGUID=20180122215242-849e3549-ff7b-11e7-a5c6-5254005c3644; index_location_city=%E5%8C%97%E4%BA%AC; _gat=1; TG-TRACK-CODE=index_navigation; _gid=GA1.2.1188502030.1516629163; _ga=GA1.2.667506246.1516629163; LGSID=20180122215242-849e3278-ff7b-11e7-a5c6-5254005c3644; LGRID=20180122230310-5c6292b3-ff85-11e7-a5d5-5254005c3644; Hm_lvt_4233e74dff0ae5bd0a3d81c6ccf756e6=1516629163,1516629182; Hm_lpvt_4233e74dff0ae5bd0a3d81c6ccf756e6=1516633389; SEARCH_ID=8d3793ec834f4b0e8e680572b83eb968'
    }
 dates={'first':'true',
   'pn': page,#页数
   'kd': position#搜索的职位
 }
添加请求头后成功发起请求,控制台输出显示为JSON格式数据。通过解析JSON对象,逐步定位到目标数据,发现所有职位信息均包含在“result”字段中,因此只需提取该部分即可。
result=resp.json()['content']['positionResult']['result']
观察返回数据,数量约为30条左右,字段均为英文,含义清晰可辨。接下来需将这些数据存入数据库,以便后续进行深入分析。
使用pymysql连接MySQL数据库。在代码中预先创建好数据库和数据表,并添加相应的配置信息。
config={
 "host":"127.0.0.1",
 "user":"root",
 "password":"",
 "database":databaseName,
 "charset":"utf8"#防止中文乱码
}
加载配置文件以建立数据库连接。
db = pymysql.connect(**config)
cursor = db.cursor()
sql=""#insert语句
cursor.execute()
db.commit() #提交数据
cursor.close()
db.close()#用完记得关闭连接
至此,拉勾网的职位信息已成功存入您的数据库,等待进一步挖掘。获取这些数据后,您可以进行诸如平均工资水平统计、职位技能要求分析等深度工作。
受篇幅限制,部分代码(如较长的SQL插入语句)未在此展示。完整程序已上传至GitHub,地址为:https://github.com/wudb1993/pythonDemo。如果觉得有帮助,欢迎在GitHub上Star支持。如有问题或建议,欢迎交流探讨。
总结
以上介绍了使用Python爬取拉勾网职位数据的方法,希望能为读者提供帮助。如有疑问,欢迎留言,小编会及时回复。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









