

Python解析.docx文件提取正文内容的原理与实现

发布时间:2026-10-13| 3人浏览过
本文详解Python读取.docx文件正文信息的原理。.docx本质是包含XML的ZIP压缩包,正文存储于word/document.xml中。通过Python解压文件并解析该XML,可提取文本内容。文中提供基于ZipFile和BeautifulSoup的完整代码示例,展示如何遍历并打印文档正文。
本文介绍利用Python读取*.docx文件信息的方法,部分python-word库的功能即建立在此基础之上。
内容分为两个部分进行说明:
- Word(*.docx)文件结构简述
- Python提取Word信息的具体步骤
Word(*.docx)文件结构简述
2008年以前,Office套件中的Word主要使用.doc二进制格式,该格式与其他软件的兼容性较差。为适应技术发展,微软采用类XML格式标准定义了新版Word文件.docx。.docx文件实际上是一个ZIP压缩包,例如名为test.docx的文件:
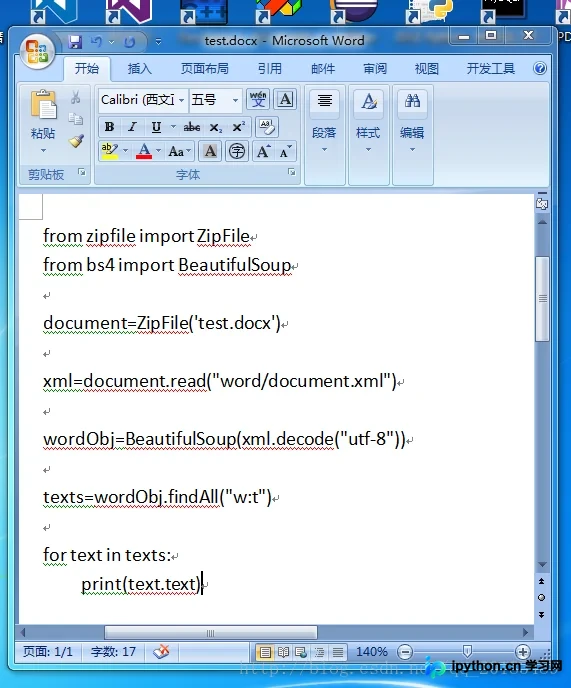
其内部结构如下:
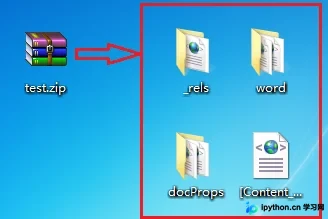
将文件后缀名改为test.zip后解压,可获得以下文件列表:
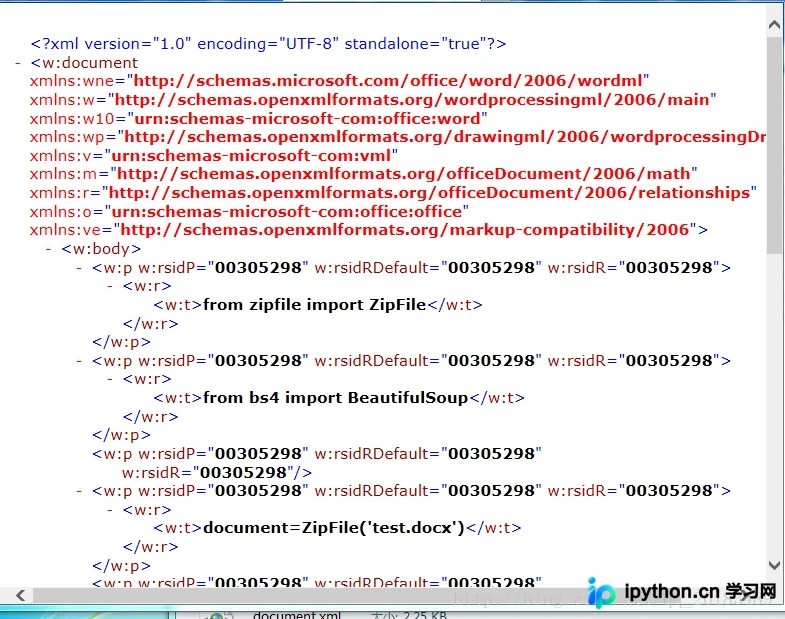
其中,Word文档的正文内容保存在word/document.xml文件中,打开该文件可查看具体内容:
Python提取Word信息
依据Word(.docx)文件格式,提取正文信息需遵循以下步骤:
1 解压.docx文件;2 使用BeautifulSoup解析word/document.xml以提取正文信息。
具体实现代码如下:
from zipfile import ZipFile
from bs4 import BeautifulSoup

document=ZipFile('test.docx')
xml=document.read("word/document.xml")
wordObj=BeautifulSoup(xml.decode("utf-8"))
texts=wordObj.findAll("w:t")
for text in texts:
  print(text.text)
以上即为本文的全部内容,希望对读者的学习有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









