Python爬虫实战:利用Chrome开发者工具抓取Ajax动态加载数据
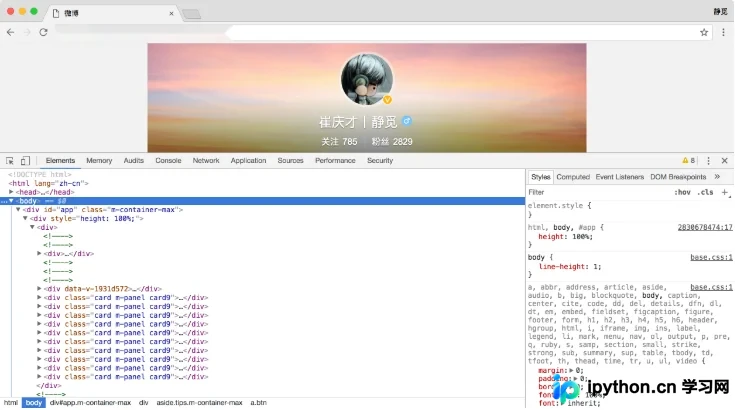
本文详解如何使用Chrome开发者工具分析微博等网站的Ajax动态加载内容。通过Network面板定位XHR类型请求,解析Request Headers中的XMLHttpRequest标识及JSON响应数据,并结合XHR筛选功能高效捕获所有异步请求,为Python程序模拟请求和提取数据奠定基础。
2026-10-14
7

本文详解如何使用Chrome开发者工具分析微博等网站的Ajax动态加载内容。通过Network面板定位XHR类型请求,解析Request Headers中的XMLHttpRequest标识及JSON响应数据,并结合XHR筛选功能高效捕获所有异步请求,为Python程序模拟请求和提取数据奠定基础。
本文详解如何在Python3爬虫中使用Splash进行高并发抓取时,通过Nginx配置负载均衡以分散压力。涵盖最少链接、轮询、权重及IP散列四种策略,并介绍基于Nginx的认证配置与测试方法,帮助提升爬虫系统的稳定性和处理效率。
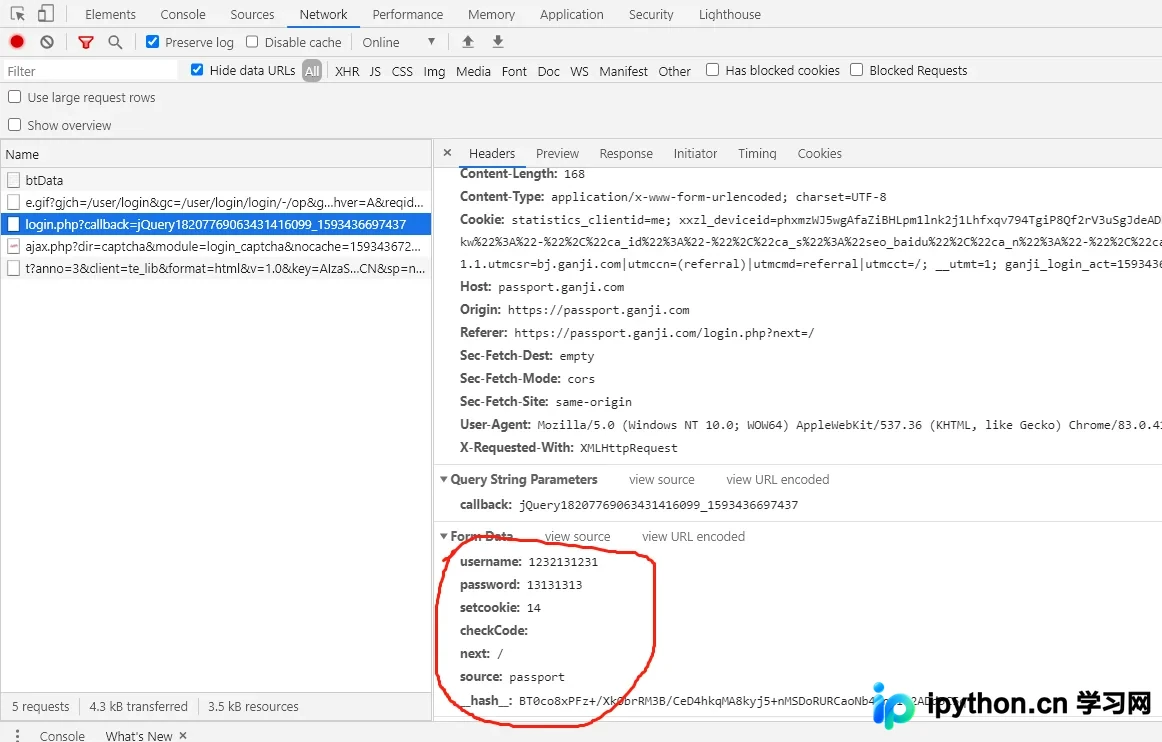
本文详细讲解如何使用Scrapy框架模拟登录赶集网。通过分析登录接口的POST请求参数,包括setcookie、__hash__及验证码机制,提供完整的Python代码实现。内容涵盖项目创建、Spider编写、表单数据构造及登录后的处理流程,帮助开发者掌握动态参数提取与自动登录技巧。
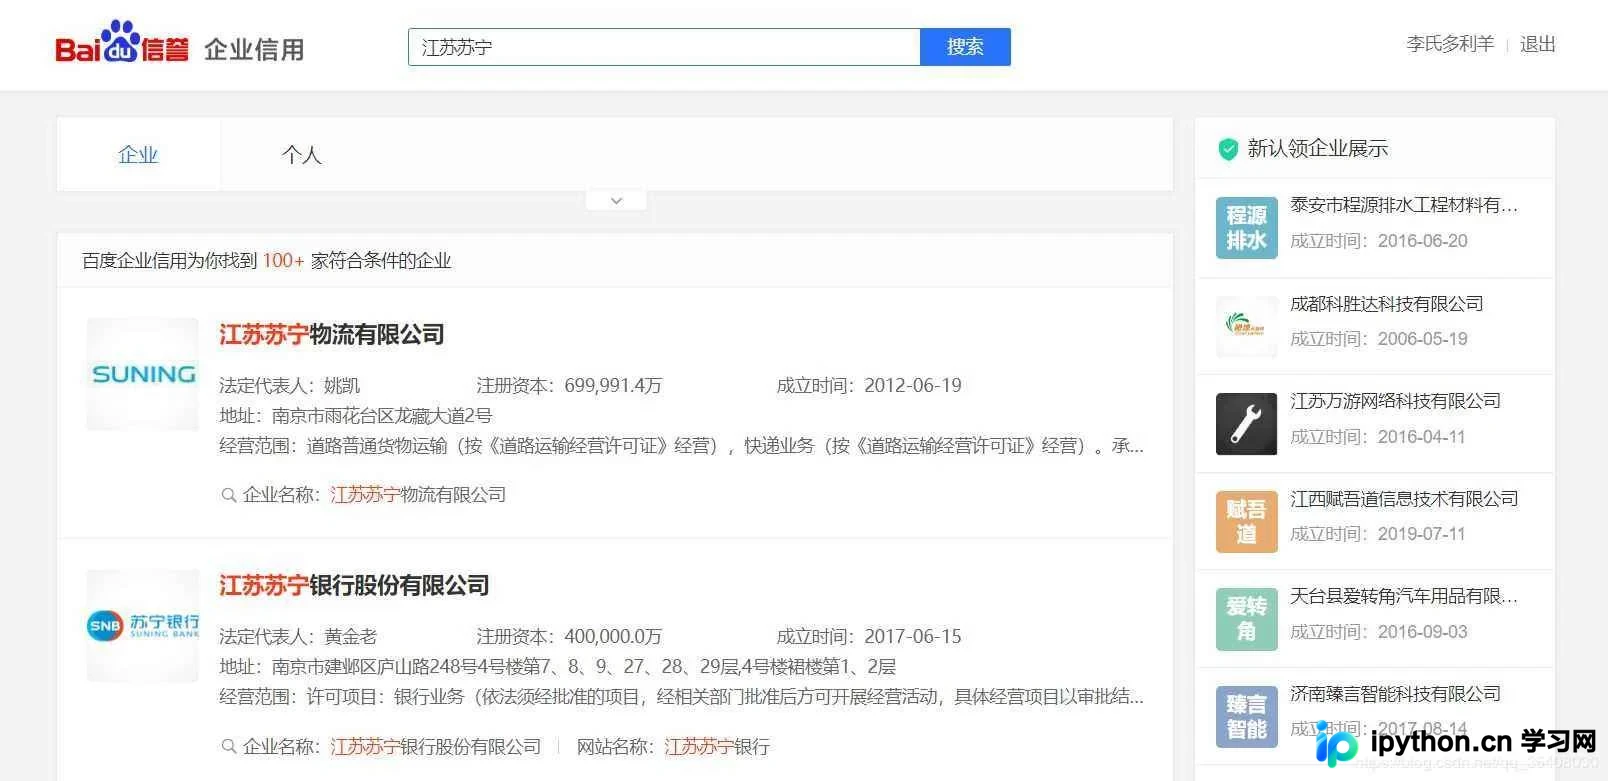
本文介绍如何使用Python爬虫从百度企业信用网站获取企业基本信息。通过分析页面JavaScript动态生成的数据,利用正则表达式提取resultList字段并转换为JSON对象,从而获取企业名称、法人、注册资本等详细信息。文章提供完整源码及调用示例,适用于学习参考,请勿用于恶意爬取。
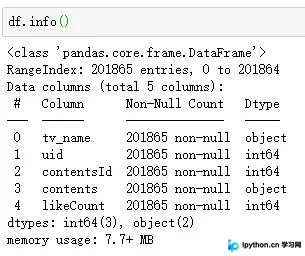
本文利用Python对热播网剧《隐秘的角落》进行弹幕数据爬取与分析。通过解析爱奇艺.z格式压缩文件,获取近20万条弹幕,统计高频发言用户、分集互动热度及高赞内容,揭示观众对剧情冲突的关注点与角色讨论热度,为剧集数据分析提供技术参考。
本文介绍在Python爬虫中遇到Cloudflare邮箱加密时的解决方案。通过分析前端JS代码,提取基于异或运算的解密逻辑,并使用Python的execjs库加载并调用该JS函数,成功还原加密后的邮箱地址,实现自动化采集。
本文详解Python爬虫中常见的403禁止访问及网络超时问题。通过模拟浏览器User-Agent解决反爬限制,利用requests模块设置timeout参数处理超时,并演示如何捕获ReadTimeout、HTTPError等具体异常类,提升爬虫稳定性。
本文详细介绍如何利用Python构建一个自动化的网站通知监控系统。通过urllib和BeautifulSoup抓取网页内容,结合sqlite3建立本地数据库以存储历史通知。系统模拟SMTP服务器(如QQ邮箱)实现邮件发送功能,并通过Windows任务计划程序设定定时执行脚本,从而实现对目标网站最新通知的实时监测与自动邮件提醒。
本文详解Python爬虫可获取的数据类型,涵盖电商、房产、招聘及社交平台案例。针对初学者常遇的学习误区,提供从基础包使用到分布式爬虫的六步平滑学习路径,帮助零基础上手高效采集数据。
本文针对Windows任务计划频繁挂起的问题,探讨Python爬虫定时任务的实现方案。首先分析基于while True死循环的简单实现及其在复杂场景下的局限性,如多任务并发、网络稳定性及异常处理等。文章指出该方法适用于低频单次执行场景,后续将介绍更稳健的定时任务解决方案,帮助开发者优化爬虫调度策略。
本文分析使用Python Selenium结合多线程执行定时任务时,因频繁启动浏览器实例导致CPU占用率飙升至90%以上的问题。通过展示基于threading.Timer的简易定时代码,指出其潜在性能瓶颈,并探讨如何优化资源占用以避免系统卡顿,适用于需要长期运行的自动化爬虫场景。
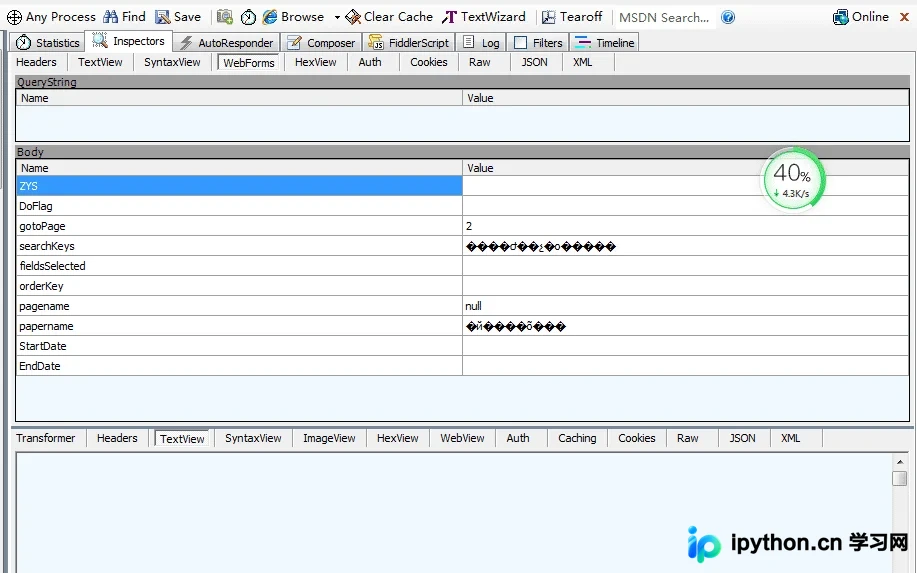
本文解析Python爬虫抓取网站时遇到的URL参数乱码问题。通过示例展示如何将中文字符串按GBK2312编码后进行百分号编码,利用urllib.quote函数生成符合要求的URL参数格式,帮助开发者解决中文请求参数乱码困扰。