

Python实战:爬取并分析《隐秘的角落》弹幕数据

本文利用Python对热播网剧《隐秘的角落》进行弹幕数据爬取与分析。通过解析爱奇艺.z格式压缩文件,获取近20万条弹幕,统计高频发言用户、分集互动热度及高赞内容,揭示观众对剧情冲突的关注点与角色讨论热度,为剧集数据分析提供技术参考。
前言与背景
前言
近期大热的网剧《隐秘的角落》想必不少读者已在端午假期期间追完。笔者也顺应潮流,一口气看完了全部12集。对于看过该剧的观众而言,朋友圈中流传的“一起去爬山”、“小白船”以及“还有机会吗”等梗早已心照不宣;若尚未观看且已为人父母,强烈建议补看,以免错过话题核心。
剧集本身质量上乘,但追剧文化中常有“弹幕比正片更精彩”的说法。为了延续这份精彩,我们将目光转向该剧的弹幕数据。由于该剧在爱奇艺平台独播,从该平台抓取数据是最为直接且合适的途径。
弹幕数据爬取技术实现
爬取弹幕
爱奇艺的弹幕数据以.z格式的压缩文件形式存储。整个抓取流程大致分为三步:首先获取tvid列表,随后根据tvid定位并下载对应的弹幕压缩文件,最后对文件进行解压处理并存储数据。
def get_data(tv_name,tv_id):
 url = https://cmts.iqiyi.com/bullet/{}/{}/{}_300_{}.z
 datas = pd.DataFrame(columns=[uid,contentsId,contents,likeCount])
 for i in range(1,20):
  myUrl = url.format(tv_id[-4:-2],tv_id[-2:],tv_id,i)
  print(myUrl)
  res = requests.get(myUrl)
  if res.status_code == 200:
   btArr = bytearray(res.content)
   xml=zlib.decompress(btArr).decode(utf-8)
   bs = BeautifulSoup(xml,"xml")
   data = pd.DataFrame(columns=[uid,contentsId,contents,likeCount])
   data[uid] = [i.text for i in bs.findAll(uid)]
   data[contentsId] = [i.text for i in bs.findAll(contentId)]
   data[contents] = [i.text for i in bs.findAll(content)]
   data[likeCount] = [i.text for i in bs.findAll(likeCount)]
  else:
   break
  datas = pd.concat([datas,data],ignore_index = True)
 datas[tv_name]= str(tv_name)
 return datas
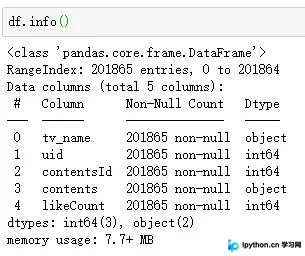
经过处理,我们共获取到201865条《隐秘的角落》弹幕数据。
高频发言用户行为分析
弹幕发射器
通过按用户ID分组并对弹幕ID进行计数,我们可以统计出每位用户的累计发送弹幕数量。
#累计发送弹幕数的用户
danmu_counts = df.groupby(uid)[contentsId].count().sort_values(ascending = False).reset_index()
danmu_counts.columns = [用户id,累计发送弹幕数]
danmu_counts.head()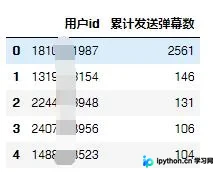
累计发送弹幕数用户top5
数据显示,排名第一的用户发送了2561条弹幕。考虑到这仅仅是一部12集的短剧,这一数量相当惊人。
这是否意味着该用户是水军,且每条弹幕内容高度雷同?
df_top1 = df[df[uid] == 1810351987].sort_values(by="likeCount",ascending = False).reset_index()
df_top1.head(10)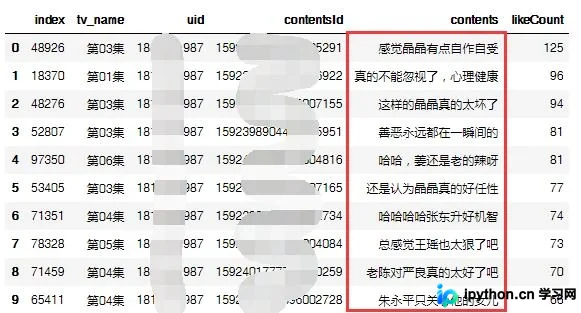
事实并非如此。深入查看发现,该用户的每一条弹幕均是基于剧情的有感而发,推测其可能是在观看过程中随时发表观点,而非批量刷屏。
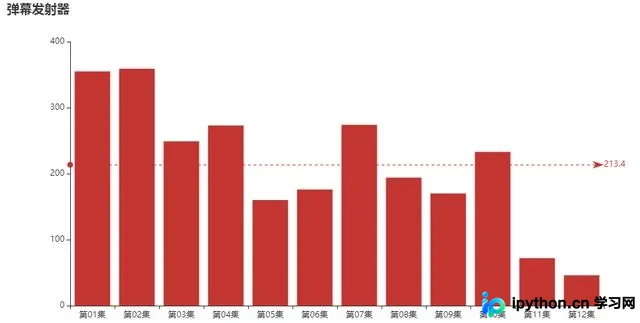
那么,这位“弹幕发射器”在每一集中的弹幕输出情况又是如何分布的呢?
分集&平均弹幕量
通过观察各集弹幕量的分布图,我们可以侧面推测,部分剧集可能因戏剧冲突更为激烈,从而引发了观众更多的吐槽与讨论。
建议这位“弹幕发射器”在剧情更为紧张的第11、12集中加大输出力度。
高赞弹幕与剧情共鸣点
这些弹幕大家都认同
排除掉那位高频发言的用户后,我们继续深入探究各集的弹幕分布特征。
接下来,我们将聚焦于每一集中获得点赞数最高的弹幕,看看哪些内容最能引发观众共鸣。
df_like = df[df.groupby([tv_name])[likeCount].rank(method="first", ascending=False)==1].reset_index()[[tv_name,contents,likeCount]]
df_like.columns = [剧集,弹幕,赞]
df_like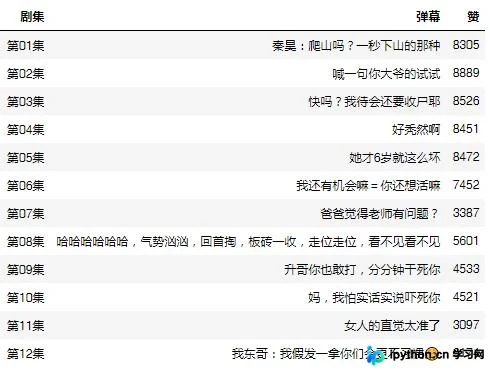
每一集中点赞最多的弹幕
每一集的高赞弹幕往往是对当集剧情的精准浓缩,这些内容实质上是由观众票选出的“梗”或吐槽点。
这应该不算剧透吧?不算吧,不算吧。
实在不行,我请你去爬山也可以。
剧集角色热度与总结
总结
除了精彩的剧本和配乐外,剧中“老戏骨”与“小演员”们的精湛演技也赢得了网友的一致好评。
尽管该剧仅有短短12集,但其故事线并未局限于个别角色。每个角色背后都有独立的故事线,并通过各种巧合相互交织,从而引发了观众持续且热烈的讨论。
为了进一步分析观众关注点,我们统计了演员在弹幕中出现的频率,以了解剧中哪些角色被提及最多。
至此,关于利用Python分析热播网剧《隐秘的角落》的介绍便告一段落。如需了解更多Python分析《隐秘的角落》的相关内容,欢迎搜索本站历史文章或继续浏览后续系列文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









