

Python3实现B站视频弹幕抓取教程
本文介绍如何使用Python3和requests模块抓取B站视频的历史弹幕数据。通过Chrome开发者工具分析网络请求,定位rolldate和dmroll接口,获取弹幕ID及时间戳。利用正则表达式解析返回的XML数据,按日期保存弹幕内容至本地文件,为后续词云或情感分析提供数据支持。
2026-10-14
7

本文介绍如何使用Python3和requests模块抓取B站视频的历史弹幕数据。通过Chrome开发者工具分析网络请求,定位rolldate和dmroll接口,获取弹幕ID及时间戳。利用正则表达式解析返回的XML数据,按日期保存弹幕内容至本地文件,为后续词云或情感分析提供数据支持。
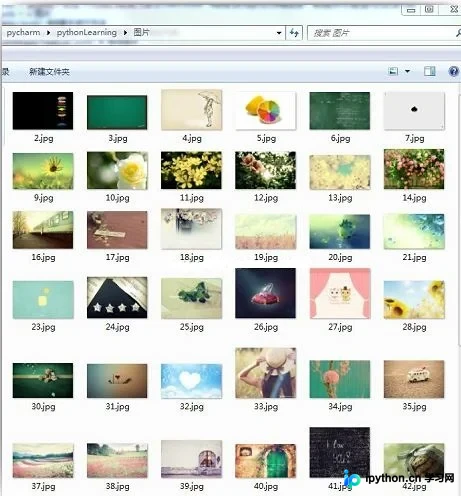
本文详细介绍如何使用Python的urllib和re模块抓取网页图片。通过获取HTML源码,利用正则表达式过滤图片URL,并实现本地保存功能。代码以百度贴吧为例,演示了从获取源码、解析链接到创建文件夹保存多张图片的完整流程,适合Python初学者参考学习。
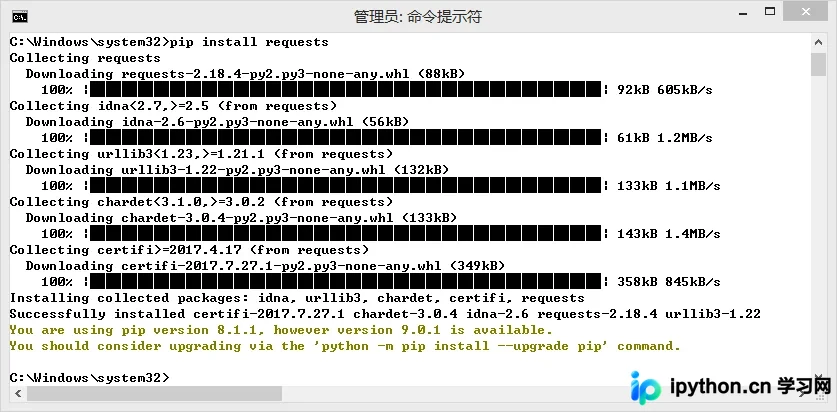
本文系统讲解Python网络爬虫的核心技术与Requests库的实战应用。内容涵盖Requests库的安装配置、核心方法解析(get/post等)、Response对象属性及异常处理机制。深入剖析HTTP协议、URL结构及PATCH与PUT的区别,并结合京东、亚马逊商品爬取、搜索引擎关键词提交、图片存储及IP查询等具体案例,展示网络爬虫的实际操作流程与注意事项。
本文介绍如何使用PHP脚本自动从HTML文件中批量抓取ED2K(电驴)下载链接。通过读取文件内容,利用字符串定位函数精准截取href属性中的资源路径,并逐个保存至日志文件,解决手动复制多个磁力或ED2K链接效率低下的问题。
本文详细记录了使用Python编写小说爬虫的全过程。文章从确定目标网址、分析页面结构入手,重点讲解了如何使用urllib.request获取网页内容,并通过设置Headers解决403 Forbidden错误。同时,针对常见的编码乱码问题,介绍了使用chardet库检测编码及手动指定GBK编码的方法,并结合socket.timeout处理网络超时异常,最终通过正则表达式提取章节内容并写入文件,提供了完整的代码实现参考。
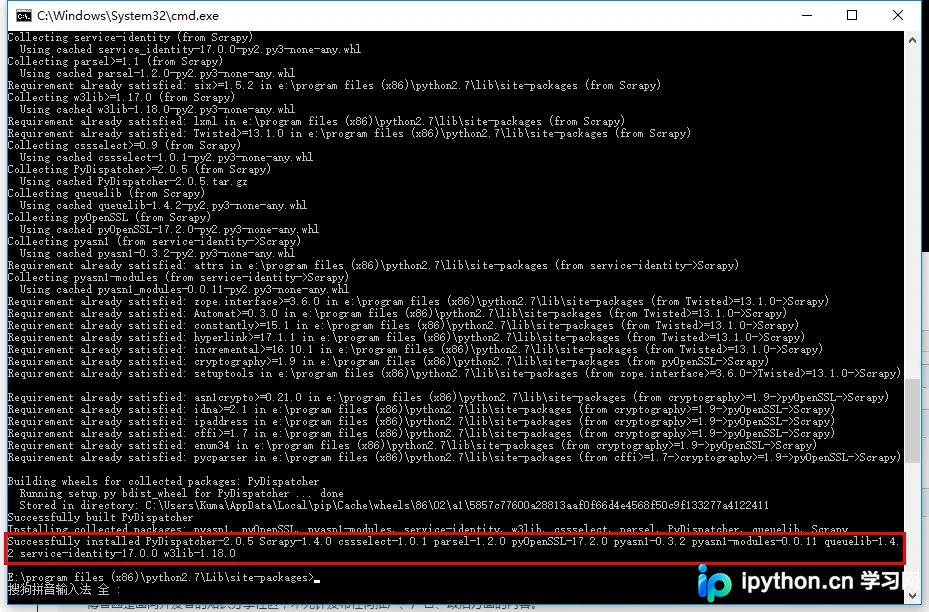
本文详细介绍 Python 中 Scrapy 框架的安装方法。首先通过 pip install Scrapy 进行常规安装,若遇到 lxml、Twisted 或 cryptography 等依赖库安装失败的情况,提供使用 wheel 工具及预编译 whl 文件的详细解决步骤,包括如何获取支持标签及下载对应版本的 whl 文件进行本地安装。
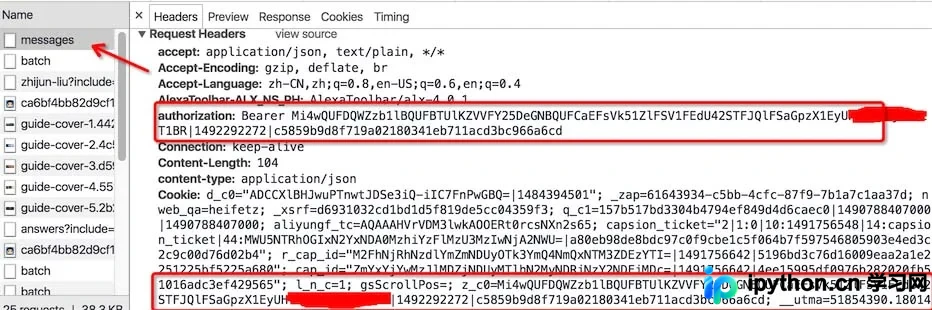
本文基于Python的requests库,详细解析如何构建知乎私信发送API。通过抓包分析HTTP请求头、URL及JSON请求体,获取用户ID与认证信息,实现登录状态下的私信发送功能。教程涵盖从网络请求追踪到代码实现的完整流程,提供获取用户信息、构造请求及调用API的关键代码示例,帮助开发者掌握利用requests模拟浏览器操作的核心技巧。
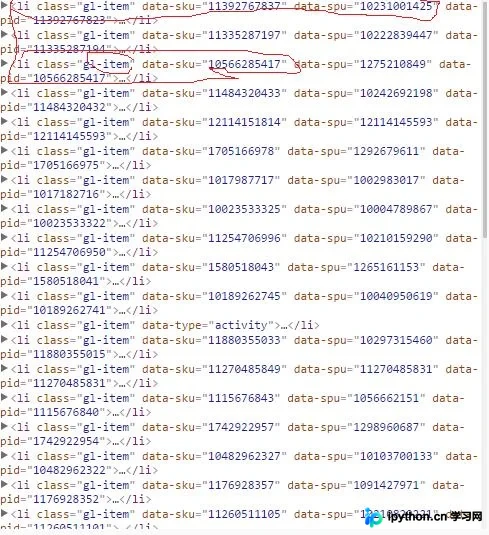
本文详解如何利用Python爬取京东商城商品数据。通过分析Ajax异步加载机制,结合Requests获取HTML源码,使用BeautifulSoup解析DOM结构提取data-pid及图片URL。教程涵盖简化请求URL、处理懒加载图片属性、多线程加速抓取及MySQL/MongoDB存储方案,提供完整代码逻辑与优化建议。
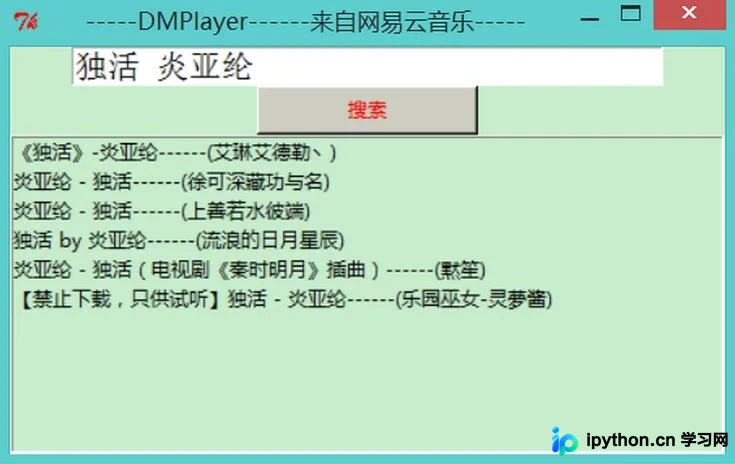
本文介绍了一个使用Python开发的简易在线音乐播放器项目。通过Tkinter构建图形界面,利用requests模块获取网易云音乐接口数据,结合json解析与mp3play库实现歌曲搜索与在线播放功能。
本文详细演示如何使用Python3结合urllib和BeautifulSoup库抓取网页笑话内容。文章从基础HTML结构分析入手,讲解如何定位目标元素,并深入解决因User-Agent被拒导致的RemoteDisconnected错误。通过代码示例,展示了如何配置请求头伪装浏览器,从而成功获取捧腹网和糗百的笑话数据,适合Python初学者参考。
本文详细解析Python爬虫开发中涉及的HTTP请求方法,重点对比GET与POST在参数传递、数据长度及安全性上的核心差异。通过典型请求示例,帮助开发者理解HEAD、PUT、DELETE等方法的适用场景,为构建高效稳定的网络爬虫提供基础理论支持。
本文详解Python爬虫入门必备知识,从爬虫基本概念、互联网抓取逻辑讲起,深入解析浏览网页时的HTML获取过程及URL结构。重点阐述HTTP协议下的请求(Request)与响应(Response)机制,并推荐主流Python开发IDE,帮助初学者快速掌握爬虫基础架构与开发环境搭建。