Python 正则 re.compile 真的必需吗
本文探讨 Python 中 re.compile 的必要性。作者通过实际案例指出,在数据量较小(如上万条)的场景下,直接使用 re.findall 或 re.search 的性能损耗可忽略不计,过度优化反而增加代码复杂度。只有面对百万级以上数据时,预编译正则对象才具有显著性能优势。文章强调应根据业务量级合理选择策略,而非盲目追求代码规范。
2026-10-16
6

本文探讨 Python 中 re.compile 的必要性。作者通过实际案例指出,在数据量较小(如上万条)的场景下,直接使用 re.findall 或 re.search 的性能损耗可忽略不计,过度优化反而增加代码复杂度。只有面对百万级以上数据时,预编译正则对象才具有显著性能优势。文章强调应根据业务量级合理选择策略,而非盲目追求代码规范。
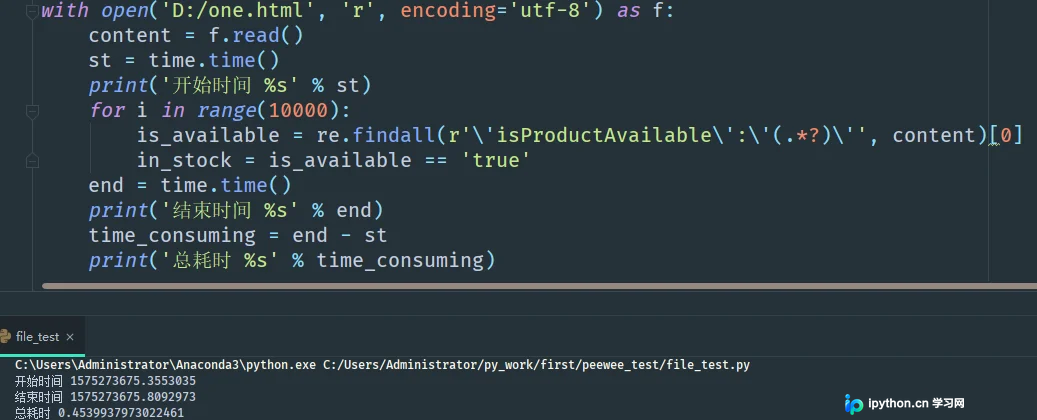
本文详解如何使用Python结合requests、lxml、threading和queue模块,高效爬取中介网网站排行榜。通过多线程生产者-消费者模型,自动解析总页码并批量抓取域名详情页数据,提供完整的逻辑梳理与代码实现参考。
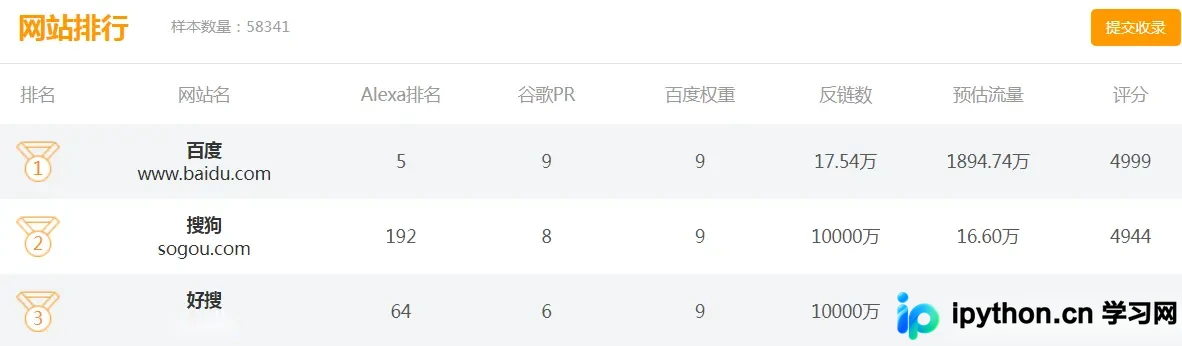
本文详细讲解如何使用Python爬虫获取基金基本信息。针对XPath定位失效的情况,文章演示了如何利用BeautifulSoup库解析HTML页面,通过定位table和td标签提取基金公司、经理、成立时间等关键数据,并展示最终代码实现与结果输出。
本文分享使用Python异步库aiohttp爬取知乎热榜的完整流程。针对直接解析DOM无法获取摘要和详细链接的问题,通过审查JS代码定位数据源,利用正则表达式提取JSON数据并解析,最终实现标题、热度、摘要、链接及图片的高效抓取。
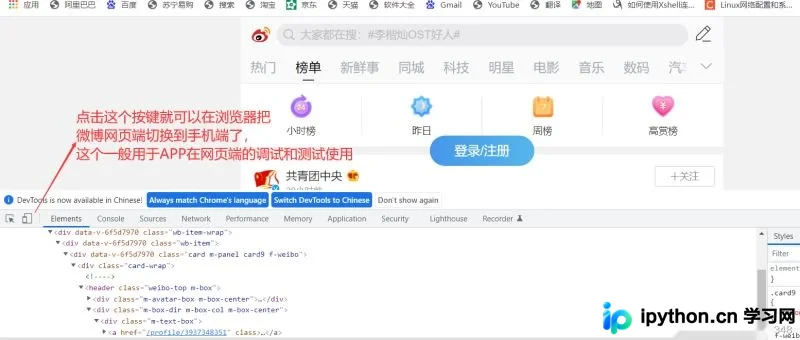
本文详解如何利用Python爬取微博移动端动态图片。针对PC端反爬限制,通过解析m.weibo.cn接口获取用户UID及动态列表,提取图片ID后拼接完整链接进行下载。文中包含参数转码、UID获取及循环下载的具体代码实现与步骤说明。
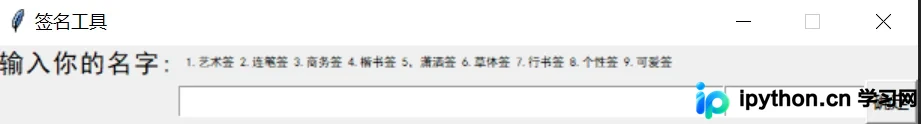
本文介绍如何使用Python结合Tkinter库与网络爬虫技术,开发一个在线个性签名生成工具。通过模拟HTTP请求获取签名网站接口数据,解析返回的图片链接,并在GUI界面中展示及保存生成的签名图片,实现从用户输入到结果展示的完整流程。
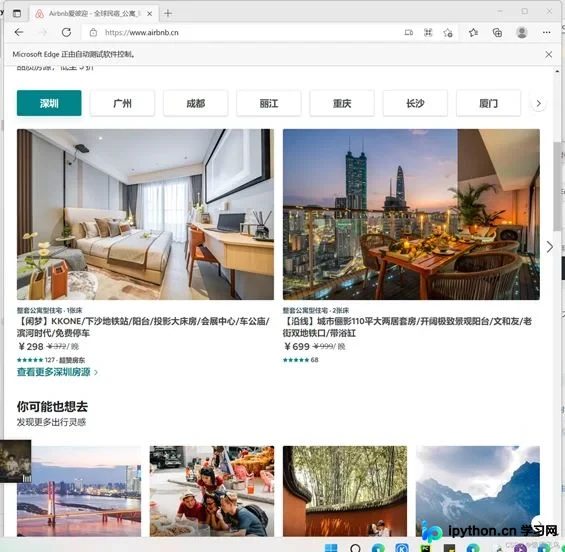
本文介绍如何利用Python Selenium获取并复用Cookie,实现Airbnb网站的免密登录。通过手动登录后保存Cookie文件,后续请求直接加载Cookie,无需重复输入账号密码,有效提升爬虫效率。
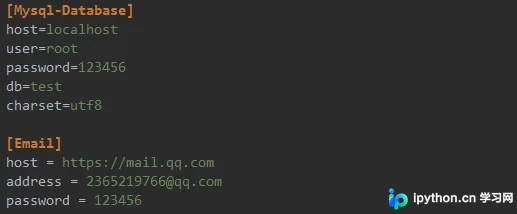
本文介绍如何利用Python内置的ConfigParser模块读取ini格式配置文件,并通过二次封装实现灵活配置管理。通过对比绝对路径与相对路径读取方式,演示了如何将数据库连接信息、爬虫参数等配置抽离至独立文件。文章提供了完整的类封装代码,涵盖读取配置、连接MySQL及执行SQL操作,帮助开发者提升项目配置的灵活性与可维护性。
本文详细介绍Python中Selenium库的安装与ChromeDriver配置,演示无头模式、页面截图、元素定位及交互操作。涵盖多窗口切换、Cookie管理、代理设置及滑块验证码处理,并分析其优缺点,帮助开发者高效构建自动化测试与数据采集工具。
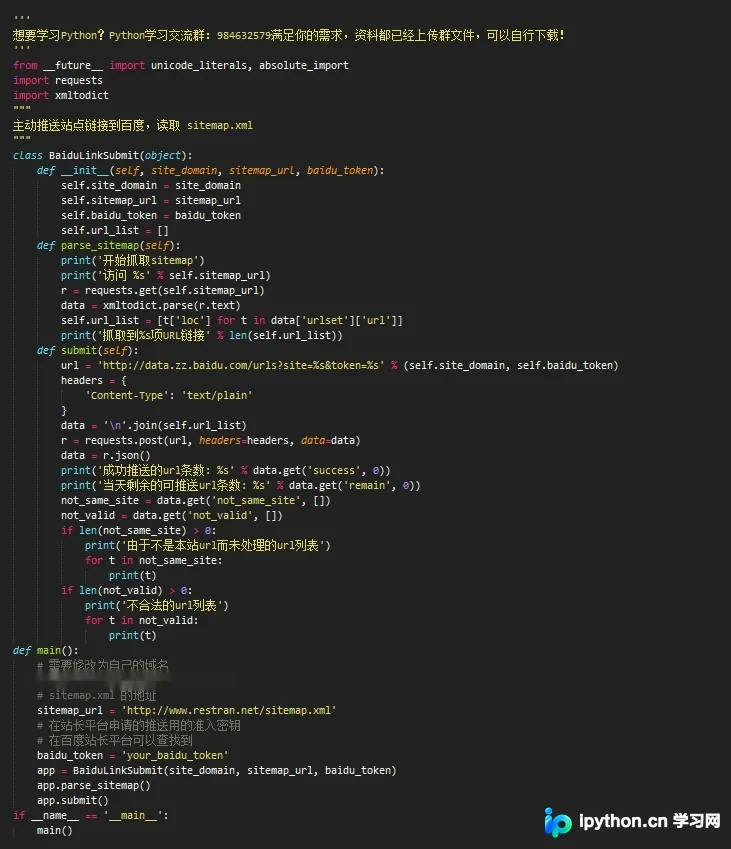
本文介绍如何使用Python脚本实现百度站长平台的主动推送功能,以加速新链接收录。通过抓取指定页面文章链接并调用百度API接口,可批量提交URL。文中提供了基于Python3的完整代码示例,涵盖链接获取、请求构造及状态判断,适用于希望提升搜索引擎收录速度的网站管理员。
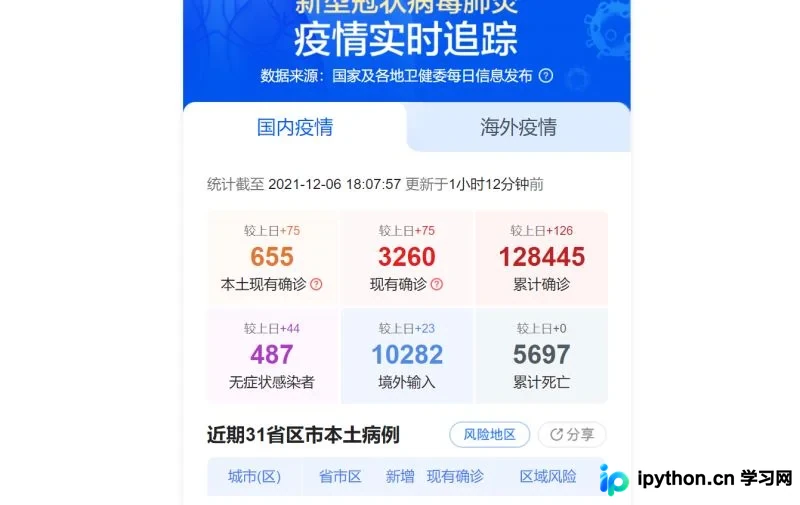
本文详细介绍如何使用Python进行疫情数据爬取与可视化。通过requests获取腾讯接口数据,利用pandas清洗保存,最后使用pyecharts绘制死亡率、治愈率及各地区确诊分布图表,完整展示从数据获取到可视化展示的全流程。
本文详细介绍在Windows系统中利用Python脚本结合Selenium库实现自动化数据采集与更新的方法。内容涵盖通过psutil监控Chrome进程状态、处理长时间未生成数据的异常退出机制,以及利用Windows计划任务实现脚本的周期性自动执行。此外,还包含基于日志的企业微信错误报警集成方案,确保自动化流程的稳定运行。