

Python实现微博移动端动态图片爬取实战

本文详解如何利用Python爬取微博移动端动态图片。针对PC端反爬限制,通过解析m.weibo.cn接口获取用户UID及动态列表,提取图片ID后拼接完整链接进行下载。文中包含参数转码、UID获取及循环下载的具体代码实现与步骤说明。
微博移动端爬虫策略概述
鉴于微博网页版存在严格的反爬虫机制且强制要求登录验证,我们调整策略,转向移动端接口进行数据抓取。
关键在于定位微博在浏览器环境下用于移动端调试的API接口,具体查找方法如下。
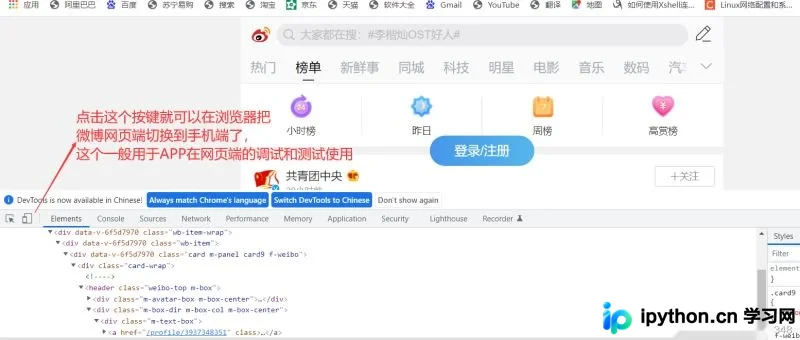
直接访问微博移动端地址:https://m.weibo.cn/。
搜索用户与参数处理
第一步:模拟用户搜索。
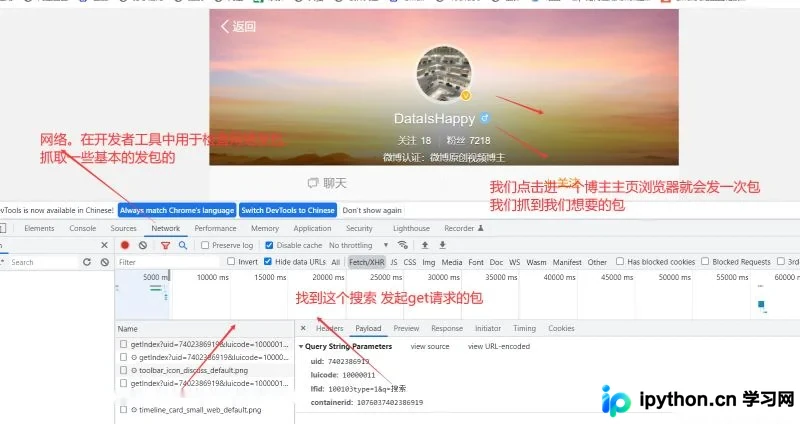
执行搜索操作后,系统返回的API请求示例如下。
https://m.weibo.cn/api/container/getIndex?containerid=100103type=1&q=半半子&page_type=searchall
1.1 处理API参数。
原始参数 containerid=100103type=1&q=半半子 需转换为 containerid=100103type%3D1%26q%3D%E5%8D%8A%E5%8D%8A%E5%AD%90_。
该参数必须预先进行URL编码,否则无法成功获取数据。
1.2 验证用户名并提取用户UID。
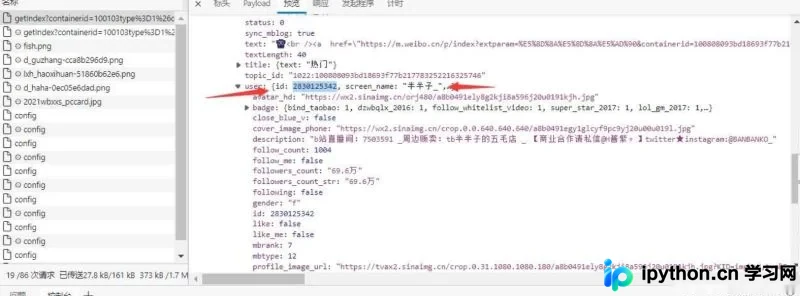
获取用户信息与动态列表
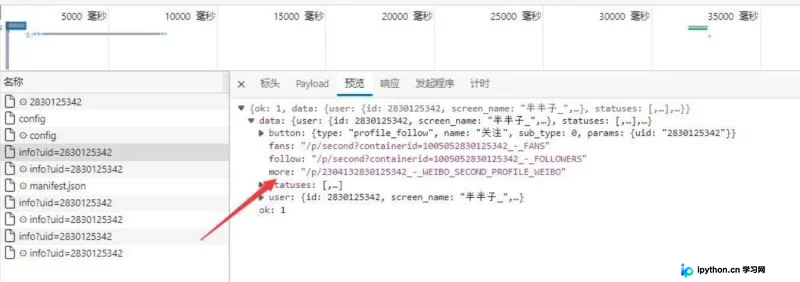
第二步:获取more参数。
使用GET请求方法。
API接口地址:https://m.weibo.cn/profile/info?uid=2830125342。
2.1 提取并处理more参数。
第三步:循环提取图片ID。
使用GET请求方法。
API接口地址:https://m.weibo.cn/api/container/getIndex?containerid=2304132830125342_-_WEIBO_SECOND_PROFILE_WEIBO&page_type=03&page=1。
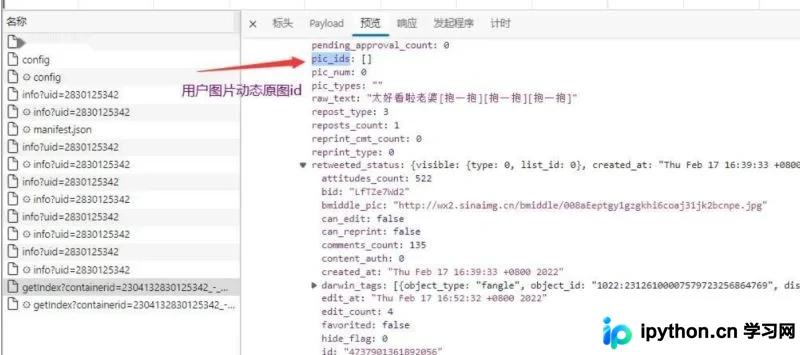
3.1 从响应中提取图片ID,即pic_id。
3.2 获取发布图片的用户信息。
3.3 根据动态创建时间生成用户的唯一识别码。
图片链接提取与下载实现
第四步:下载图片。
通过浏览器抓包工具,可以获取后台服务器返回给浏览器的图片链接地址。
示例链接格式:https://wx2.sinaimg.cn/large/pic_id.jpg。
在浏览器中直接打开该链接即可预览或下载图片。
完整的爬取代码实现如下。
import os
import sys
import time
from urllib.parse import quote

import requests

headers = {
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/95.0.4638.69 Safari/537.36'
}


def time_to_str(c_at):
    ti = time.strptime(c_at, '%a %b %d %H:%M:%S +0800 %Y')
    time_str = time.strftime('%Y%m%d%H%M%S', ti)
    return time_str


# 1. 搜索用户,获取uid
# 2. 通过uid获取空间动态关键参数
# 3. 获取动态内容
# 4. 提取图片参数
# 5. 下载图片

# 1. 搜索用户,获取uid
# ========= 用户名 =========
# 输入不同的用户名可切换下载的用户图片
# 用户名需要完全匹配
name = '半半子_'
# =========================

con_id = f'100103type=1&q={name}'
# 这个条件需要转码
con_id = quote(con_id, 'utf-8')
user_url = f'https://m.weibo.cn/api/container/getIndex?containerid={con_id}&page_type=searchall'
user_json = requests.get(url=user_url, headers=headers).json()
user_cards = user_json['data']['cards']
for card_num in range(len(user_cards)):
    if 'mblog' in user_cards[card_num]:
        if user_cards[card_num]['mblog']['user']['screen_name'] == name:
            print(f'正在获取{name}的空间')
            # 2. 通过uid获取空间动态关键参数
            user_id = user_cards[card_num]['mblog']['user']['id']
            info_url = f'https://m.weibo.cn/profile/info?uid={user_id}'
            info_json = requests.get(url=info_url, headers=headers).json()
            more_card = info_json['data']['more'].split("/")[-1]
            break
file_name = 'weibo'
if not os.path.exists(file_name):
    os.mkdir(file_name)

if len(more_card) == 0:
    sys.exit()
page_type = '03'
page = 0
while True:
    # 3. 获取动态内容
    page += 1
    url = f'https://m.weibo.cn/api/container/getIndex?containerid={more_card}&page_type={page_type}&page={page}'
    param = requests.get(url=url, headers=headers).json()
    cards = param['data']['cards']
    print(f'第 {page} 页')
    for i in range(len(cards)):
        card = cards[i]
        if card['card_type'] != 9:
            continue
        mb_log = card['mblog']
        # 4. 提取图片参数
        # 获取本人的图片
        pic_ids = mb_log['pic_ids']
        user_name = mb_log['user']['screen_name']
        created_at = mb_log['created_at']
        if len(pic_ids) == 0:
            # 获取转发的图片
            if 'retweeted_status' not in mb_log:
                continue
            if 'pic_ids' not in mb_log['retweeted_status']:
                continue
            pic_ids = mb_log['retweeted_status']['pic_ids']
            user_name = mb_log['retweeted_status']['user']['screen_name']
            created_at = mb_log['retweeted_status']['created_at']
        time_name = time_to_str(created_at)
        pic_num = 1
        print(f'======== {user_name} ========')
        # 5. 下载图片
        for pic_id in pic_ids:
            pic_url = f'https://wx2.sinaimg.cn/large/{pic_id}.jpg'
            pic_data = requests.get(pic_url, headers)
            # 文件名 用户名_日期(年月日时分秒)_编号.jpg
            # 例:半半子__20220212120146_1.jpg
            with open(f'{file_name}/{user_name}_{time_name}_{pic_num}.jpg', mode='wb') as f:
                f.write(pic_data.content)
                print(f'    正在下载:{pic_id}.jpg')
            pic_num += 1
        time.sleep(2)
至此,关于Python实现微博动态图片爬取的详细教程介绍完毕。如需了解更多Python微博图片爬取相关内容,请查阅本站历史文章或继续浏览后续教程,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









