Python实现单词翻译功能
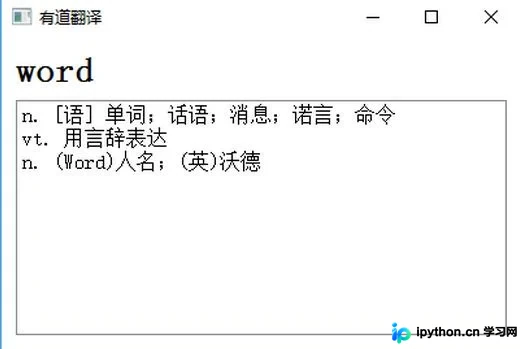
本文介绍了一款基于Python开发的Windows单词监控翻译工具。该程序利用Qt监听系统剪切板变化,自动识别英文单词并调用有道翻译接口获取释义,最终通过Qt界面展示结果。解决了传统PDF阅读器翻译与注释功能冲突的问题,提升英文文献阅读效率。
2026-10-13
6

本文介绍了一款基于Python开发的Windows单词监控翻译工具。该程序利用Qt监听系统剪切板变化,自动识别英文单词并调用有道翻译接口获取释义,最终通过Qt界面展示结果。解决了传统PDF阅读器翻译与注释功能冲突的问题,提升英文文献阅读效率。
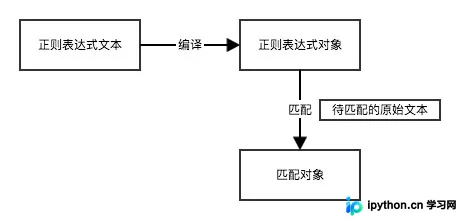
本文深入解析Python中正则表达式的核心概念,涵盖原始字符串定义、基础与预设元字符、边界与重复匹配、分组及贪婪与非贪婪模式。结合爬虫场景,详细演示如何利用re模块提取邮箱、处理相对路径及批量替换,助力开发者高效进行文本处理与数据抓取。
本文深入讲解Python中BeautifulSoup库的使用,涵盖从安装到高级应用的全流程。内容详解HTML树形结构、Tag与NavigableString数据类型,并通过遍历文档树与搜索文档树(find/find_all)两种核心方法,演示如何高效定位和提取HTML中的目标数据,结合代码示例帮助开发者快速掌握网页数据抓取技巧。
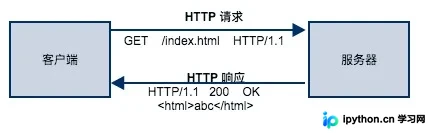
本文详解HTTP协议在Python爬虫中的核心作用,剖析HTTP请求(请求行、首部、体)与响应(状态码、首部、体)的标准格式,并通过Socket模块模拟真实通信过程,帮助开发者掌握爬虫底层原理。
本文详细介绍如何使用Python的urllib、urllib2及re模块实现网页信息抓取。通过解析百度贴吧示例,演示如何构建请求、处理多页URL、利用正则表达式提取标题与正文,并包含文件读写及异常处理的完整代码实现,适合Python初学者参考。
本文介绍使用Python正则表达式抓取网易新闻评论的方法。通过抓包工具定位隐藏评论接口,利用urllib2发起请求并获取HTML数据,再经正则处理提取JSON中的评论字段。代码包含分页处理、异常捕获及文件写入逻辑,适合Python初学者参考正则在爬虫中的应用。
本文详细记录了使用Python和WordPress搭建小说站点的完整过程。内容涵盖WordPress主题选择、利用Python进行定向数据采集与MongoDB存储、通过wordpress_xmlrpc及MySQL直接插入实现内容更新,以及基于Flask部署微信公众平台接口。旨在为技术爱好者提供从后端数据抓取到前端展示及微信互动的实战参考方案。
本文详细介绍Python中利用urllib库进行网页抓取的核心方法。涵盖通过urlopen直接保存页面、构建Request对象实现POST与GET请求,以及利用geturl和info处理重定向与元数据。重点解析中文内容的encode与decode编码解码技巧,帮助开发者快速掌握基础爬虫技能。
本文系统讲解Python函数的基础知识,涵盖内置函数库(字符串、数学、网络、OS)的使用方法,详细演示httplib2第三方库在Windows下的安装步骤及网页爬虫示例,并深入解析自定义函数的定义、返回值处理及参数预设规则,帮助初学者掌握Python编程核心技能。
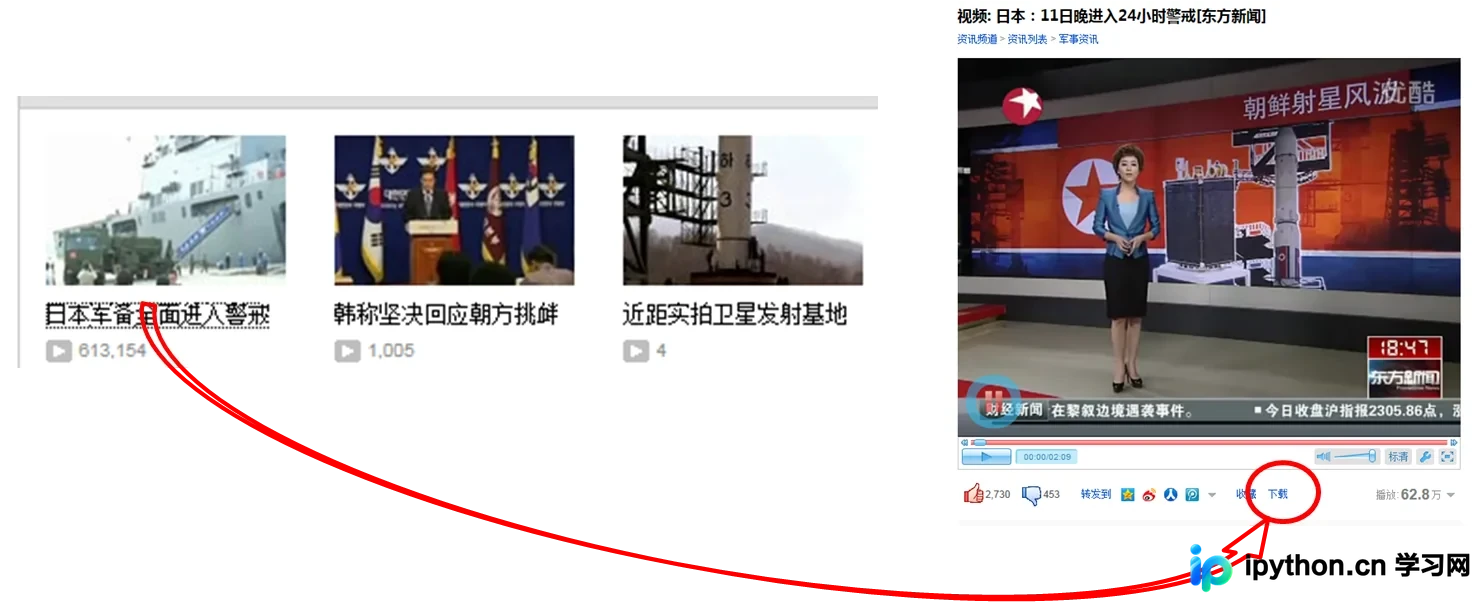
本文介绍使用Python 2.7结合BeautifulSoup3.2.1实现优酷视频批量下载的方法。通过解析网页数据获取播放链接,利用Python的os.system调用iku命令行工具完成下载。文章详细说明了程序逻辑、环境配置及注意事项,旨在提供一种实用且高效的视频数据采集方案。
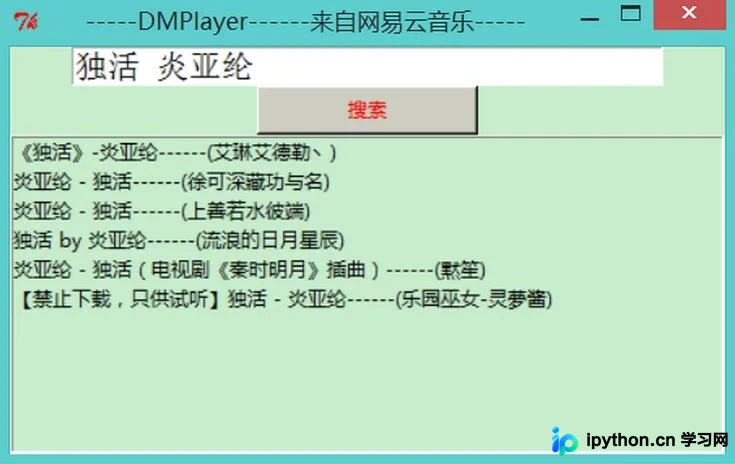
本文介绍了一个使用Python开发的简易在线音乐播放器项目。通过Tkinter构建图形界面,利用requests模块获取网易云音乐接口数据,结合json解析与mp3play库实现歌曲搜索与在线播放功能。
本文介绍一个使用Python编写的宝宝起名程序,通过爬虫自动提交表单获取指定网站的八字与五格评分。支持自定义家谱限定字、扩充词库,并批量生成带评分的名字列表。程序基于urllib2和BeautifulSoup4实现,提供配置示例与运行结果,旨在为家长提供一份结合传统命理与个性化限制的参考名单。