

Python实现百度指数数据抓取、保存与可视化教程

本文介绍如何使用Python脚本获取百度指数数据。通过提取登录Cookie,利用自定义类解析API返回的加密数据,生成Pandas DataFrame。文章包含获取Cookie的步骤、核心代码示例、数据保存为CSV的方法,以及使用Plotly进行时间序列可视化的完整流程,帮助开发者便捷地获取并分析关键词热度趋势。
前言
在数据分析场景中,了解特定关键词在互联网上的热度及其变化趋势至关重要。百度指数和微信指数是常用的工具,但它们通常不提供直接的数据下载功能,这给后续的数据处理和分析带来了不便。
笔者在参考他人提供的Python爬虫脚本基础上进行了修改,封装了一个可直接返回Pandas DataFrame数据框的类,并补充了简单的可视化代码。本文旨在分享这一解决方案,帮助用户能够轻松下载并保存百度指数数据,以便进行后续操作。
具体步骤
1. 获取Cookie值
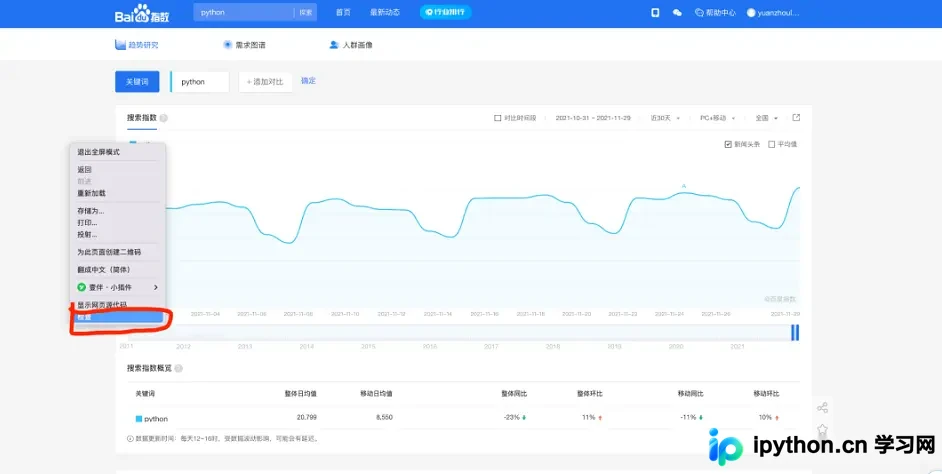
百度指数需要用户登录并进行身份验证。因此,首先需要登录百度指数网站,随便搜索一个关键词(例如“python”)。接着,在网页空白处右键点击选择“检查”,进入开发者工具的“网络”(Network)面板。
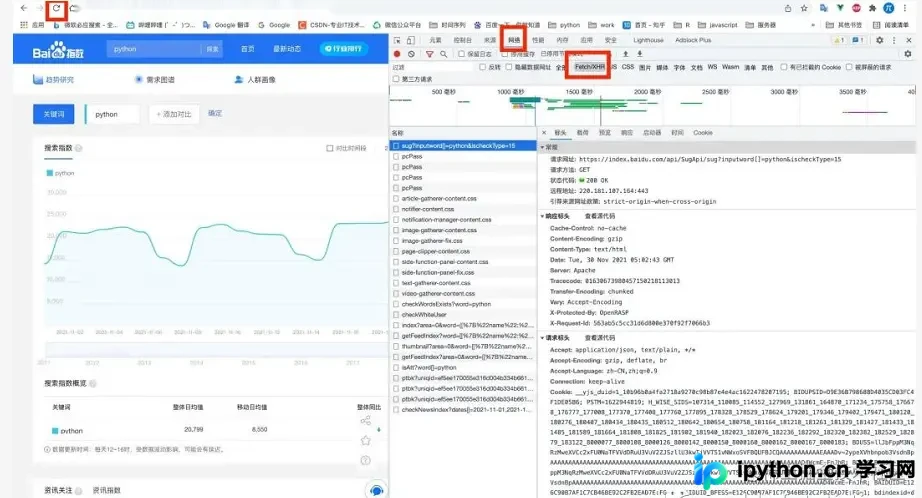
此时“网络”面板可能显示为空,需要刷新网页以加载所有请求。由于请求较多,请注意筛选并选择“Fetch/XHR”类别,以便查看JSON数据请求。
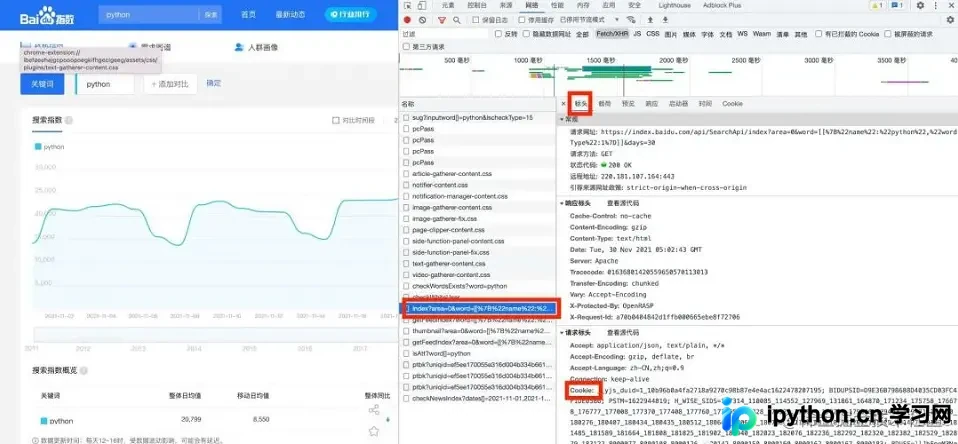
在请求列表中找到以index?开头的文件,查看其“标头”(Headers)信息,并复制其中的“Cookie”值。将该Cookie值保存下来,用于后续的API请求验证。
2. 使用提供的代码
以下是基础代码,用户只需复制并配置好Cookie即可使用:
import requests
import json
from datetime import date, timedelta
import pandas as pd
class DownloadBaiDuIndex(object):
    def __init__(self, cookie):
        self.cookie = cookie
        self.headers = {
            "Connection": "keep-alive",
            "Accept": "application/json, text/plain, */*",
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.198 Safari/537.36",
            "Sec-Fetch-Site": "same-origin",
            "Sec-Fetch-Mode": "cors",
            "Sec-Fetch-Dest": "empty",
            "Referer": "https://index.baidu.com/v2/main/index.html",
            "Accept-Language": "zh-CN,zh;q=0.9",
            'Cookie': self.cookie,
        }

    def decrypt(self, ptbk, index_data):
        n = len(ptbk) // 2
        a = dict(zip(ptbk[:n], ptbk[n:]))
        return "".join([a[s] for s in index_data])

    def get_index_data_json(self, keys, start=None, end=None):
        words = [[{"name": key, "wordType": 1}] for key in keys]
        words = str(words).replace(" ", "").replace("'", """)

        url = f'http://index.baidu.com/api/SearchApi/index?area=0&word={words}&area=0&startDate={start}&endDate={end}'
        print(words, start, end)
        res = requests.get(url, headers=self.headers)
        data = res.json()['data']
        uniqid = data['uniqid']
        url = f'http://index.baidu.com/Interface/ptbk?uniqid={uniqid}'
        res = requests.get(url, headers=self.headers)
        ptbk = res.json()['data']
        result = {}
        result["startDate"] = start
        result["endDate"] = end
        for userIndexe in data['userIndexes']:
            name = userIndexe['word'][0]['name']
            tmp = {}
            index_all = userIndexe['all']['data']
            index_all_data = [int(e) for e in self.decrypt(ptbk, index_all).split(",")]
            tmp["all"] = index_all_data
            index_pc = userIndexe['pc']['data']
            index_pc_data = [int(e) for e in self.decrypt(ptbk, index_pc).split(",")]
            tmp["pc"] = index_pc_data
            index_wise = userIndexe['wise']['data']
            index_wise_data = [int(e)
                               for e in self.decrypt(ptbk, index_wise).split(",")]
            tmp["wise"] = index_wise_data
            result[name] = tmp
        return result

    def GetIndex(self, keys, start=None, end=None):
        today = date.today()
        if start is None:
            start = str(today - timedelta(days=8))
        if end is None:
            end = str(today - timedelta(days=2))

        try:
            raw_data = self.get_index_data_json(keys=keys, start=start, end=end)
            raw_data = pd.DataFrame(raw_data[keys[0]])
            raw_data.index = pd.date_range(start=start, end=end)

        except Exception as e:
            print(e)
            raw_data = pd.DataFrame({'all': [], 'pc': [], 'wise': []})

        finally:
            return raw_data
使用上述封装的类:
调用该类时,先进行初始化,然后使用对象的GetIndex函数。该函数的参数keys用于传递关键词,必须以列表形式传入。
简单来说,只需将示例中的“python”替换为目标关键词,时间参数也需以文本形式提供,格式为'yyyy-mm-dd'。
cookie = '你的cookie值,注意使用英文单引号;就是直接复制就行了'
# 初始化一个类
downloadbaiduindex = DownloadBaiDuIndex(cookie=cookie)
data = downloadbaiduindex.GetIndex(keys=['python'], start='2021-01-01', end='2021-11-12')
data
保存数据
若需将获取的数据保存为文件,可直接执行以下代码:
data.to_csv('data.csv')可视化
获取数据后,可视化处理相对简单。即使使用其他语言处理数据也可实现,这里演示如何使用Python绘制时间序列图:
import plotly.graph_objects as go
import pandas as pd
df = data
fig = go.Figure([go.Scatter(x=df.index, y=df['all'], fill='tozeroy')])
fig.update_layout(template='plotly_white', title='python 百度指数')
fig.show()
fig.write_html('python.html')
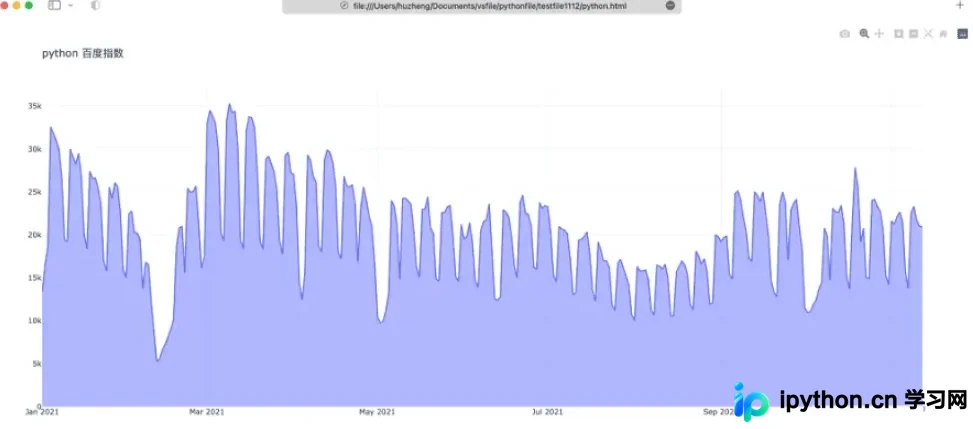
运行结果如下所示:
总结
整个过程并无复杂难点,只要确保Cookie复制准确且参数设置无误即可成功获取数据。
至此,关于Python百度指数获取、下载并保存的教程介绍完毕。更多相关Python脚本内容,欢迎搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









