Python实现简易天气查询软件:从爬虫到UI界面完整教程
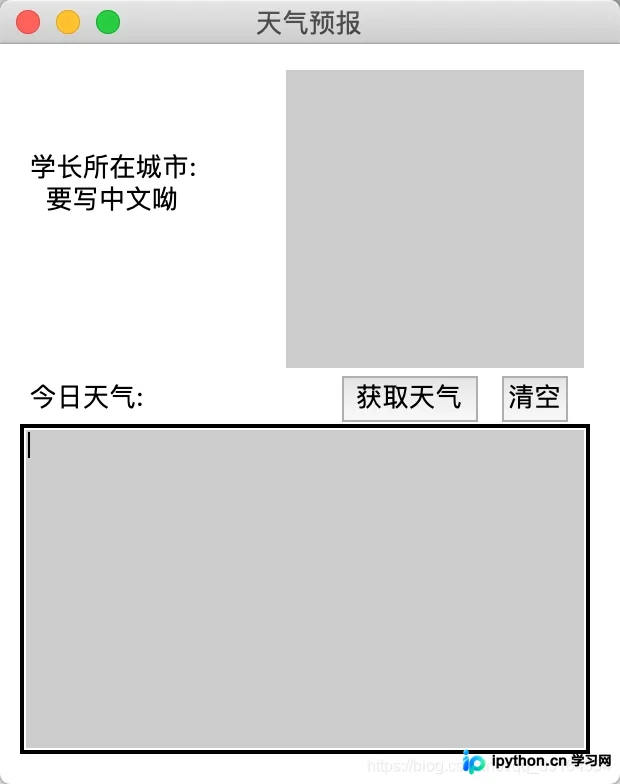
本文详细介绍如何使用Python实现一个简易的天气查询软件。通过requests库进行网页数据爬取,利用正则表达式解析天气信息,并结合tkinter库构建图形用户界面。文章涵盖从背景介绍、工具选择、代码解读到完整代码展示的全过程,帮助读者掌握Python在网络爬虫与GUI开发方面的实际应用。
2026-10-15
7

本文详细介绍如何使用Python实现一个简易的天气查询软件。通过requests库进行网页数据爬取,利用正则表达式解析天气信息,并结合tkinter库构建图形用户界面。文章涵盖从背景介绍、工具选择、代码解读到完整代码展示的全过程,帮助读者掌握Python在网络爬虫与GUI开发方面的实际应用。
本文介绍使用 PHP 通过 file_get_contents 抓取在线成语词典接口的实现方法。重点解决请求参数需进行特殊 Escape 编码、目标返回内容为 UTF-8 但需转换为 GB2312 显示,以及利用 iconv 的 //IGNORE 参数防止因特殊字符导致的解析中断等核心技术与代码逻辑。
本文详细介绍如何使用 Python 爬取吉首大学(JSU)的成绩单数据。教程涵盖环境配置(Python 3.5+、requests、BeautifulSoup4等)、通过浏览器开发者工具获取 Cookie 的方法,以及修改爬虫 URL 和运行 main.py 生成 CSV 文件的完整步骤。附带完整源码解析,帮助开发者快速掌握教务系统数据抓取技巧。

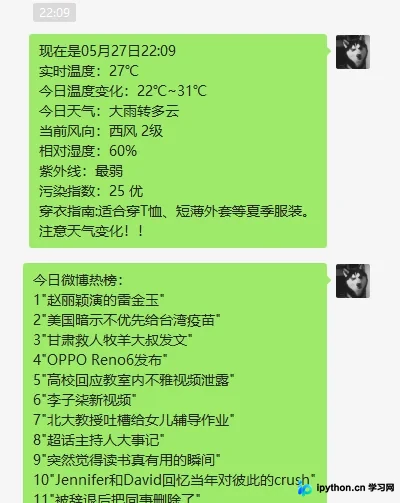
本文介绍如何使用Python结合Selenium和Requests库,动态渲染并爬取中国天气网实时数据及微博热搜榜。通过win32gui模拟键鼠操作,实现指定时间自动向微信好友发送天气详情与热榜信息,并支持打包为exe文件运行。
本文详细演示如何利用Python逆向分析APP数据。通过Fiddler抓包发现SSL Pinning,使用Xposed和JustTrustme绕过;利用ApkScan查壳、frida-DEXDump脱壳及jadx反编译定位加密逻辑。最终通过Frida Hook获取AES密钥,在Python中复现加解密过程,成功抓取APP接口数据。
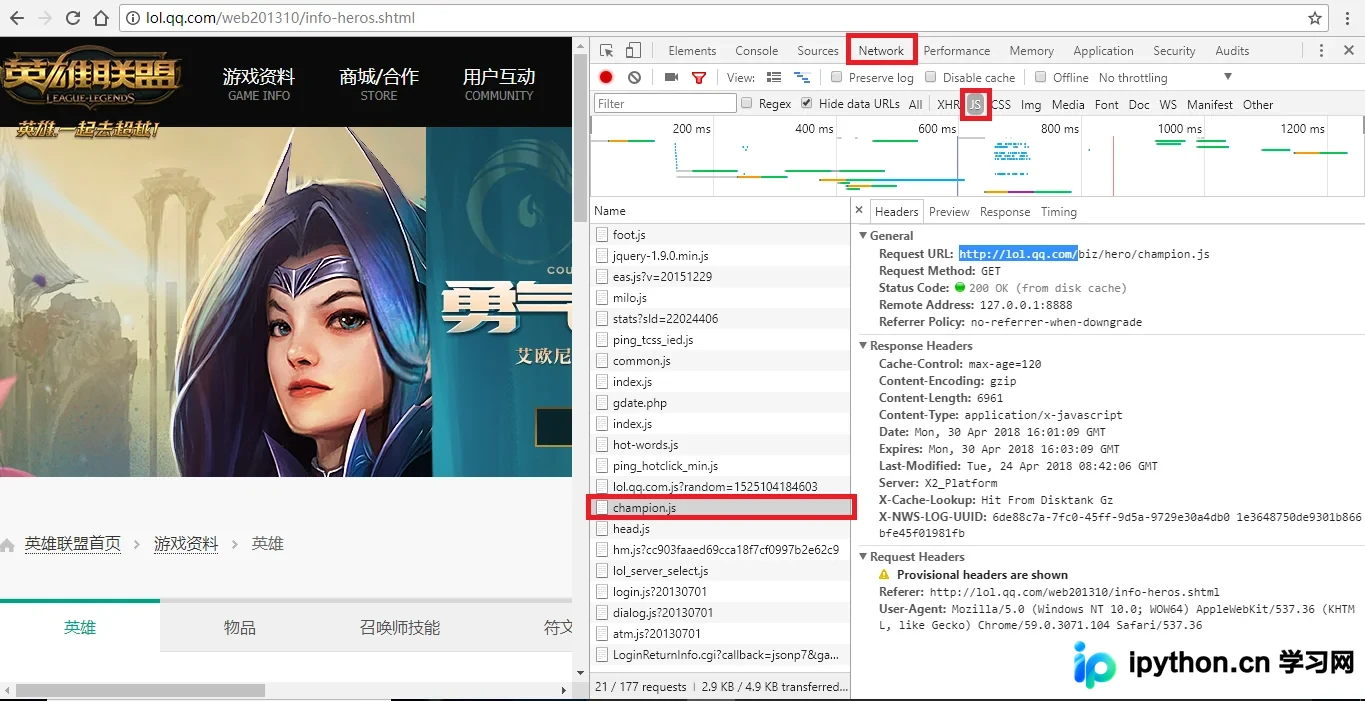
本文详细介绍如何使用 Python 爬取《英雄联盟》官网的英雄及皮肤图片。通过解析 champion.js 文件获取英雄编号,结合皮肤序号生成图片 URL,并编写脚本批量下载保存。教程涵盖从分析网页结构、提取关键数据到实现自动化下载的全过程,适合 Python 初学者参考。
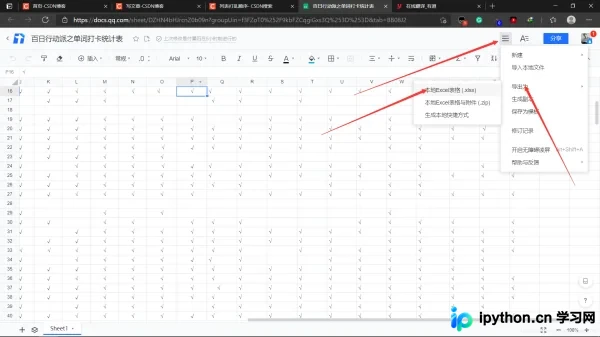
本文介绍如何使用Python结合Pandas库,自动化处理QQ群相册中的单词打卡数据。通过手动复制相册内容至文本文件,利用正则表达式提取用户昵称,并自动在Excel打卡表中标记“√”。文章详细讲解了文件路径配置、日期格式转换及代码运行步骤,旨在解决因QQ安全机制导致无法直接爬虫获取数据的痛点,提供一套高效的人工辅助+代码自动化的解决方案。
本文深入解析Python requests库中timeout参数的两种设置方式:单一值与元组形式。重点指出连接超时默认21秒而读取超时无默认值易导致程序永久挂起的风险,并提供针对高并发场景的超时配置建议及常见卡死问题的解决方案。
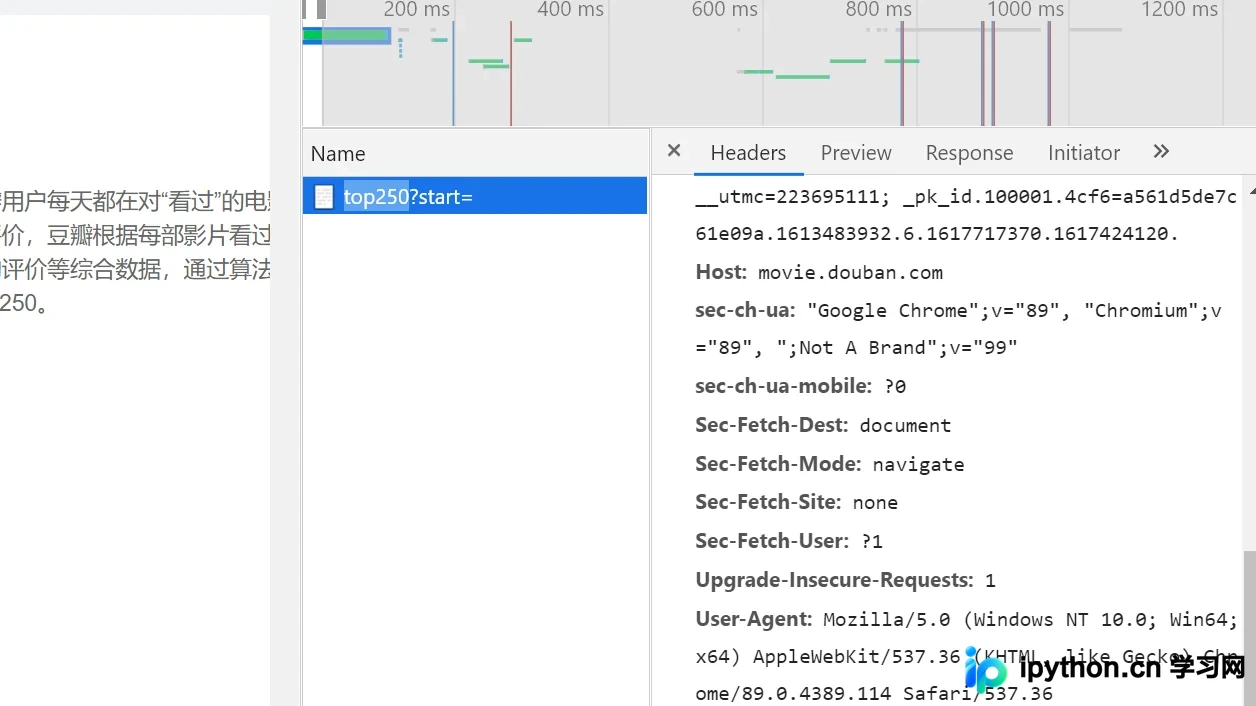
本文详细介绍如何使用Python爬取豆瓣电影Top250数据。通过urllib.request获取HTML源码,利用BeautifulSoup和正则表达式解析电影名称、评分及链接,最后使用xlwt库将结果保存为Excel文件。教程涵盖反爬处理、分页逻辑及数据清洗,适合Python初学者学习网络爬虫基础。
本文详细介绍Python调用JavaScript代码的四种常用方式。通过PyExecJS利用本地JS环境执行,js2py实现纯Python解释器转换,Node.js命令直接调用,以及PyV8封装Chrome V8引擎。文章对比了各方案的优缺点及适用场景,适用于Web爬虫参数加密逆向等实际需求。
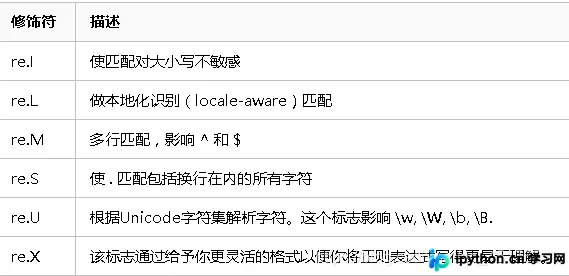
本文系统梳理Python中re模块的核心功能,涵盖compile、match、search、findall、sub及split等关键方法的使用场景与参数差异。通过具体代码示例,演示如何结合大小写忽略、分组匹配及命名组等技巧,高效完成文本检索、替换与结构化数据提取任务,适用于爬虫开发与日常字符串处理。
本文详细介绍如何使用Python爬虫应对网站反爬机制。针对蚂蚁短租的访问拦截,通过浏览器开发者工具获取Cookie和User-Agent,并在Python代码中通过urllib2设置Headers提交请求。结合BeautifulSoup解析HTML节点,成功获取贵阳地区短租房的名称、价格、评分及链接等详细信息,并存储为CSV文件。