

Python 爬取英雄联盟皮肤图片实战教程

本文详细介绍如何使用 Python 爬取《英雄联盟》官网的英雄及皮肤图片。通过解析 champion.js 文件获取英雄编号,结合皮肤序号生成图片 URL,并编写脚本批量下载保存。教程涵盖从分析网页结构、提取关键数据到实现自动化下载的全过程,适合 Python 初学者参考。
首先,访问《英雄联盟》官方网站以获取英雄及其皮肤图片的链接地址:
URL = r'https://lol.qq.com/data/info-heros.shtml'
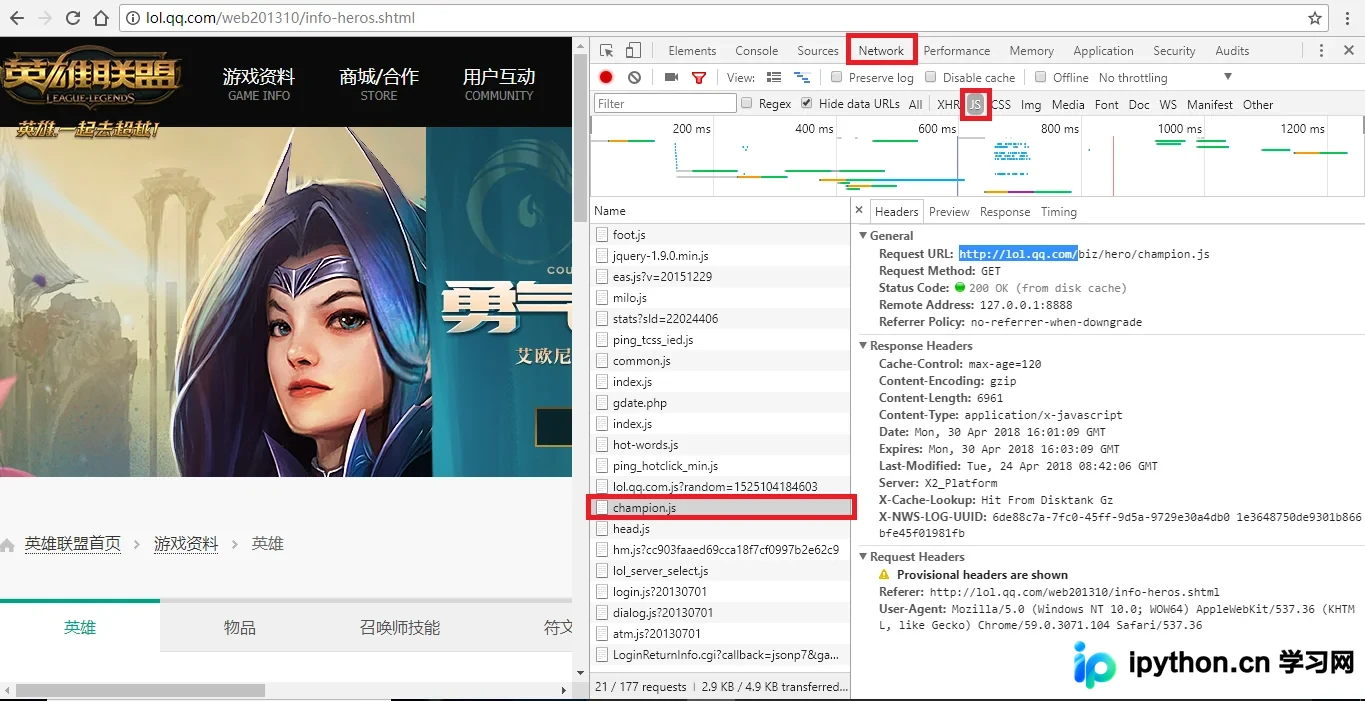
观察上述网址,可以发现其中列出了所有英雄信息。按下 F12 键查看网页源代码,会发现英雄及皮肤的图片链接并未直接嵌入在 HTML 中,而是被封装在 JavaScript 文件里。此时,需要打开浏览器的开发者工具,切换到 Network(网络)标签页,刷新页面后,在请求列表中找到名为 champion.js 的文件。点击该文件,可以看到返回的数据是一个字典结构,其中包含了所有英雄的英文名称及其对应的数字编号(参考下图)。
然而,仅拥有英雄英文名称和编号还不足以直接定位图片地址。因此,我们需要回到网页界面,随机点击任意一名英雄进入详情页。在跳转后的页面中,可以看到该英雄及其所有皮肤的图片展示。为了获取图片的原始地址,只需右键点击图片并选择“在新标签页中打开”,新打开的网页地址即为图片的真实源地址(参考下图)。
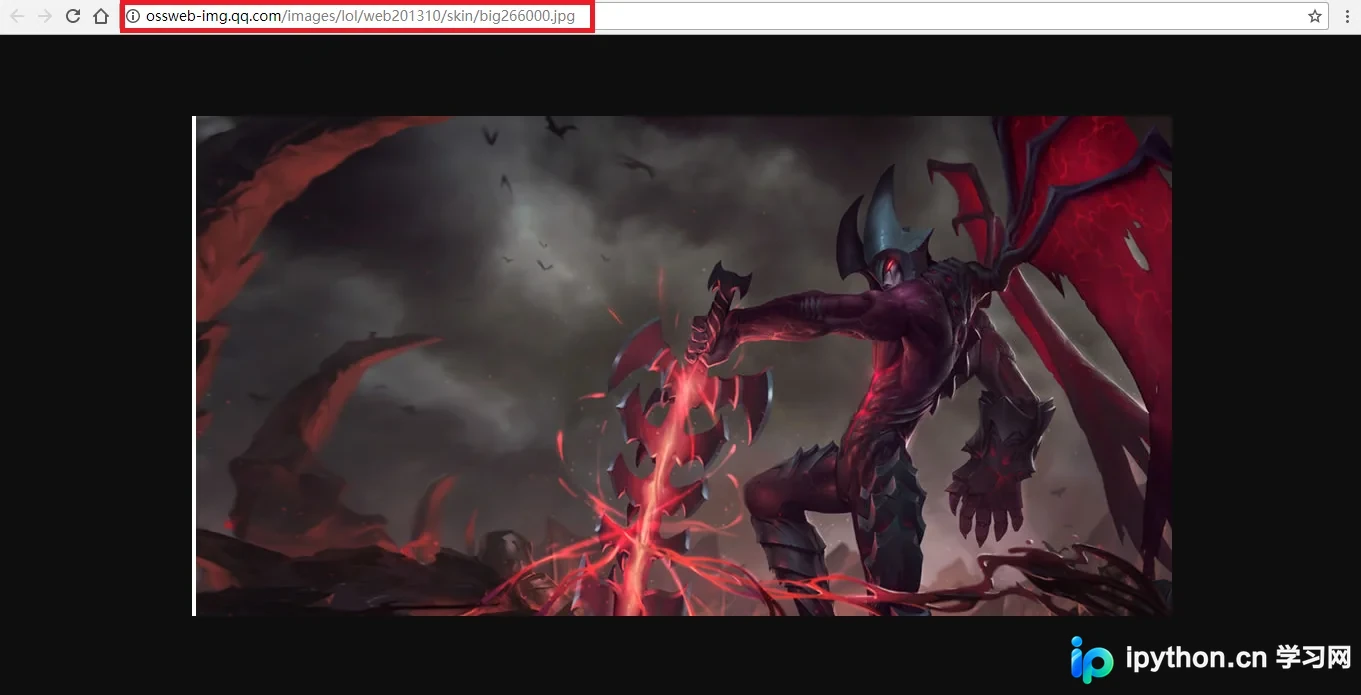
图中红色框选部分即为我们需要的图片地址。经过分析可知,每个英雄及皮肤的 URL 仅编号部分存在差异(例如:http://ossweb-img.qq.com/images/lol/web201310/skin/big266000.jpg)。该编号由 6 位数字组成:前 3 位代表英雄编号,后 3 位代表皮肤序号。此前在 champion.js 文件中已获取到英雄编号,而皮肤序号可以自行定义。鉴于每个英雄的皮肤数量通常不超过 20 个,我们可以将这两部分组合生成完整的图片 URL。
明确了图片地址的生成规则后,即可开始编写 Python 程序:
第一步:获取 JS 文件中的字典数据
def path_js(url_js):
    res_js = requests.get(url_js, verify = False).content
    html_js = res_js.decode("gbk")
    pat_js = r'"keys":(.*?),"data"'
    enc = re.compile(pat_js)
    list_js = enc.findall(html_js)
    dict_js = eval(list_js[0])
    return dict_js
第二步:从 JS 字典中提取 Key 值,生成图片 URL 列表
def path_url(dict_js):
    pic_list = []
    for key in dict_js:
        for i in range(20):
            xuhao = str(i)
            if len(xuhao) == 1:
                num_houxu = "00" + xuhao
            elif len(xuhao) == 2:
                num_houxu = "0" + xuhao
            numStr = key+num_houxu
            url = r'http://ossweb-img.qq.com/images/lol/web201310/skin/big'+numStr+'.jpg'
            pic_list.append(url)
    print(pic_list)
    return pic_list
第三步:从 JS 字典中提取 Value 值,生成英雄名称列表
def name_pic(dict_js, path):
    list_filePath = []
    for name in dict_js.values():
        for i in range(20):
            file_path = path + name + str(i) + '.jpg'
            list_filePath.append(file_path)
    return list_filePath
第四步:执行下载操作并保存数据到本地
def writing(url_list, list_filePath):
    try:
        for i in range(len(url_list)):
            res = requests.get(url_list[i], verify = False).content
            with open(list_filePath[i], "wb") as f:
                f.write(res)

    except Exception as e:
        print("下载图片出错,%s" %(e))
        return False
运行主程序代码:
if __name__ == '__main__':
    url_js = r'http://lol.qq.com/biz/hero/champion.js'
    path = r'./data/'   #图片存在的文件夹
    dict_js = path_js(url_js)
    url_list = path_url(dict_js)
    list_filePath = name_pic(dict_js, path)
    writing(url_list, list_filePath)
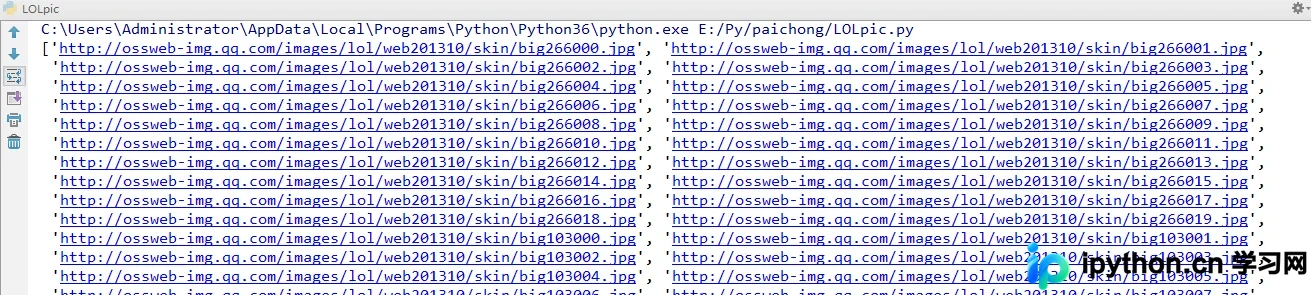
程序运行后,控制台将逐行打印出每张图片的下载地址:
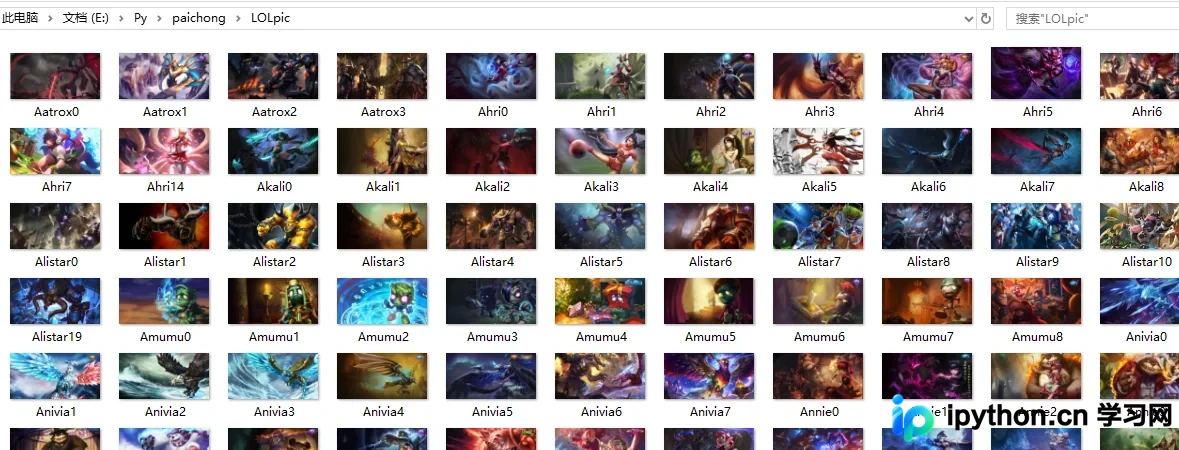
检查本地文件夹,确认图片已成功下载保存:
以上即为本次分享的全部内容。如有不足之处,欢迎指正与交流,感谢阅读!
以上是关于使用 Python 爬取《英雄联盟》皮肤图片的完整教程。如需了解更多 Python 爬虫相关知识,请关注本站其他相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









