

Python re模块核心方法与正则表达式实战指南

本文系统梳理Python中re模块的核心功能,涵盖compile、match、search、findall、sub及split等关键方法的使用场景与参数差异。通过具体代码示例,演示如何结合大小写忽略、分组匹配及命名组等技巧,高效完成文本检索、替换与结构化数据提取任务,适用于爬虫开发与日常字符串处理。
前言
正则表达式是计算机科学中用于处理字符串匹配的重要工具,主要应用于检索和替换符合特定规则的文本内容。它本质上是一种逻辑公式,通过预定义的模式字符串对目标文本进行过滤和逻辑处理。
掌握re模块及正则表达式(regex)对于网络爬虫开发中的数据定位至关重要,是提升数据处理效率的关键技能。
常用方法
- re.compile():将指定的正则表达式模式编译为正则表达式对象,以便在多次匹配和搜索中提高性能。
- re.match():该方法尝试从字符串的起始位置匹配一个模式,若起始位置不匹配则返回None。
- re.search():扫描整个字符串以查找第一个匹配正则表达式模式的位置,返回匹配对象。
- re.findall():返回字符串中所有符合正则表达式模式的非重叠匹配项列表。
- re.finditer():以迭代器形式返回字符串中所有匹配正则表达式的实例,适用于从左到右扫描特定模式。
- re.sub():使用替换字符串替代原字符串中匹配正则表达式的部分,默认仅替换最左侧出现的模式。
重要标识符
正则表达式支持可选的标志修饰符来控制匹配行为,如指定大小写敏感或不敏感等。多个标志可通过按位或(|)运算符组合使用,例如 re.I | re.M 同时启用 I 和 M 标志。
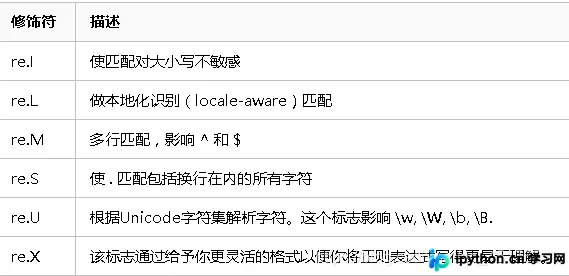
常用表达式规则
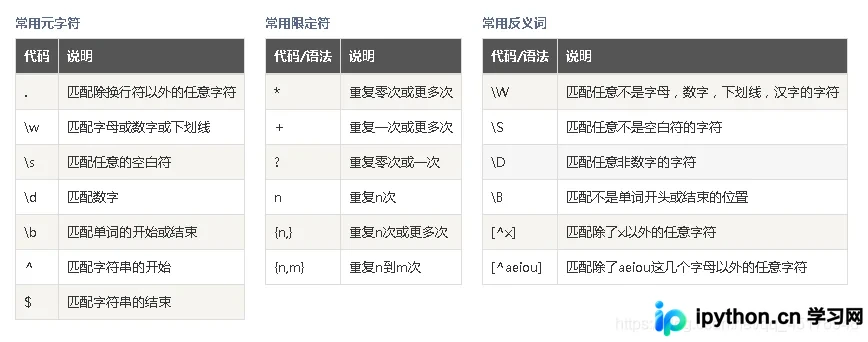
举例说明
以下代码演示了上述方法在字符串处理和正则表达式匹配中的典型用法。
import re
pattern = "python"
s1 = "Python is an excellent language"
s2 = "I love Python language.I also use Python to build applicants at work!"
re.match(pattern, string, flags=0)
该函数从字符串起始位置开始,根据指定模式匹配内容,仅返回第一个匹配结果。
re.match(pattern,s1)
若目标字符串大小写与模式不一致且未设置忽略大小写标志,则匹配将失败。
使用 re.I 或 re.IGNORECASE 标志可以启用不区分大小写的匹配模式。
re.match(pattern,s1,re.I)
<re.Match object; span=(0, 6), match='Python'>
re.match(pattern,s1,re.IGNORECASE)
<re.Match object; span=(0, 6), match='Python'>
re.search(pattern, string, flags=0)
该函数根据指定模式在整个字符串中查找第一个匹配项,返回单个匹配对象。
接下来对比 findall() 和 search() 在正则表达式中的工作差异。
re.search(pattern,s2,re.IGNORECASE)
<re.Match object; span=(7, 13), match='Python'>
re.findall(pattern, string, flags=0)
match 和 search 仅用于匹配单个值,若需获取字符串中所有符合条件的元素,应使用 findall。
re.findall(pattern,s2,re.IGNORECASE)
['Python', 'Python']
re.sub(pattern, repl, string, count=0, flags=0)
该函数用于文本替换,通过正则表达式查找并替换字符串中的特定标识符。
相比 str.replace,它支持正则模式匹配,功能更为强大。
re.sub(pattern,"Java",s2,flags=re.I)
'I love Java language.I also use Java to build applicants at work!'
re.subn(pattern,"Java",s2,flags=re.I)
('I love Java language.I also use Java to build applicants at work!', 2)
re.split(pattern, string, maxsplit=0, flags=0)
该函数将匹配到的值作为分割点,把字符串分割成列表。
s1
'Python is an excellent language'
re.split(" ",s1)
['Python', 'is', 'an', 'excellent', 'language']
按数字分割
print(re.split("\d+","https://blog.csdn.net/qq_45176548"))
'(?P…)' 分组匹配
s = '230701200104280028'
print(re.search('(?P<province>\d{3})(?P<city>\d{3})(?P<born_date>\d{8})(?P<seq>\d{4})',s))
print(re.search('(?P<province>\d{3})(?P<city>\d{3})(?P<born_date>\d{8})(?P<seq>\d{4})',s).groups())
res = re.search('(?P<province>\d{3})(?P<city>\d{3})(?P<born_date>\d{8})(?P<seq>\d{4})',s)
print(res.groupdict())
<re.Match object; span=(0, 18), match='230701200104280028'> ('230', '701', '20010428', '0028') {'province': '230', 'city': '701', 'born_date': '20010428', 'seq': '0028'} ---
总结
本文介绍了Python中re模块的常用方法,更多相关内容可参考本站往期文章或继续浏览后续教程,感谢支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









