Python网络爬虫实战:页面抓取、图片下载与IP查询详解
本文通过五个Python代码实例,详解如何使用requests库进行网络爬虫开发。内容涵盖普通页面爬取、模拟浏览器请求规避限制、搜索引擎关键词抓取、图片保存以及IP地址归属地查询,提供完整代码与参数解析,帮助开发者快速掌握网络数据提取核心技巧。
2026-10-13
6

本文通过五个Python代码实例,详解如何使用requests库进行网络爬虫开发。内容涵盖普通页面爬取、模拟浏览器请求规避限制、搜索引擎关键词抓取、图片保存以及IP地址归属地查询,提供完整代码与参数解析,帮助开发者快速掌握网络数据提取核心技巧。
本文详解Python中urllib模块的自定义Opener构建原理。通过HTTPHandler、ProxyHandler及HTTPCookieProcessor处理器,实现代理IP切换与Cookie持久化。涵盖Debug调试、免费与私密代理选择策略,以及基于CookieJar的模拟登录流程,帮助开发者突破基础urlopen的功能限制。
本文详细介绍如何使用Python的requests库发送HTTP请求获取网页内容,并结合BeautifulSoup库解析HTML结构。通过百度首页及51job招聘网站两个具体案例,演示了处理编码问题、设置请求头防反爬以及提取特定文本信息的完整流程,帮助开发者掌握基础的网络数据采集技能。
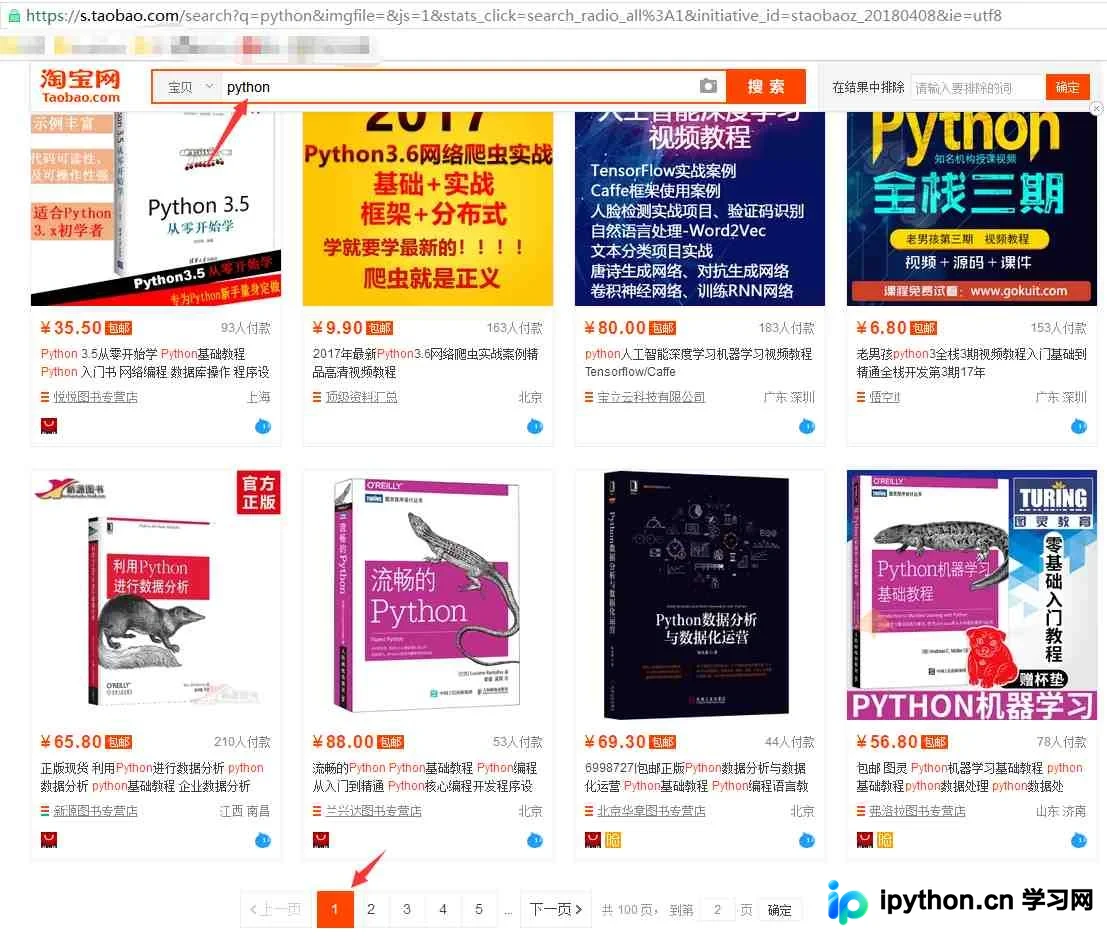
本文详细介绍如何使用Python的requests和re库爬取淘宝商品列表。通过解析URL参数q和s,构建分页请求,利用正则表达式精准提取raw_title和view_price字段。代码示例展示了从获取HTML源码、解析数据到存储结果的完整流程,适合Python初学者学习网络爬虫基础。
本文详解如何利用Python爬取爱奇艺非VIP视频。通过构造搜索URL并分析分页规律,使用requests获取页面源码,结合BS4库解析HTML标签提取视频链接、标题及描述信息。针对作者信息位置不固定的问题,采用try-except机制进行容错处理,确保数据抓取的完整性与稳定性。
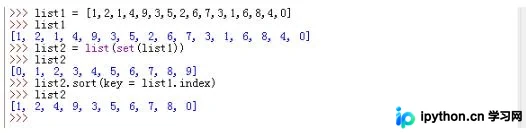
本文介绍如何在Python中对列表进行去重操作,同时保持元素原有的出现顺序。通过结合set集合去重与list.sort方法利用index排序,可解决set默认按值排序的问题。此外,文章还补充了Python爬虫中利用集合实现链接去重的完整代码示例,帮助开发者高效处理数据。
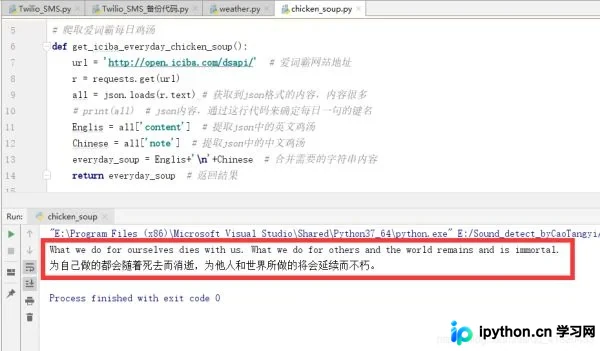
本文介绍如何使用约40行Python代码实现每日一句与天气预报的自动抓取及短信推送。通过调用爱词霸API获取双语名言,利用urllib和BeautifulSoup解析天气网站数据,最终结合第三方接口实现免费短信发送。代码已封装为函数,便于复用,适合Python初学者了解爬虫与自动化办公的基本流程。
本文介绍使用 Python 编写脚本自动获取必应每日高清壁纸的方法。通过 requests 和 re 模块解析网页,指定分辨率并批量下载图片至本地文件夹,支持分页获取,可作为电脑背景自动更新。
本文详解使用 Python requests 模块获取网页源码的标准流程。通过封装 Crawler 类,演示如何自动获取并持久化站点 Cookie,利用 dict_from_cookiejar 转换格式以便后续请求携带。核心方法 get_html_text 实现了通用的爬取框架,包含状态码校验、编码自动识别及异常处理,为构建稳定爬虫提供基础代码参考。
本文详细介绍 Scrapy 框架将数据持久化至 MySQL 数据库的两种核心方式:同步操作与基于 Twisted 的异步存储。文章涵盖 pipelines.py 配置、数据库连接池建立及错误处理机制,并针对中文乱码、特殊字符报错及重复数据累积问题提供具体解决方案,包括使用 pymysql.escape_string 和 scrapy-deltafetch 等插件实现增量爬取。
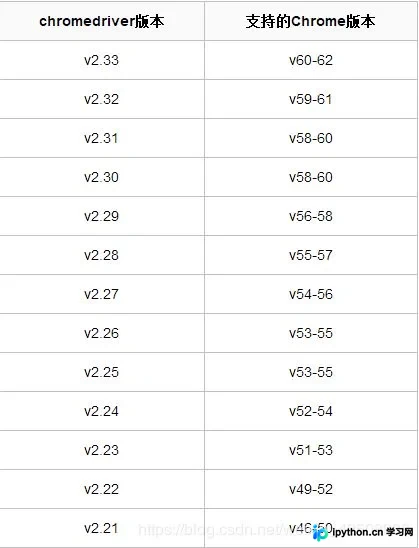
本文详解Selenium自动化测试中ChromeDriver找不到的常见原因及解决方案。重点介绍如何根据浏览器版本下载匹配的驱动,通过配置系统环境变量或直接在代码中指定executable_path路径来解决报错。针对即使配置环境变量仍报“cannot find Chrome binary”的情况,提供了具体的代码级路径指定方法,确保自动化脚本稳定运行。
本文介绍使用Python从HTML页面中提取主要文本框的方法。通过BS4遍历所有div标签,利用正则表达式筛选并统计每个div内的中文字数,最终选取中文内容最长的div作为正文区域。文章提供了完整的requests请求、正则匹配及BeautifulSoup解析代码示例,适用于CSDN等博客类网站的正文抓取场景。